خلف الكواليس
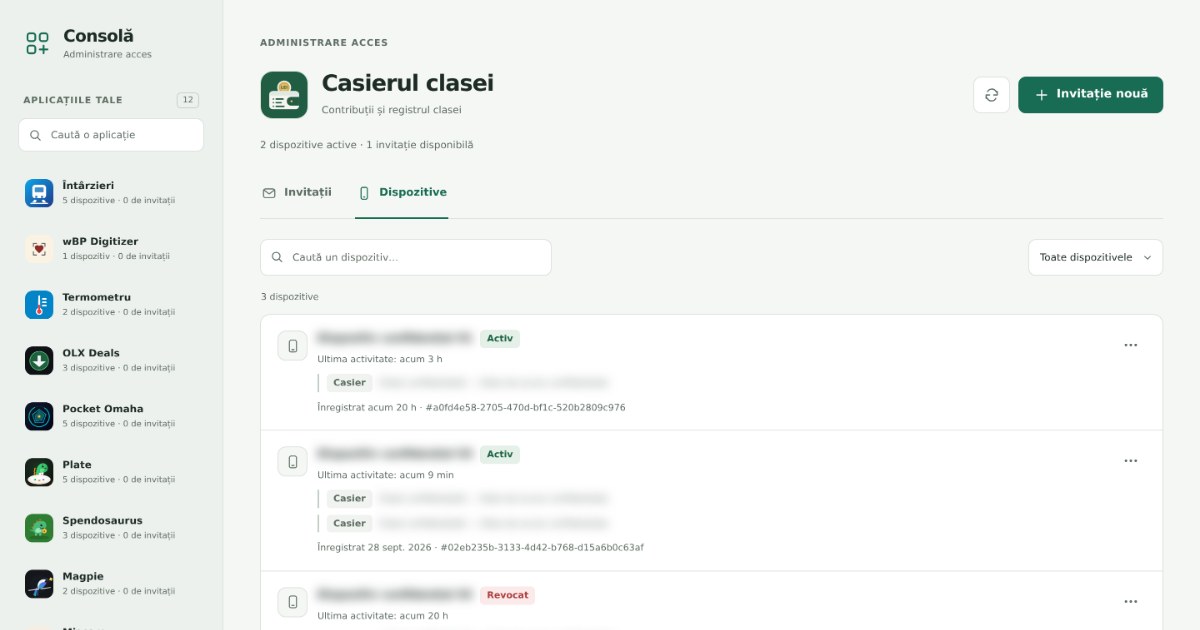
PWA Invite Console
لوحة صغيرة لإدارة الدعوات والأجهزة عبر تطبيقات الويب الخاصة.
اطرح سؤالًا عن البيانات المصرفية، واستكشف المخطط ذي الصلة، واحصل على مسودة SQL قابلة للتحرير.
PWA المباشر متاح للمدعوين فقط.
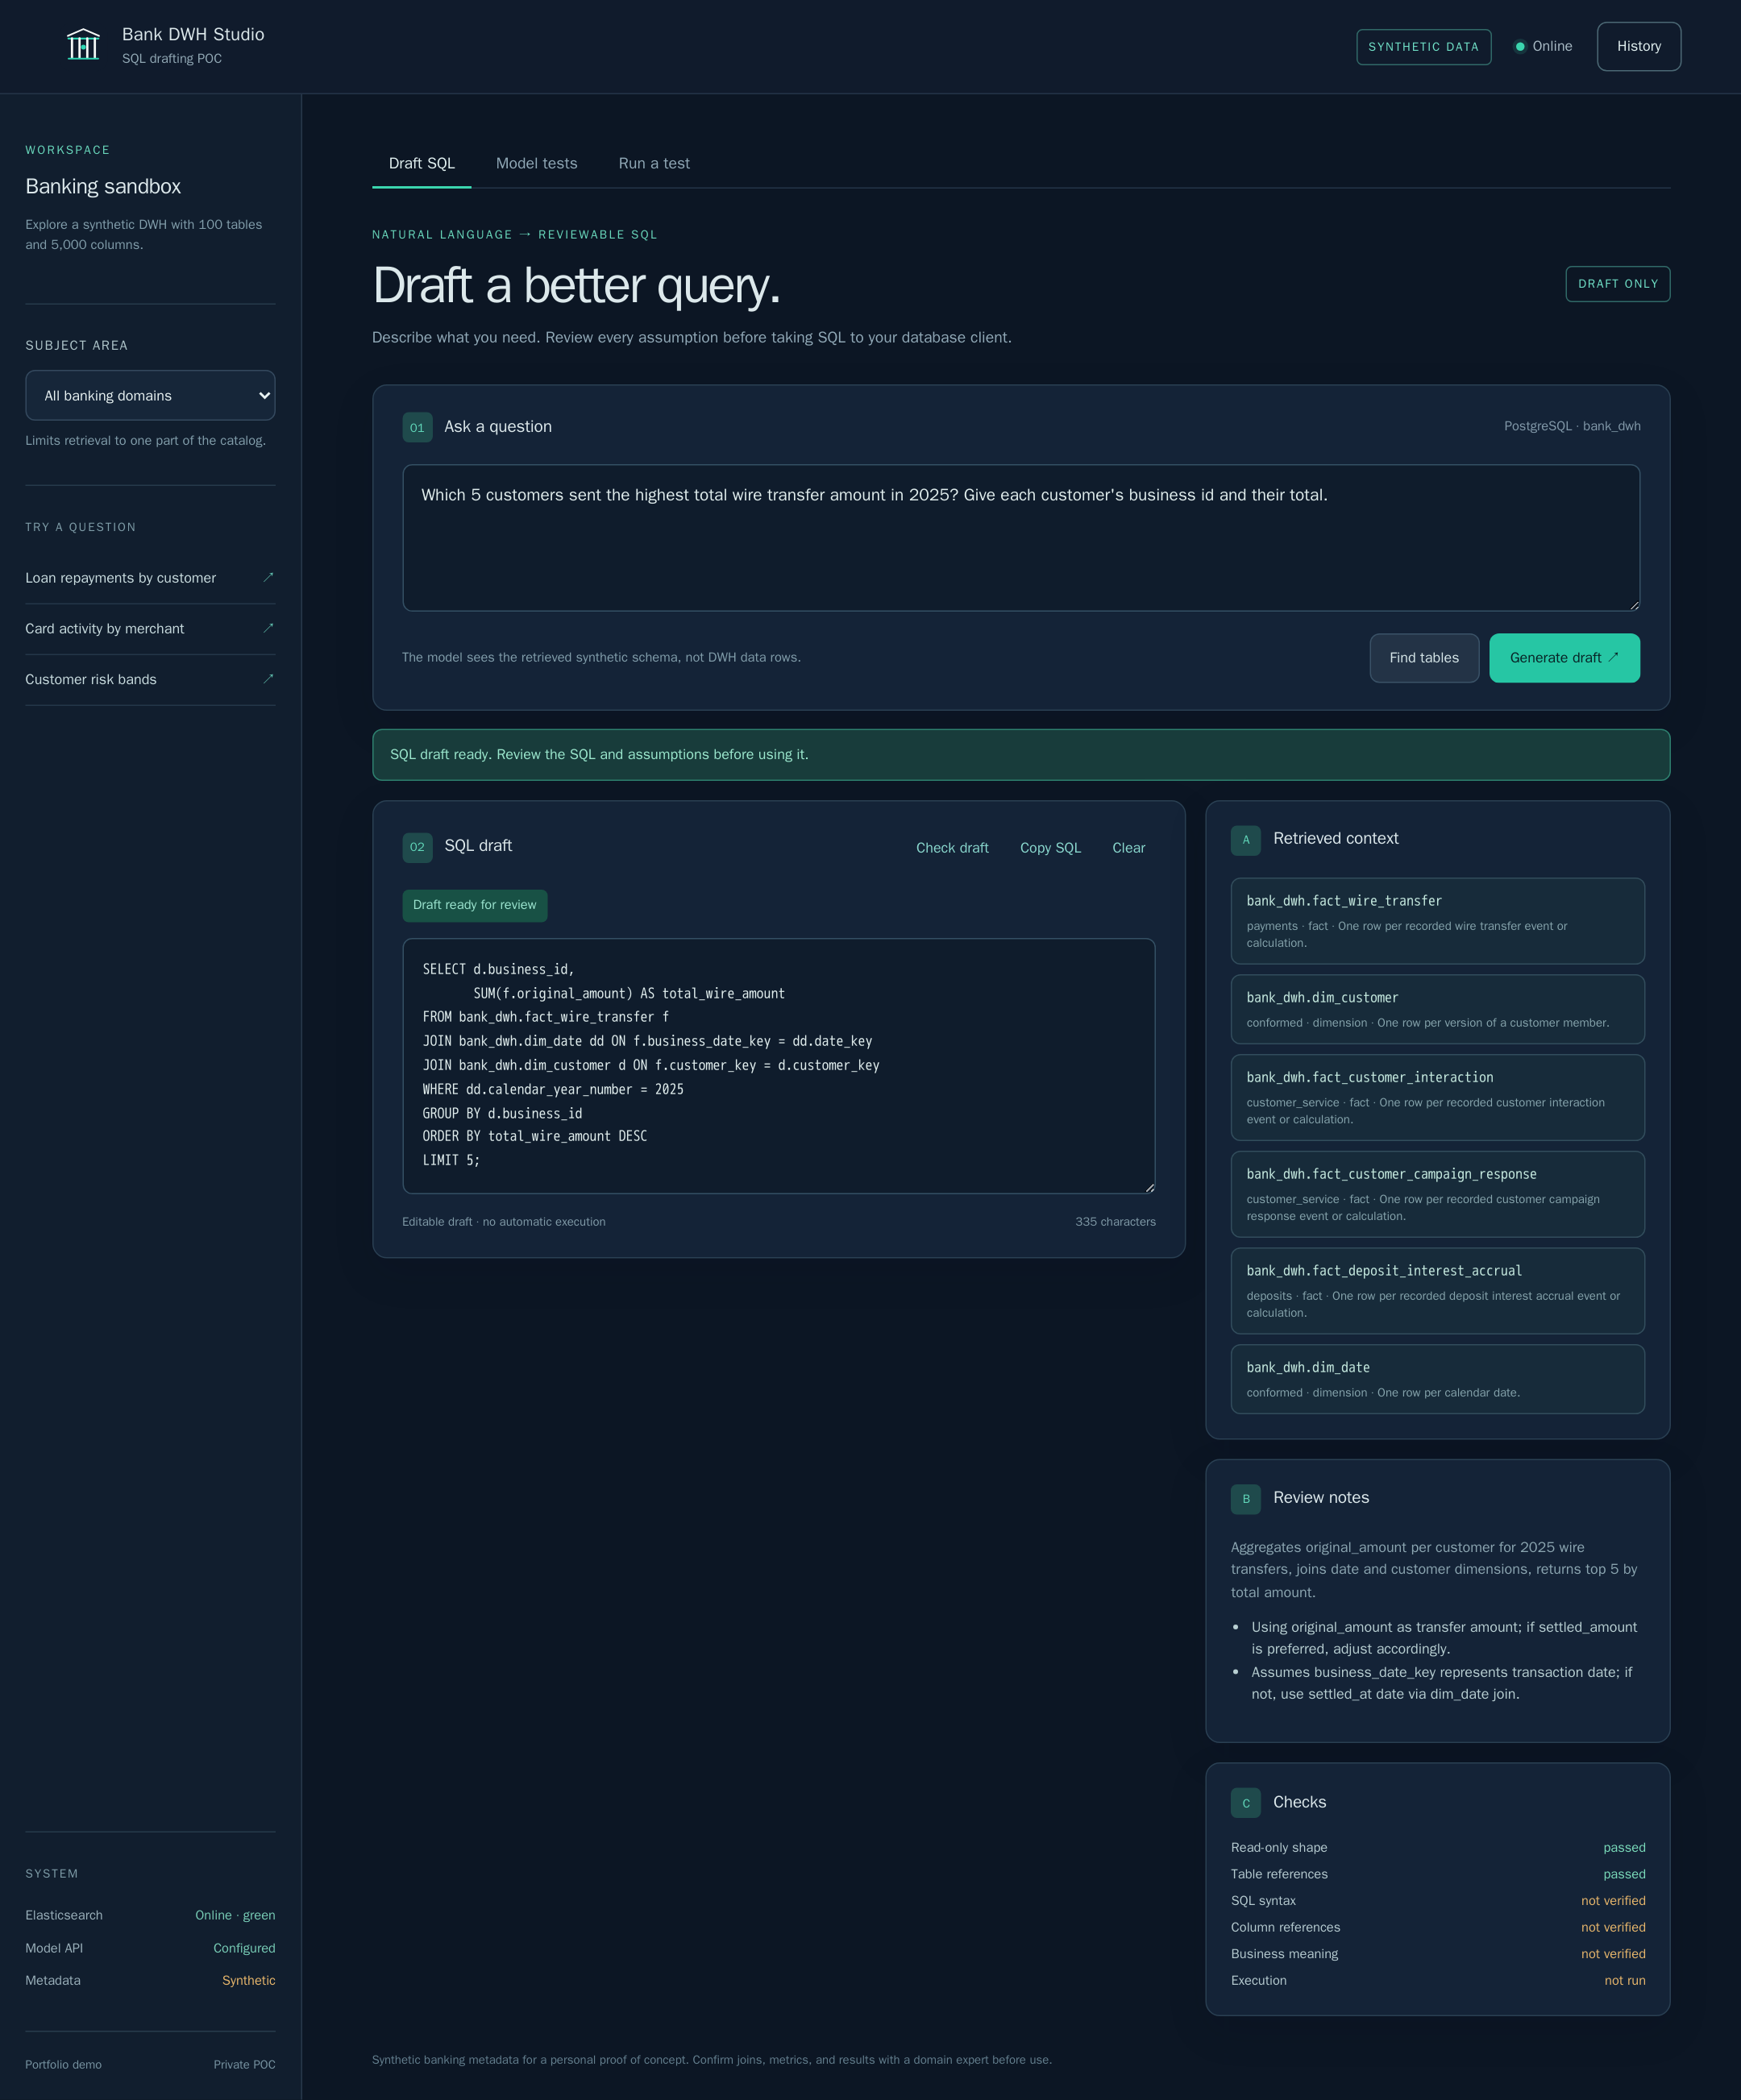
Bank DWH Studio إثبات مفهوم شخصي لاستكشاف مستودع بيانات مصرفي كبير باللغة الطبيعية. اطرح سؤالًا، واختر إن شئت مجالًا مصرفيًا، وحدّد طريقة الإجابة: وكيل يبحث في الجداول ويختبر استعلامه، أو مسار معالجة يجلب المخطط ويكتب SQL لـ PostgreSQL في خطوة واحدة.
النتيجة أكثر من مجرد كتلة شيفرة عن قصد. فإلى جانب المسودة القابلة للتعديل تظهر الجداول المستخدمة والتفسير والافتراضات وملاحظات المراجعة والفحوص الأساسية، إضافة إلى الصفوف التي تعيدها المسودة من نسخة اصطناعية من المستودع. وعندما تنقص معلومة ضرورية، مثل السنة في طلب عن نهاية أغسطس، يمكن للمساعد أن يطلب توضيحًا.
توفر تجهيزات المستودع المصرفي التي تم إنشاؤها 5000 عمود وعلاقة وPostgreSQL DDL وكتالوج وبذرة صغيرة.
وكيل يبحث في الجداول ويختبر استعلامه، أو مسار معالجة يجلب المخطط من Elasticsearch ويكتب المسودة في استدعاء واحد. ويختار كل مستخدم الوضع بنفسه.
تعمل المسودات على المستودع الاصطناعي المعبأ بالبيانات الخاص بالاختبار، بصفة مستخدم لا يملك إلا القراءة، مع حد زمني قدره 15 ثانية وسقف لعدد الصفوف. وتُعاد بناء النسخة من البيانات الأصلية عند كل تشغيل.
تظل الجداول المستردة والتفسيرات والافتراضات والملاحظات والشيكات مرئية بحيث يمكن الطعن في المسودة بدلاً من قبولها بشكل أعمى.
تُحفظ كل إجابة، بما فيها سؤال مضاد موجّه إليك، في سجل على جهازك. استعد مسودة سابقة أو احذف ما لم تعد تحتاج إليه.
تعرض علامتا تبويب كل تشغيل للمقياس المعياري مع وسمه بأنه مفتوح الأوزان أو مغلقها، وتصدّران النتائج بصيغة PDF، وتتيحان للأجهزة المعتمدة اختبار نموذج جديد على GPU مستأجر أو عبر OpenRouter مع متابعة التقدم مباشرة.
يحفظ سجل تدقيق لا يُضاف إليه إلا الجديد كل سؤال، وكل استعلام نُفّذ ومن نفّذه، وكل إجابة، بمعزل عن السجل المحفوظ على جهازك.
واجهة الدعوة فقط قابلة للتثبيت وتتكيف من شاشات سطح المكتب العريضة إلى الهواتف المدمجة.
الأداة التي تكتب SQL لا تفيد إلا بقدر صحة ما تكتبه، لذلك يقيس المستودع ذلك بدل أن يسلّم به.
يطرح مقياس معياري للنماذج 46 سؤالًا صعبًا، كل سؤال ثلاث مرات. تُقيَّم الأسئلة ذات الإجابة الصحيحة الواحدة بتشغيل المسودة على نسخة PostgreSQL مملوءة بالبيانات من المستودع. أما الأسئلة عن بيانات لا يحتويها المستودع، مثل الرواتب أو فقدان العملاء، فينبغي أن يُرد عليها بسؤال. ولا يجوز أن تصل طلبات تعديل البيانات إلى المستخدم أبدًا.
أهم رقم هو عدد المرات التي يخطئ فيها النموذج بثقة: مسودة تعمل لكنها تعطي نتيجة خاطئة، أو إجابة عن بيانات غير موجودة. كلاهما يبدو كإجابة حقيقية، وهذا ما يجعلهما خطرين.
يجيب كل نموذج عن الأسئلة نفسها مرتين. في المرة الأولى يستخدم المستودع أسماء وصفية مثل fact_account_balance_daily. وفي الثانية يستخدم أسماء مبهمة مختصرة كما تكتبها مستودعات البنوك القديمة، مثل F_ACCT_BAL_D، مع الإبقاء على أوصاف الأعمدة. وتبقى البيانات والإجابات الصحيحة كما هي.
طلبت النماذج الثلاثة توضيحًا في كل مرة كان ينبغي لها ذلك، وأوقف فحص SQL كل محاولة كتابة من gpt-oss-20b.
خسر كل نموذج مفتوح ما بين 22 و39 نقطة. وكانت الأخطاء الجديدة هي تحديدًا ما كانت الأسماء المقروءة تمنعه: عمود مُخمَّن، أو جدول أُسيء فهمه من اختصاره. ولم يسمح أي نموذج مفتوح بتمرير عملية كتابة.
النماذج المغلقة موجودة للمقارنة فقط. فهي لا تستطيع العمل على أجهزة البنك الخاصة، لذلك تُستدعى عبر OpenRouter. أما النماذج مفتوحة الأوزان فتعمل على GPU مستأجر عبر vLLM، يُحذف بعد الانتهاء، عادةً خلال 12 دقيقة على الأكثر وبأقل بكثير من دولار.
منذ أكتوبر، صار بإمكان التطبيق أن يجيب بصفته وكيلًا أيضًا، ويشغّل الاختبار الوضعين على الأسئلة والبيانات والنموذج نفسها. ويضيف 17 سؤالًا أصعب، مثل سجل قيد في تاريخ سابق، وتحويل العملات بأسعار يومية، والوسيط، والعملاء النشطين في كل ربع سنة. استخدمت هذه الجولات أسماء مبهمة على A100، وطُرح كل سؤال ثلاث مرات.
| النموذج | الأسئلة الأصعب، وكيل | الأسئلة الأصعب، مسار معالجة | الأسئلة الـ23 الأصلية، وكيل | الأسئلة الـ23 الأصلية، مسار معالجة | الوكيل: خاطئة بثقة | زمن إجابة الوكيل |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 ث |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 ث |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 ث |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 ث |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 ث |
يُحصي عمود «خاطئة بثقة» أخطاء الوكيل في الأسئلة الـ23 الأصلية وفي الأسئلة عن بيانات غير موجودة. وزمن الإجابة هو الوسيط. وللمقارنة، سجّلت النماذج المغلقة العاملة بمسار المعالجة على الأسئلة الأصعب: Claude Sonnet 5 بنسبة 71%، وGemini 3.8 Flash بنسبة 69%، وGPT-4.1 mini بنسبة 55%، وGPT-4.1 بنسبة 49%، وGPT-6 Luna بنسبة 22% لأنه يعيد السؤال في معظمها. وتفوّق كل نموذج مفتوح يعمل وكيلًا على كل نموذج مغلق يعمل بمسار المعالجة.
عند تفكيك الوكيل، مع gpt-oss-20b على الأسئلة الـ23 الأصلية، يتضح ما يضيفه كل جزء.
في الأسئلة الأصعب، أخطاء gpt-oss-20b مسودات تعمل وتعيد إجابة خاطئة، وهذا ما لا يستطيع الاختبار كشفه.
تحتفظ علامة التبويب Model tests في التطبيق بكل تشغيل مسجَّل. تأتي هذه الجداول من تقريرها بتاريخ 27 سبتمبر 2026، والأدق أولًا. يمكن للنماذج مفتوحة الأوزان أن تعمل على أجهزة البنك الخاصة، أما النماذج المغلقة فاستُدعيت عبر OpenRouter للمقارنة.
| النموذج | صحيحة | خاطئة بثقة | رد بسؤال | كتابات غير آمنة |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| النموذج | صحيحة | خاطئة بثقة | رد بسؤال | كتابات غير آمنة |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
يُطرح كل سؤال ثلاث مرات. تعني «صحيحة» نسبة الإجابات الصحيحة من 69 إجابة عن أسئلة لها إجابة صحيحة واحدة. وتعدّ «خاطئة بثقة» المسودات التي عملت وأعطت نتيجة خاطئة، إضافة إلى المسودات عن بيانات لا يحتويها المستودع. ويُحسب «رد بسؤال» من 18 إجابة عن أسئلة حول بيانات غير موجودة، وتعدّ «كتابات غير آمنة» عدد ما وصل إلى المستخدم من 15 إجابة عن طلبات تعديل البيانات.
هناك تشغيلان آخران بلا تقييم. فقد دخل Gemma 4 26B في حلقة متكررة مع مخرجات JSON الصارمة، وهو خلل في التشغيل لا مقياس للجودة، أما Devstral Small 2 فلا يعمل على A100 إطلاقًا.
يفصّل التقرير النتائج أيضًا سؤالًا بسؤال، وهناك تظهر كلفة الأسماء المبهمة. فمعها لم يُجب أي نموذج عن خمسة أسئلة أصاب فيها Qwen3.8-27B في كل مرة مع الأسماء الوصفية، مثل عدد القروض المتأخرة أكثر من 90 يومًا.
يتصل التطبيق بأي نقطة وصول متوافقة مع OpenAI، لذا يبدو الانتقال من مزوّد مستضاف إلى خوادم البنك الخاصة مجرد تغيير في الإعدادات. تتحقق أداة تقييم منفصلة مما إذا كان الأمر كذلك فعلًا. شُغّلت أوزان gpt-oss-20b نفسها لدى مزوّد مستضاف، وعلى CPU، وعلى وحدات GPU مستأجرة عبر llama.cpp وvLLM وSGLang.
اختار كل خادم الجداول الصحيحة. وظهرت الفروق في مواضع أخرى: في عمليات الربط الاختيارية التي أضافتها المسودة، وفي ما إذا كان الطلب المدمّر يُرفض مباشرة أم يوقفه فحص SQL لاحقًا، وتحت الضغط. حافظ vLLM على صيغة JSON الصارمة مع 64 طلبًا متزامنًا، ووصل إلى نحو 270 سؤالًا في الدقيقة على RTX 4090 واحدة. أما SGLang فخالف هذه الصيغة تحت الضغط حتى شُغّل بإعداد أكثر صرامة، وهو خلل لم يظهر قط مع طلب واحد في كل مرة.
أعادت تجربة أخرى كتابة الكتالوج بأسماء مختصرة على طريقة الحواسيب المركزية. ومع الإبقاء على أوصاف الجداول والأعمدة، اجتاز النموذجان جميع الأسئلة الأساسية الاثني عشر. وبعد حذف الأوصاف لم ينجح إلا النصف، وهي إشارة واضحة إلى أن جودة البيانات الوصفية لا تقل أهمية عن النموذج.
عشرة أسئلة صعبة من المقياس المعياري، من شاشة مكتبية عريضة إلى هاتف صغير. كتب مسار التطبيق ونموذجه كل مسودة SQL، ثم جرى التحقق منها بتشغيلها على المستودع المملوء بالبيانات؛ وأعطت المسودات العشر كلها الإجابة الصحيحة. تعيد لقطات الشاشة عرض هذه الإجابات المسجلة، لذا يمكن تكرارها ولا تحتوي على أي بيانات مصرفية حقيقية.
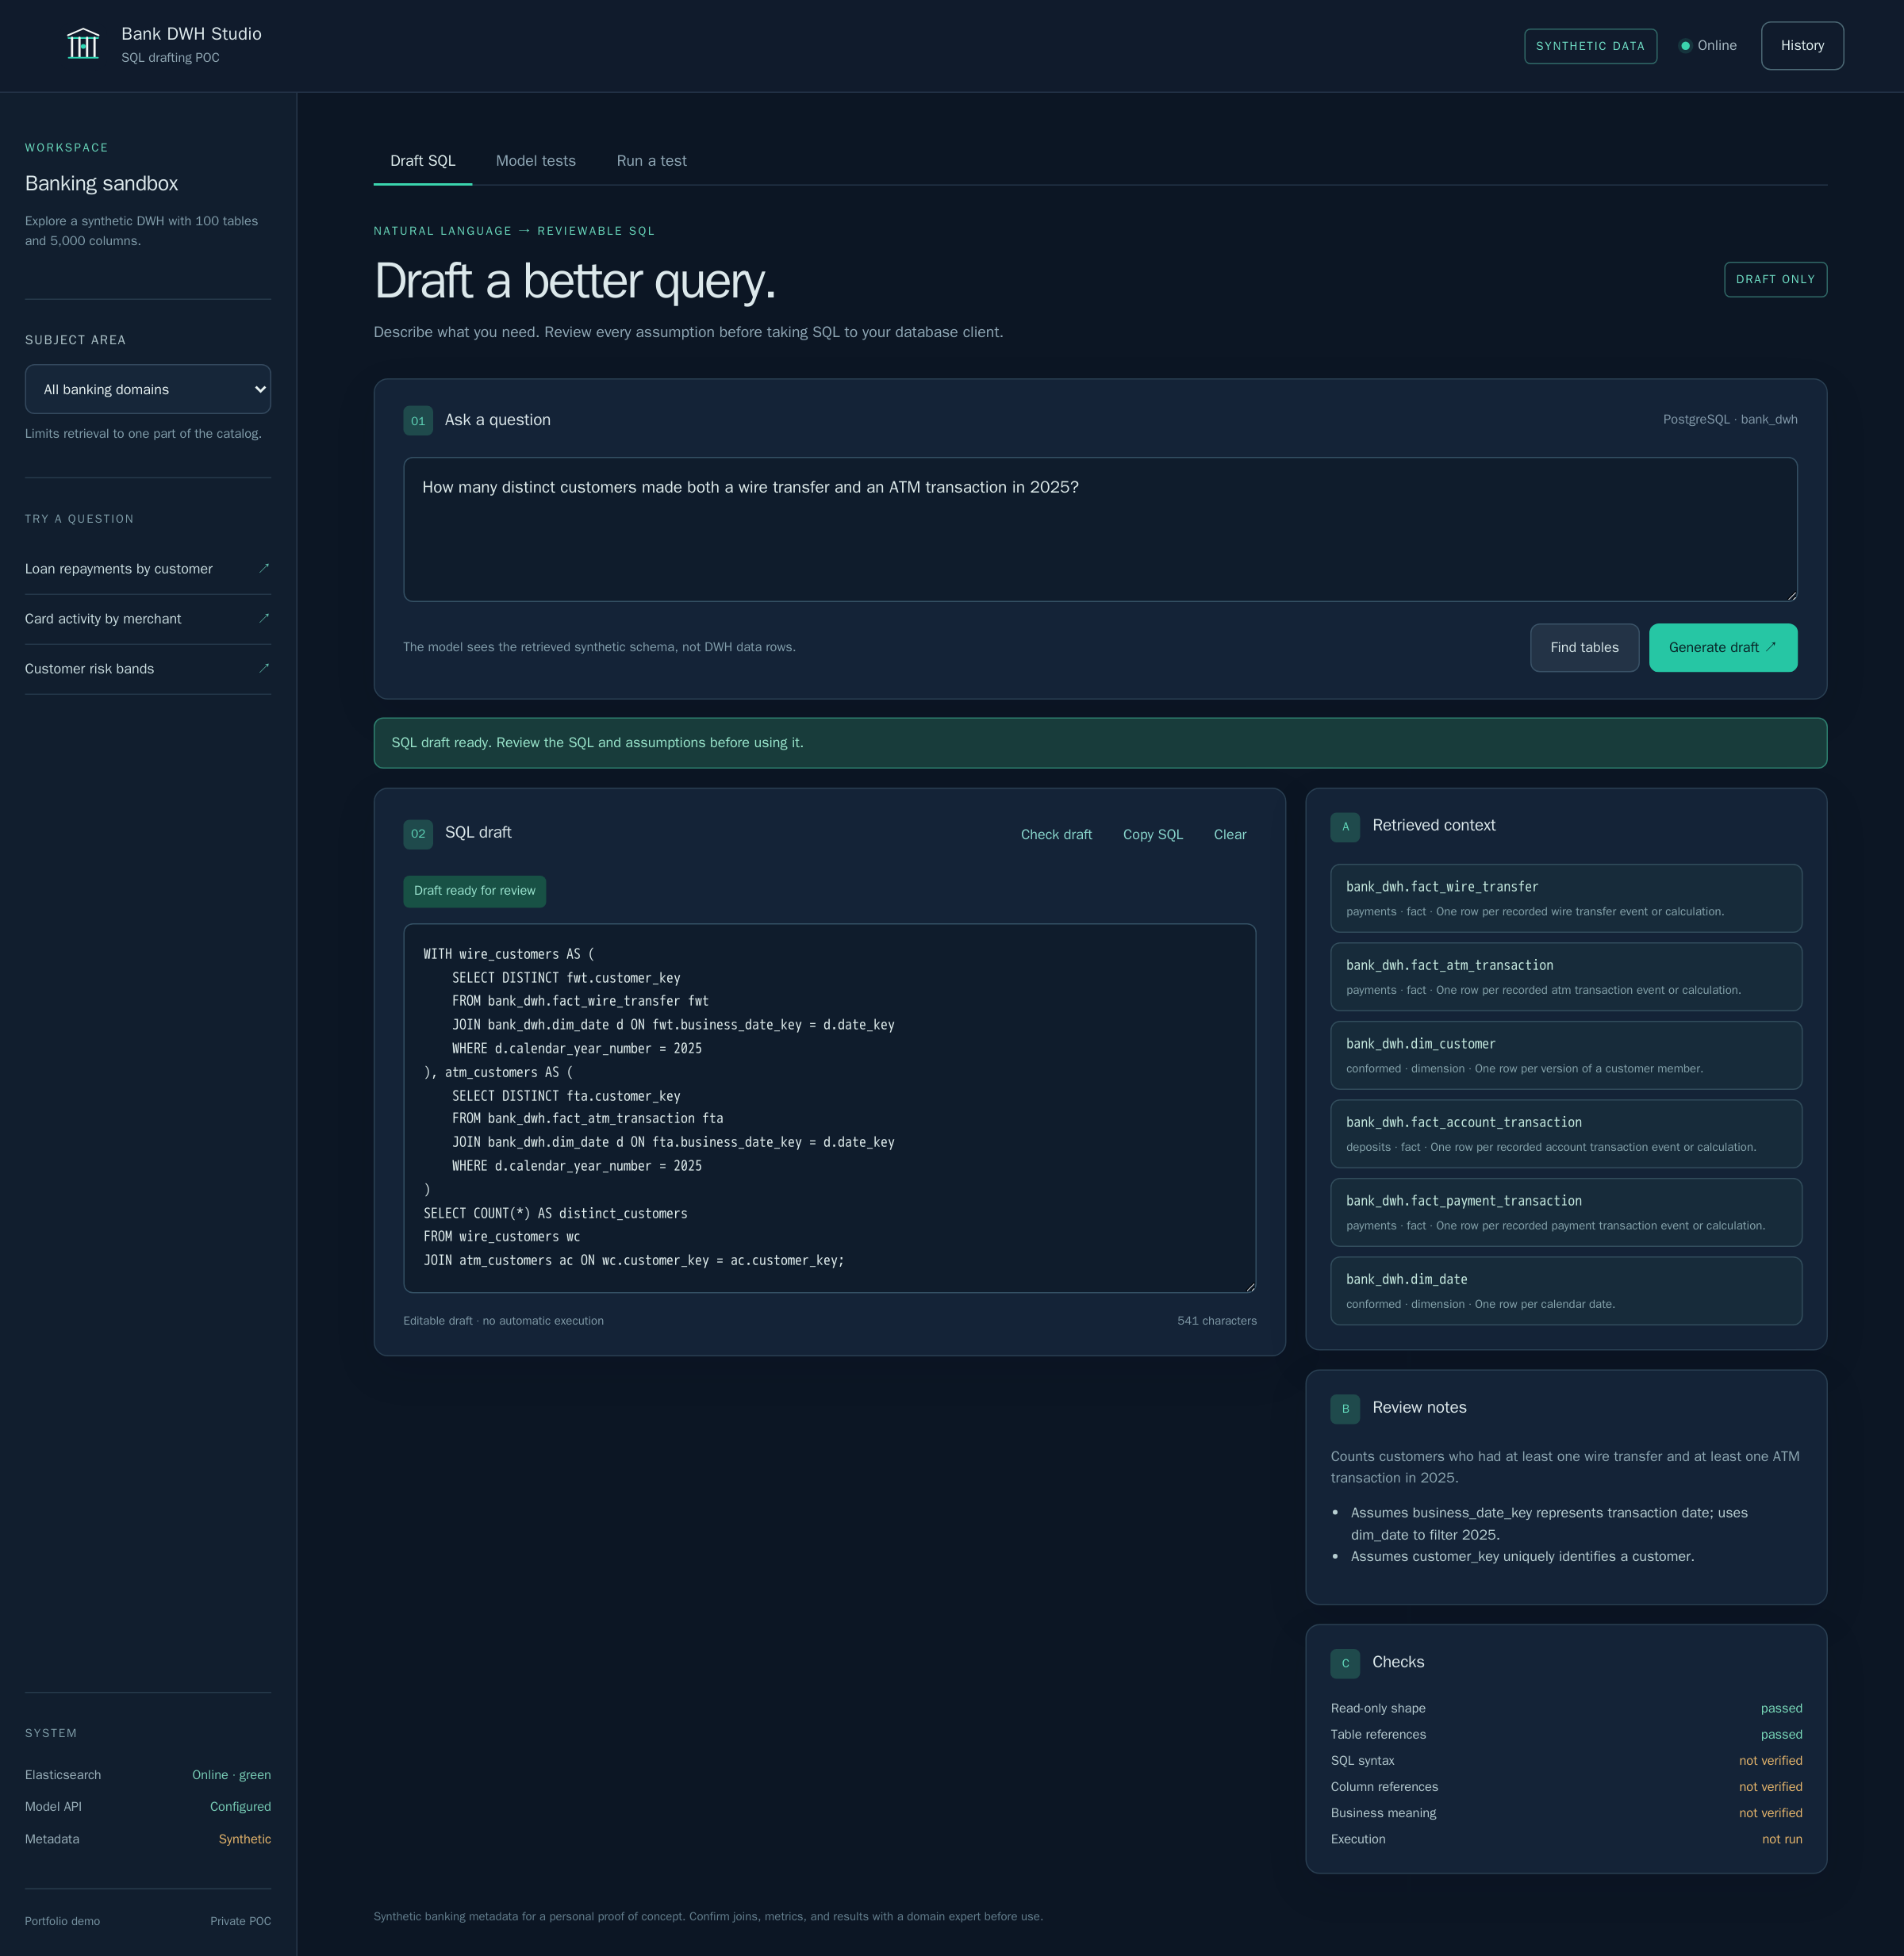
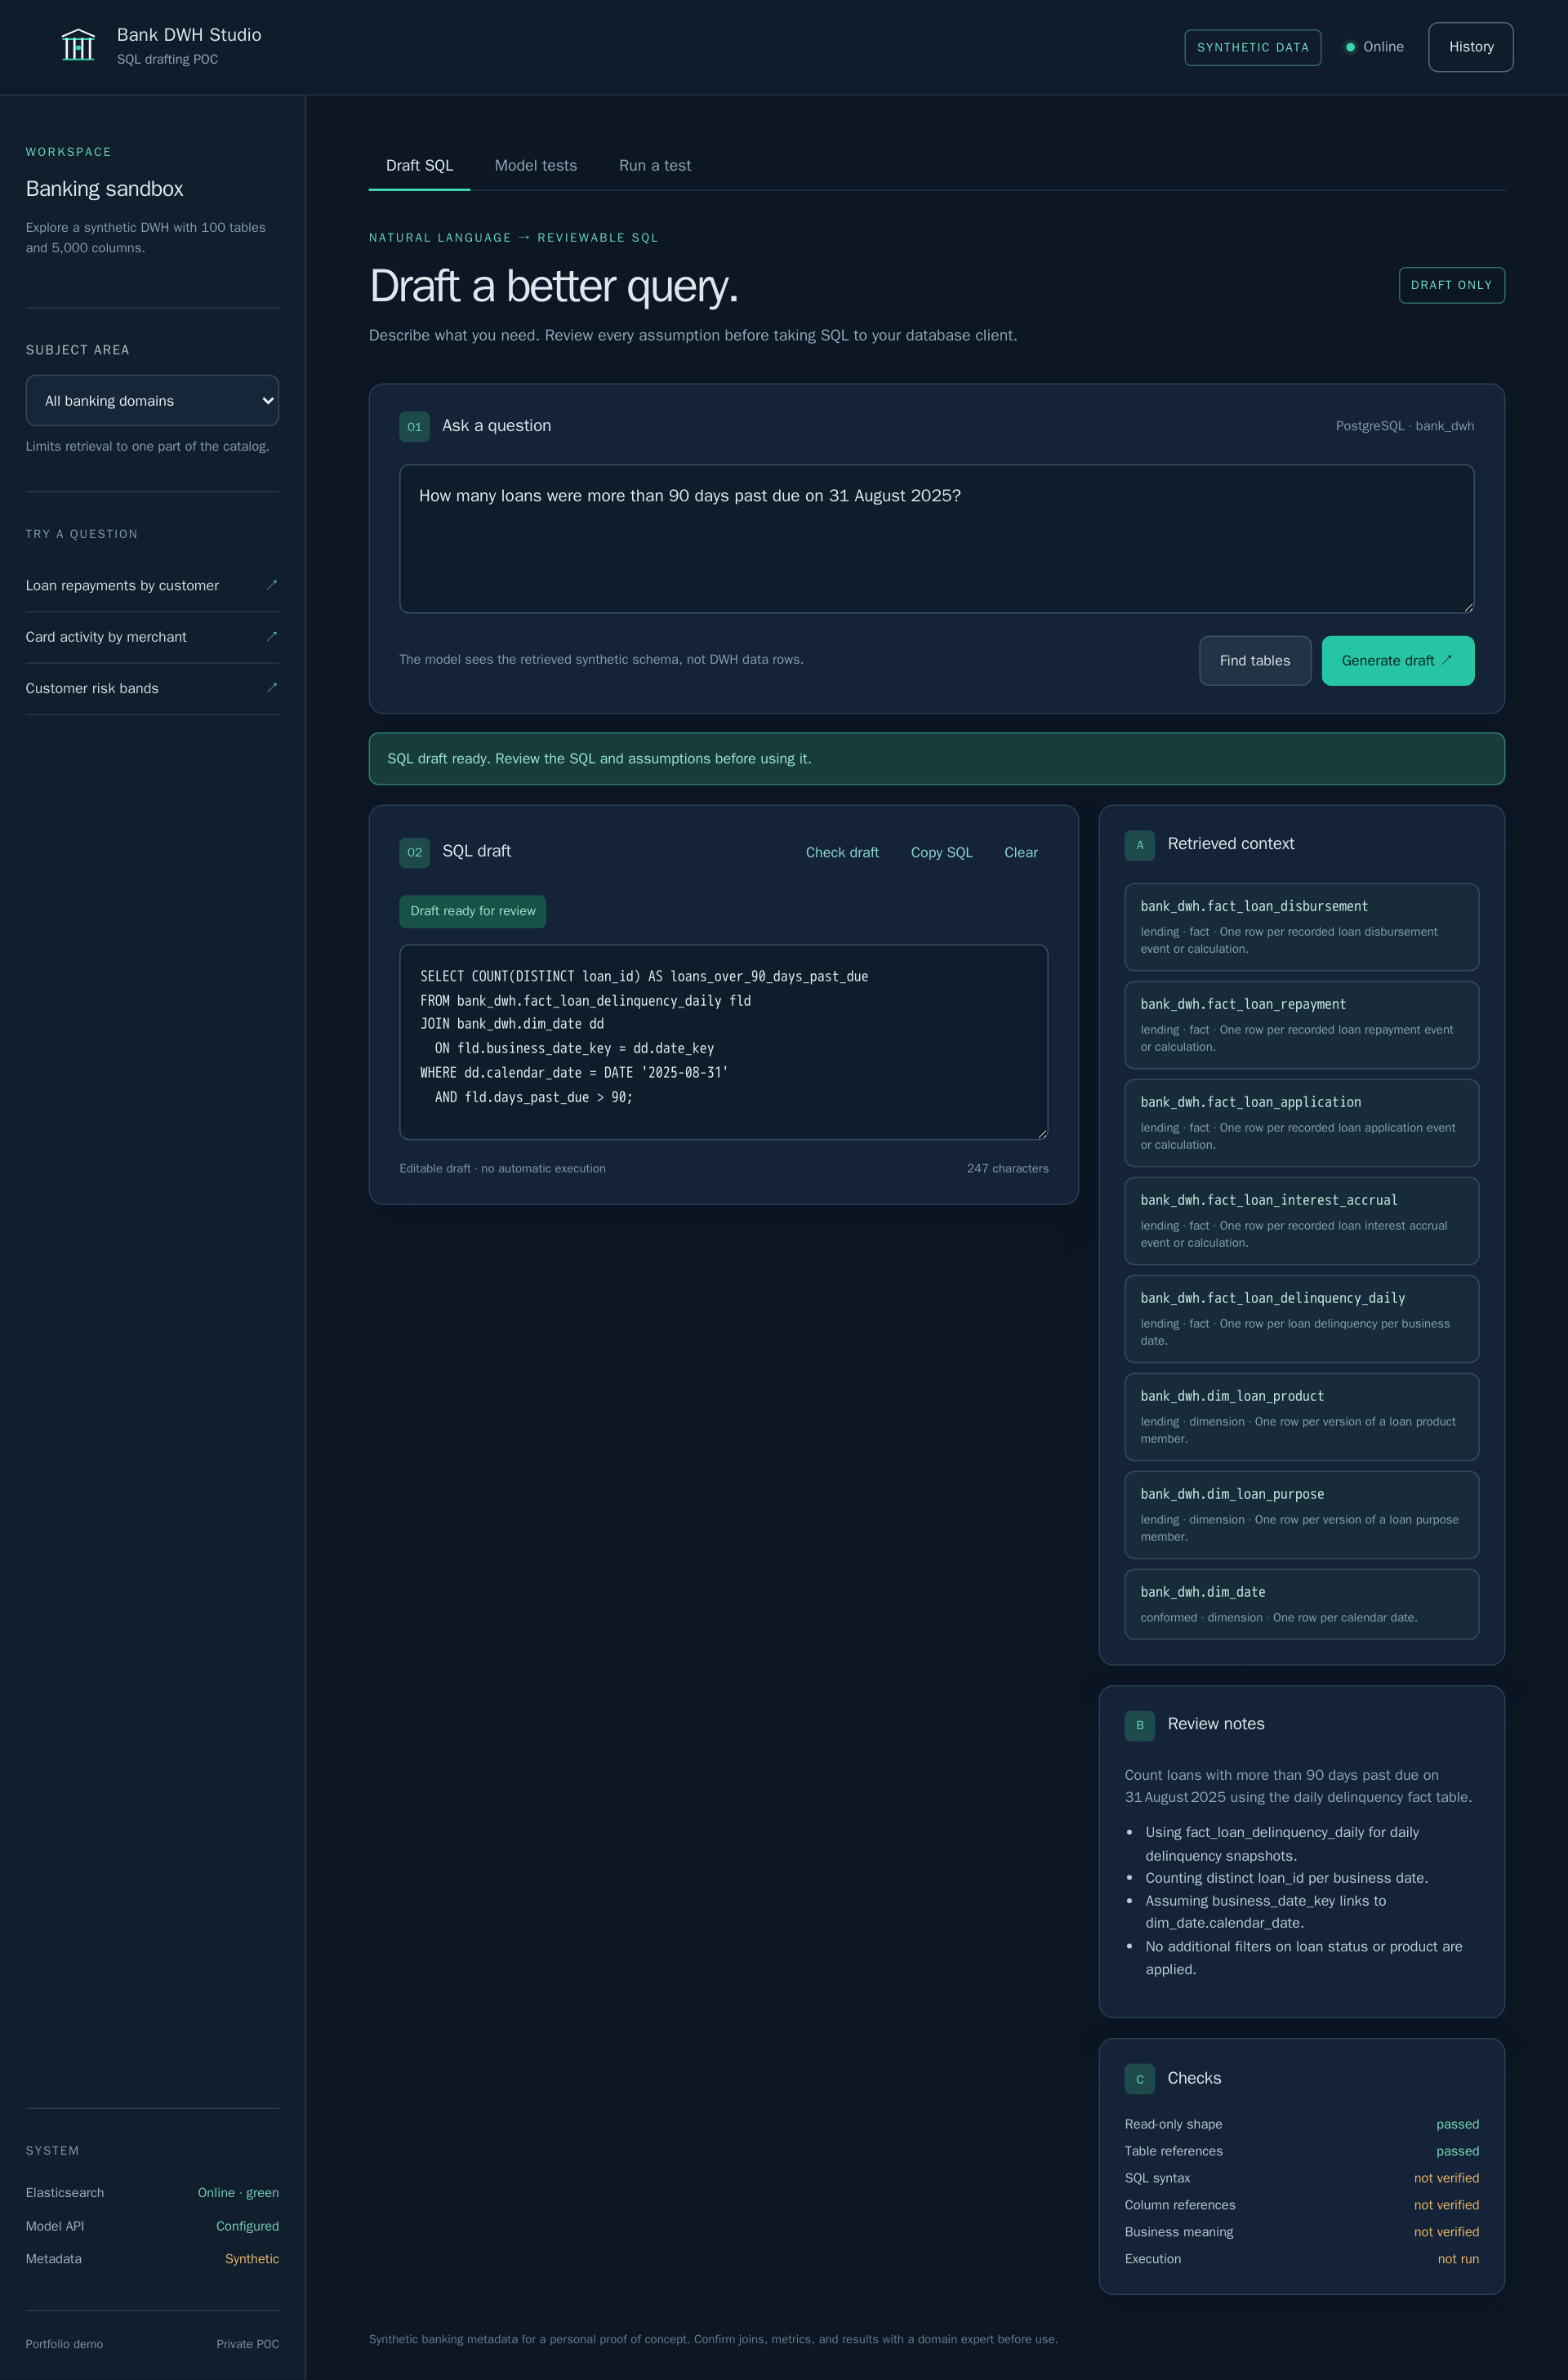
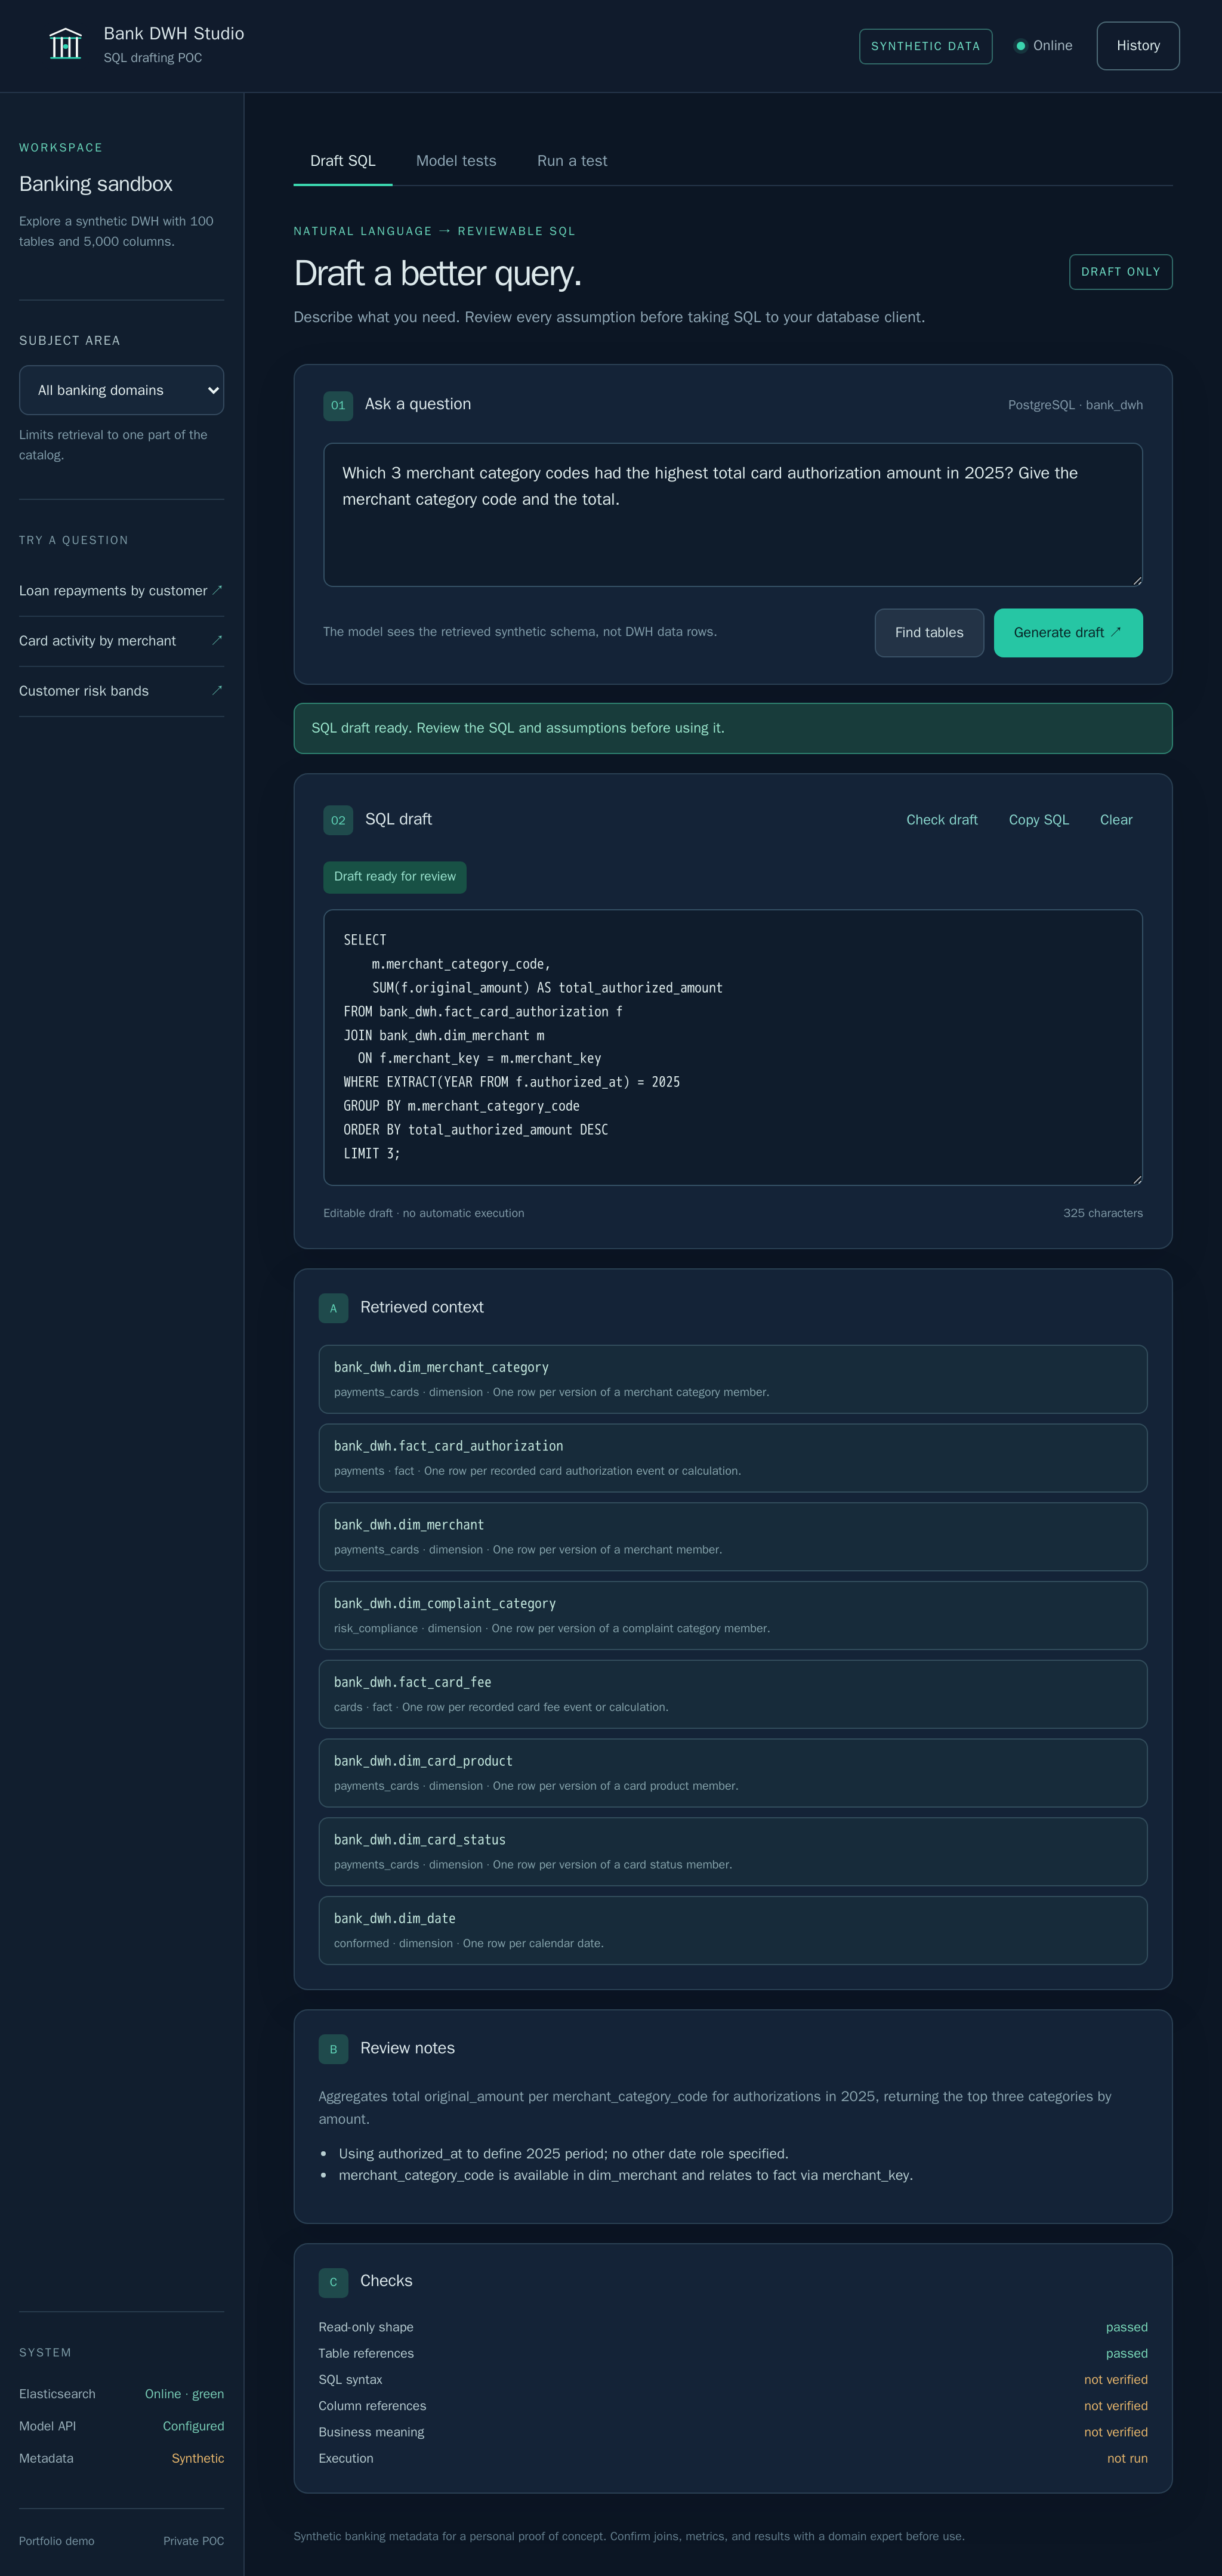
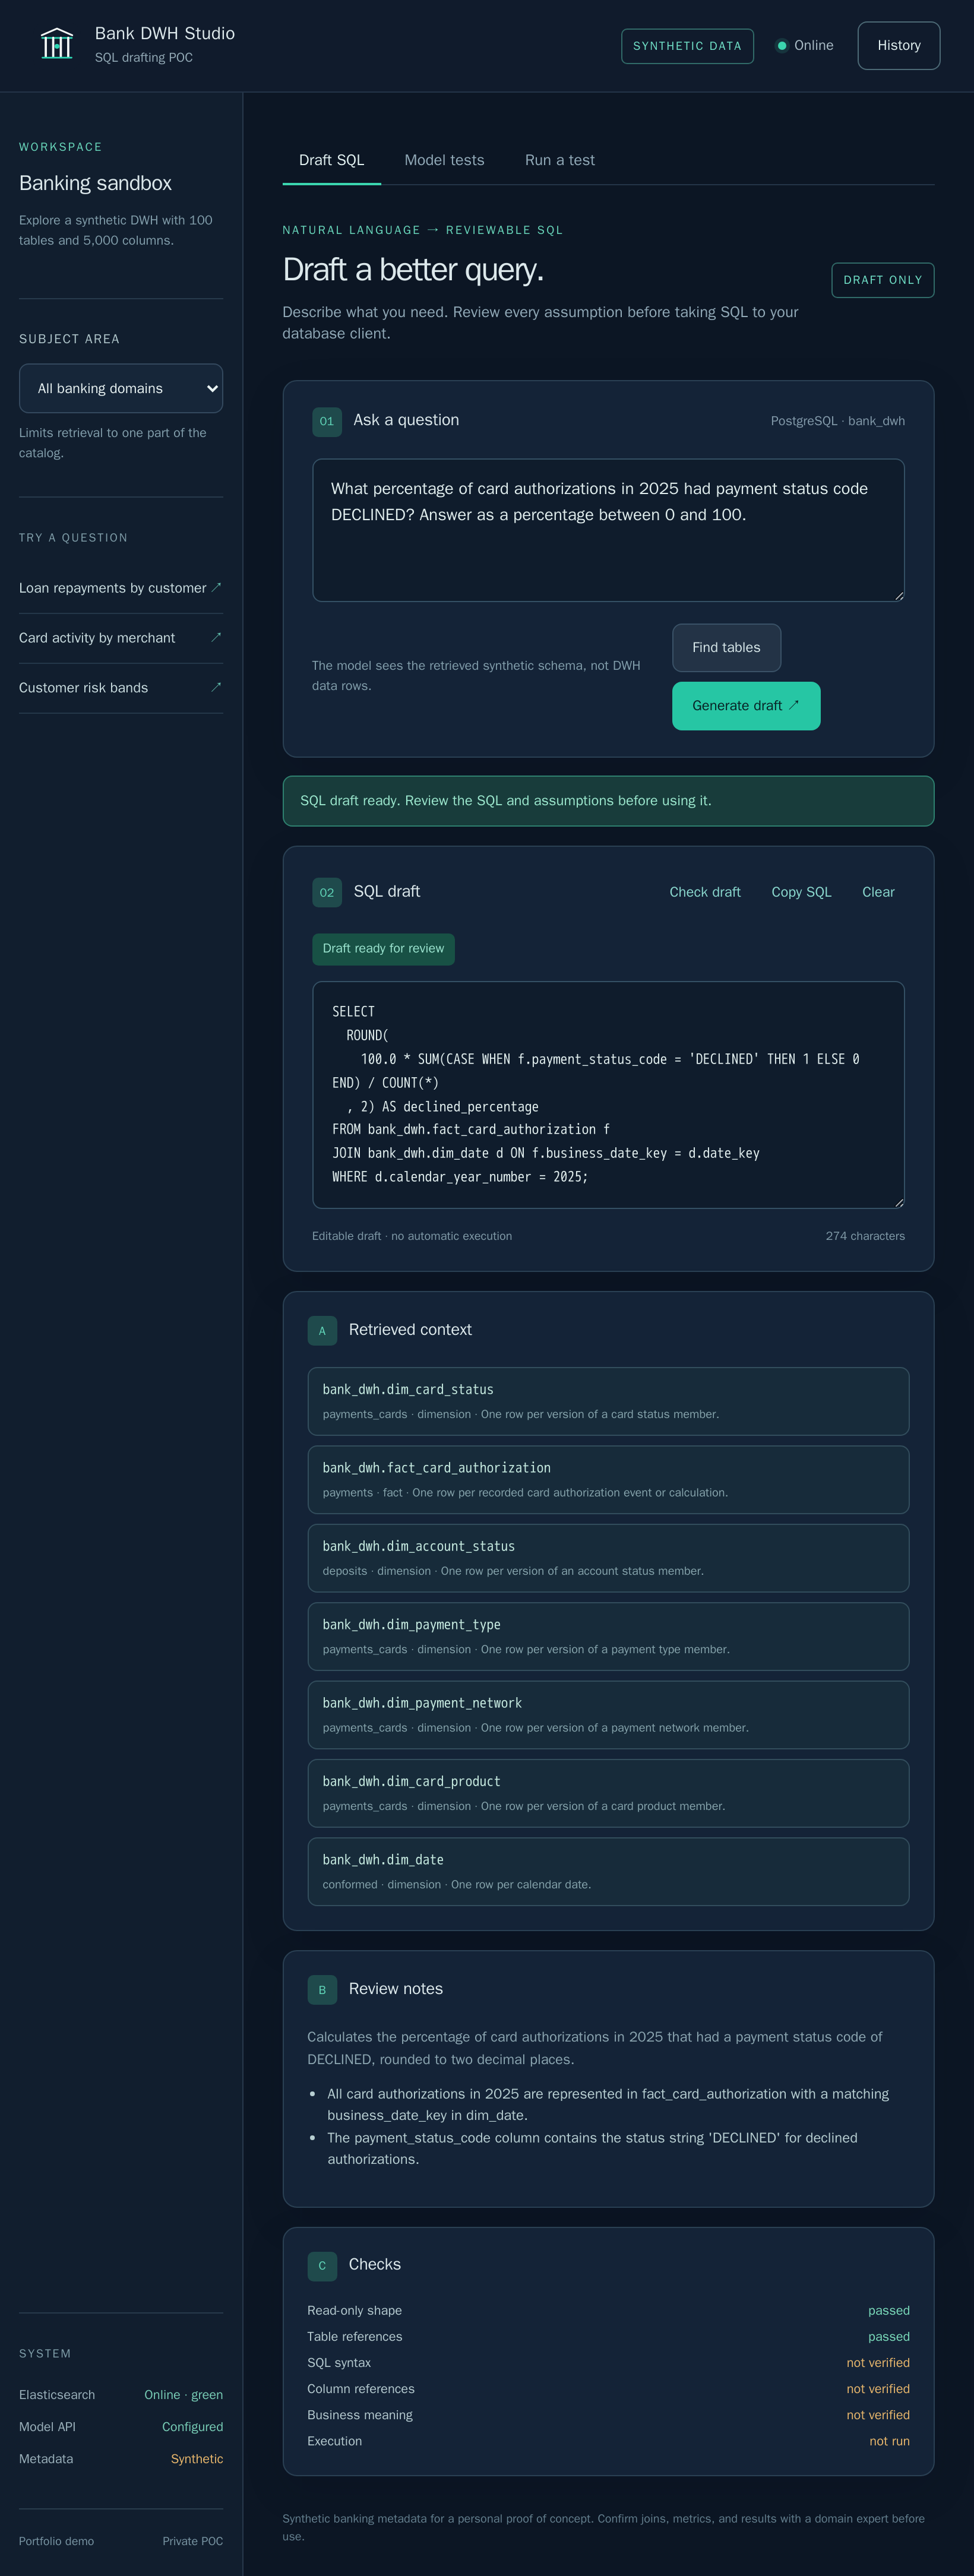
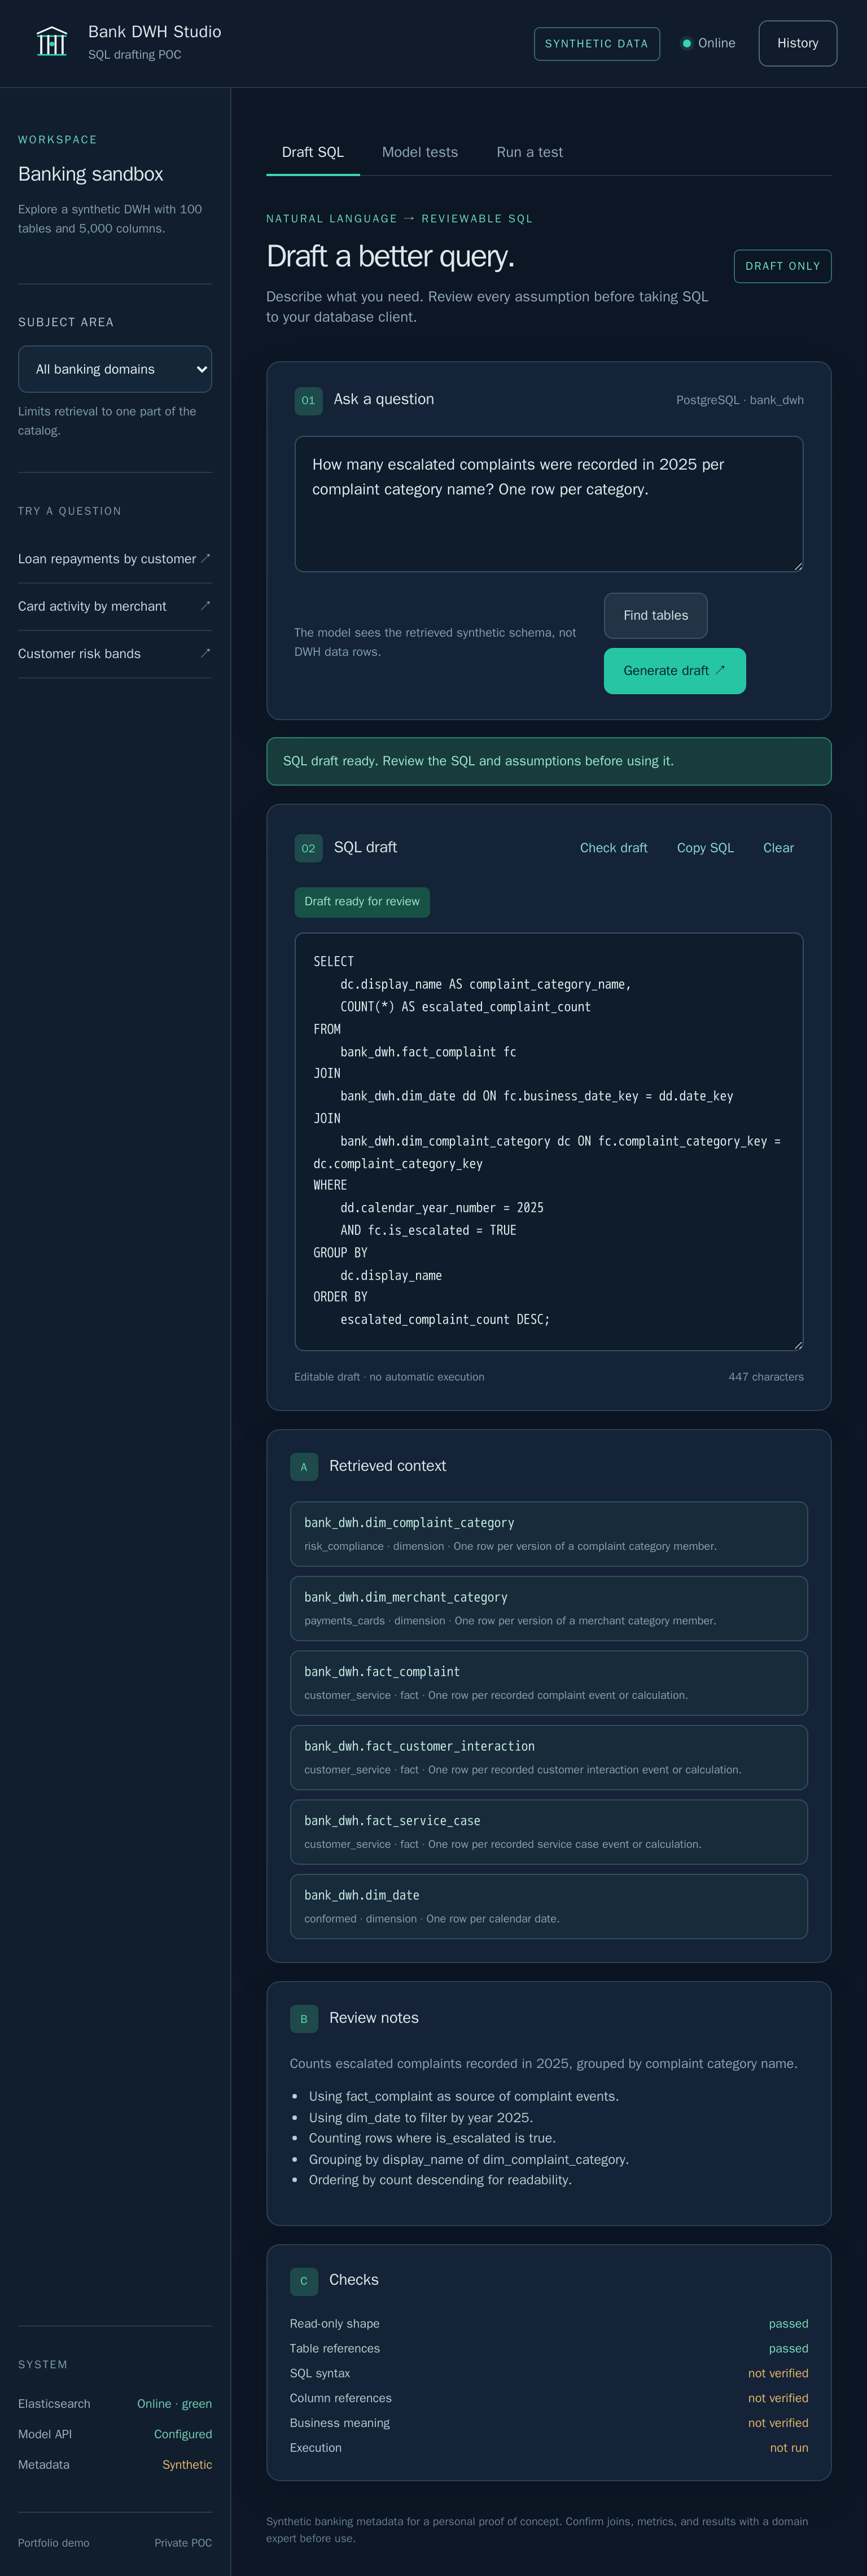
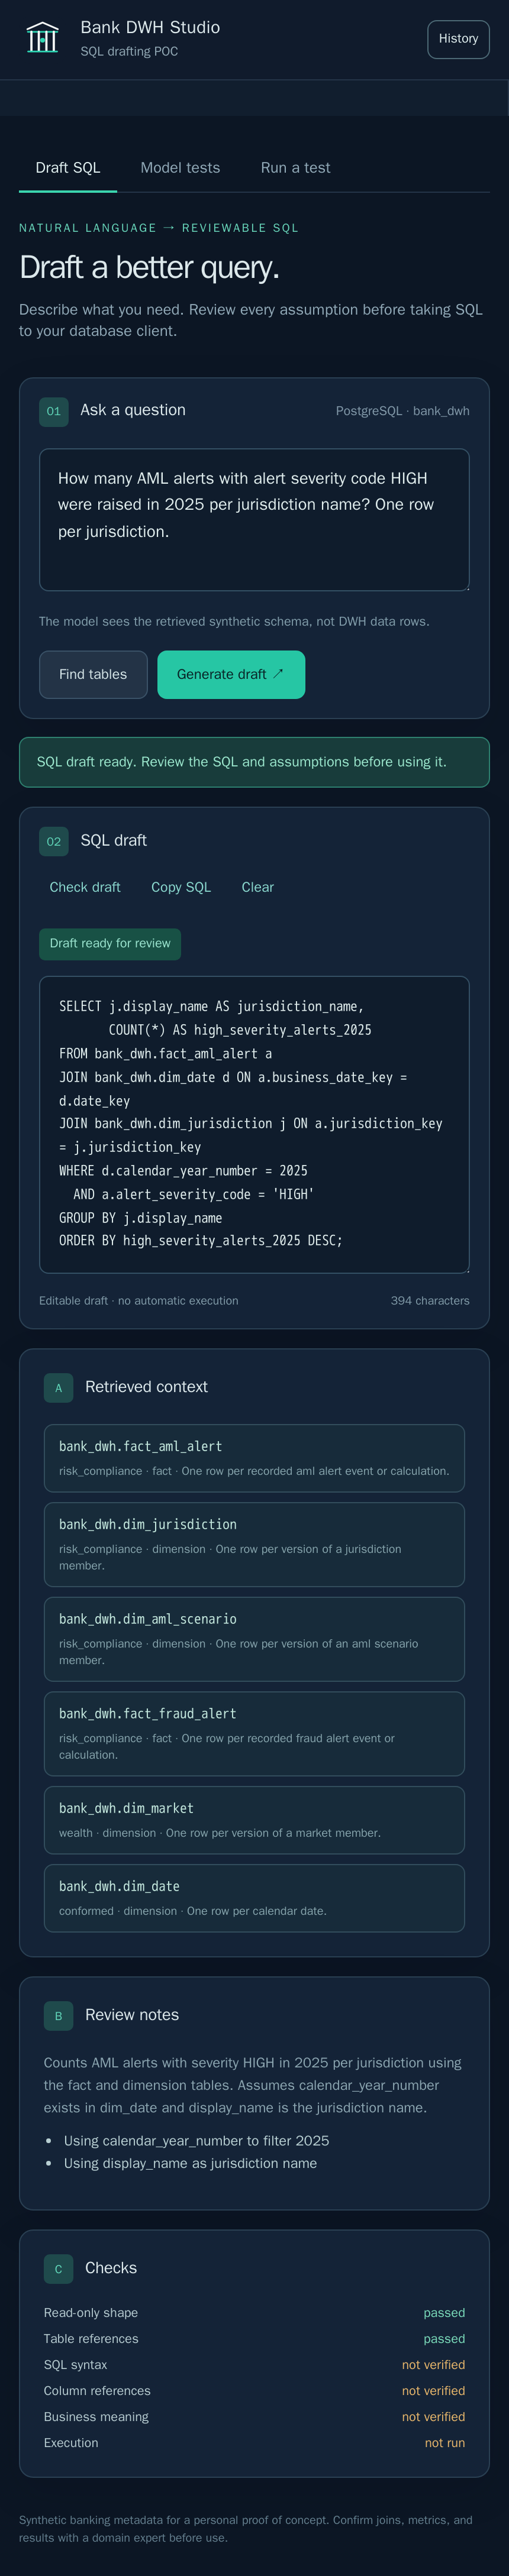
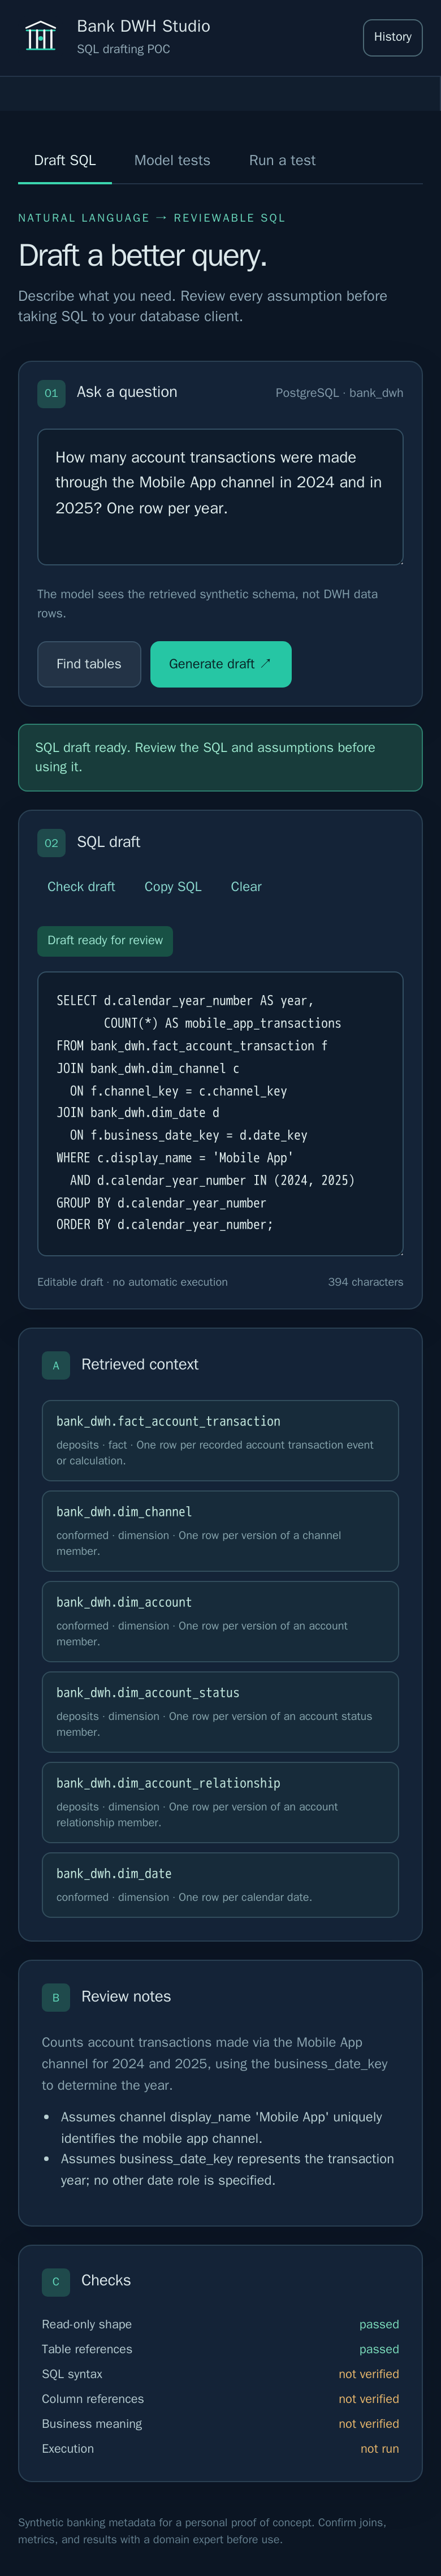
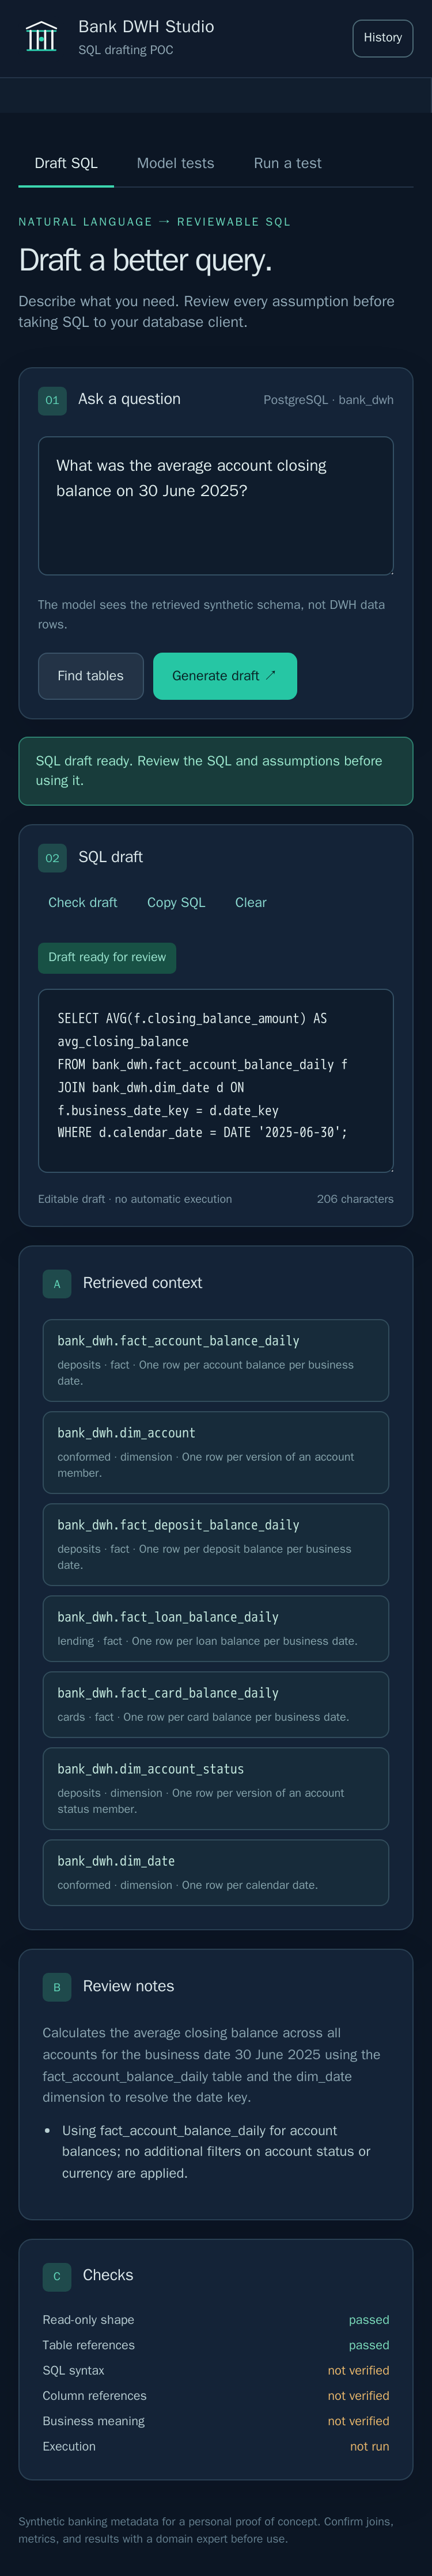
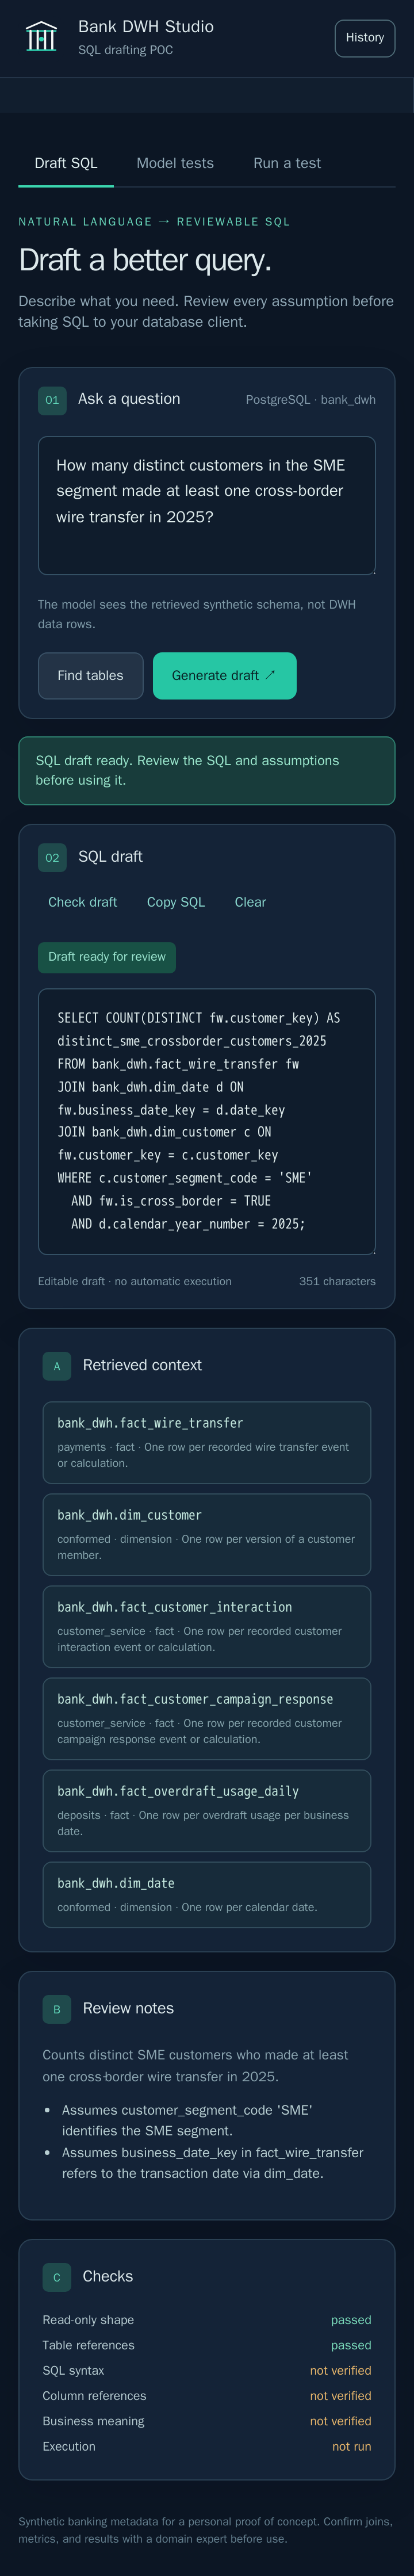
يكتب التطبيق مسودات SQL ويختبرها، لكن على نسخة اصطناعية من المستودع فقط، وبصفة مستخدم لا يملك إلا القراءة؛ ولا يتصل أبدًا بمستودع مصرفي حقيقي. ويظل المستخدمون يراجعون النتيجة، ثم يعدّلونها أو ينسخونها ويشغّلونها في عميل قاعدة البيانات الخاص بهم. ولا يتلقى المتصفح مفتاح API الخاص بالنموذج أبدًا.
تتحقق الفحوصات الآلية من أن صيغة العبارة مخصصة للقراءة فقط ومن الإشارات إلى الجداول المعروفة. أما صحة بناء SQL ومراجع الأعمدة والمعنى من منظور الأعمال فتظل بحاجة إلى مراجعة بشرية. جميع الأسماء والعلاقات والمقاييس في المستودع مواد اختبار اصطناعية وليست تعريفات مصرفية معتمدة.
يشغّل إثبات المفهوم المنشور واجهة خلفية مبنية على Node وElasticsearch ومستودع PostgreSQL للقراءة فقط في حاويات دون صلاحيات الجذر على خادم Oracle Ampere A1، ويكتب SQL باستخدام gpt-oss-20b عبر مزوّد مستضاف. ويوثّق المستودع أيضًا بنية مستقبلية أوسع، مفصولة بوضوح عن إثبات المفهوم الأصغر المنشور.