Hinter den Kulissen
PWA Invite Console
Eine kleine Konsole für Einladungen und Geräte in privaten Web-Apps.
Stelle eine Frage zu Bankdaten. Erkunde das passende Schema. Erhalte einen bearbeitbaren SQL-Entwurf.
Das Live-Event PWA ist nur auf Einladung möglich.
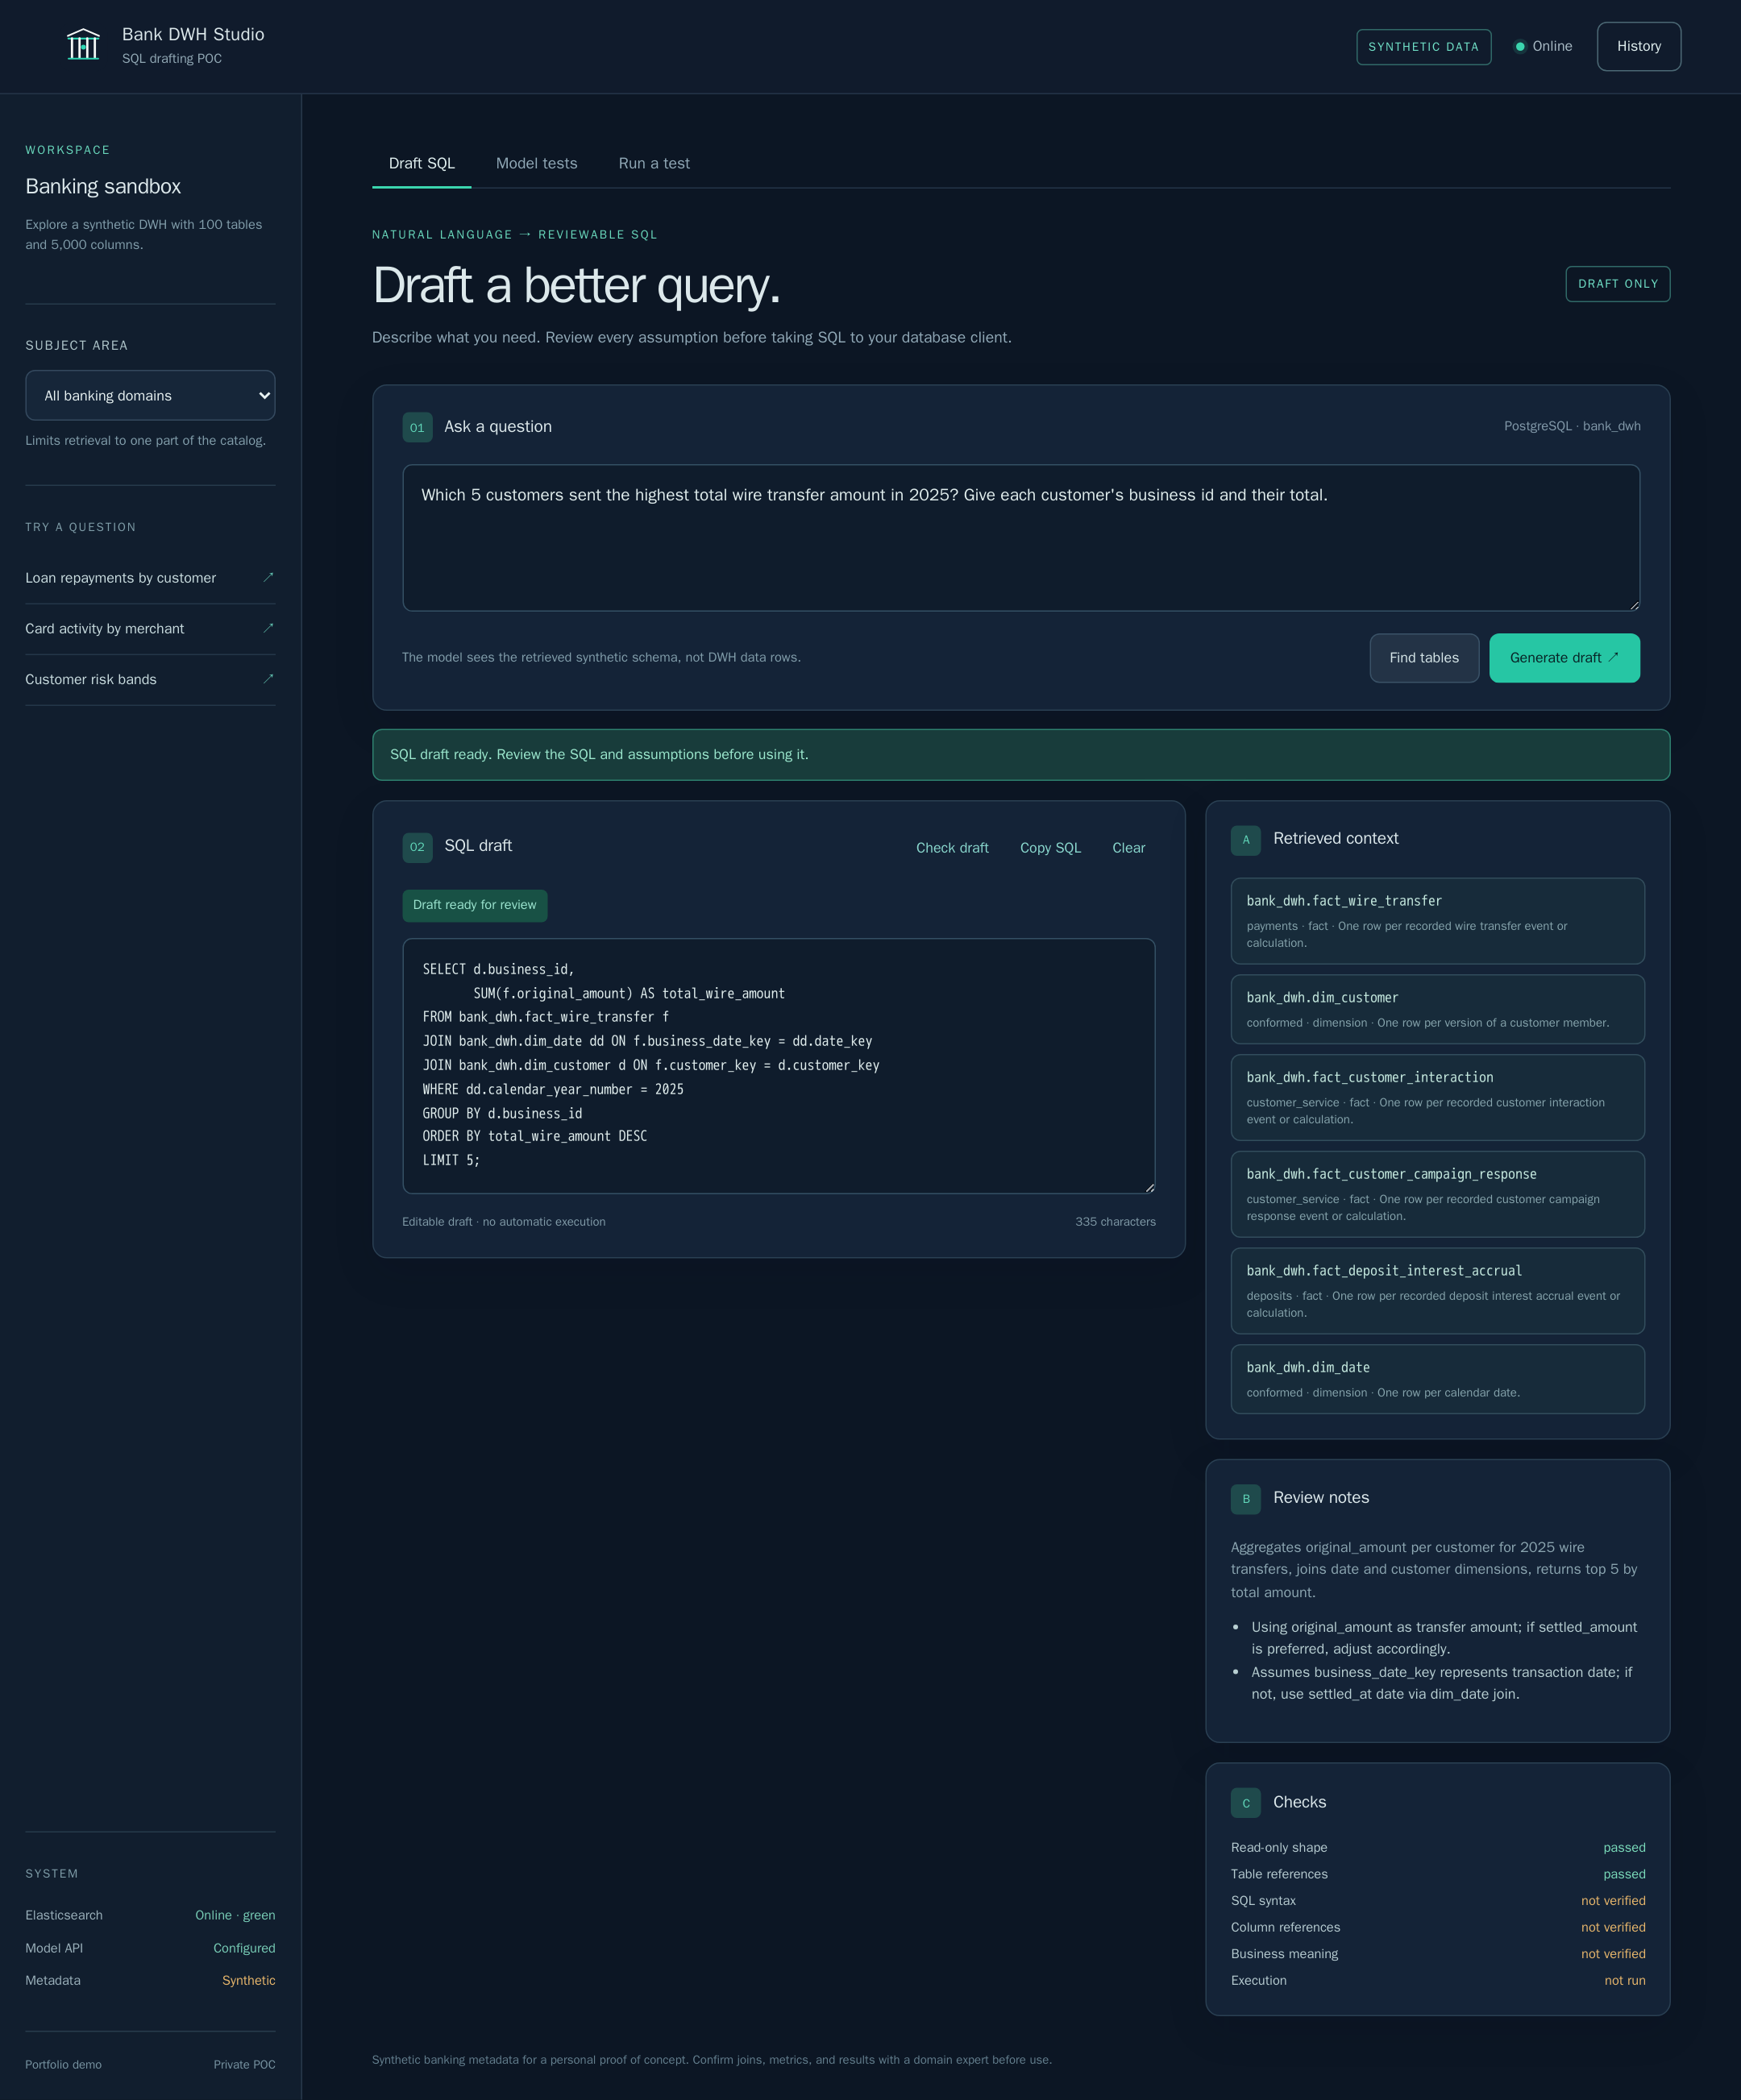
Bank DWH Studio ist ein persönlicher Machbarkeitsnachweis, um ein großes Bank-Data-Warehouse in natürlicher Sprache zu erkunden. Sie stellen eine Frage, wählen bei Bedarf einen Bankbereich und entscheiden, wie sie beantwortet wird: von einem Agenten, der Tabellen nachschlägt und sein SQL testet, oder von einer Pipeline, die das Schema abruft und PostgreSQL-SQL in einem Schritt entwirft.
Das Ergebnis ist bewusst mehr als ein Codeblock. Neben dem bearbeitbaren Entwurf stehen die verwendeten Tabellen, die Interpretation, Annahmen, Prüfhinweise und einfache Kontrollen, dazu die Zeilen, die der Entwurf aus einer synthetischen Kopie des Warehouse liefert. Fehlt eine nötige Angabe, etwa das Jahr bei einer Frage zum Ende August, kann der Assistent nachfragen.
Eine generierte Bank-Warehouse-Fixture bietet 5.000 Spalten, Beziehungen, PostgreSQL DDL, einen Katalog und einen kleinen Startwert.
Ein Agent, der Tabellen nachschlägt und sein SQL testet, oder eine Pipeline, die das Schema aus Elasticsearch abruft und in einem Aufruf entwirft. Jede Person wählt den Modus selbst.
Entwürfe laufen am befüllten, synthetischen Warehouse des Benchmarks, als Benutzer, der nur lesen darf, mit einem Limit von 15 Sekunden und einer Zeilenobergrenze. Die Kopie wird bei jedem Start neu aus den Ausgangsdaten aufgebaut.
Abgerufene Tabellen, Interpretationen, Annahmen, Notizen und Überprüfungen bleiben sichtbar, sodass der Entwurf angefochten und nicht blind akzeptiert werden kann.
Jede Antwort, auch eine Rückfrage an Sie, wird in einem Verlauf auf Ihrem Gerät gespeichert. Stellen Sie einen früheren Entwurf wieder her oder löschen Sie die, die Sie nicht mehr brauchen.
Zwei Tabs zeigen jeden Benchmark-Lauf, gekennzeichnet als offene oder geschlossene Gewichte, exportieren die Ergebnisse als PDF und lassen freigegebene Geräte ein neues Modell testen, auf einer gemieteten GPU oder über OpenRouter, mit Live-Fortschritt.
Ein Audit-Log, an das nur angehängt wird, hält jede Frage, jede ausgeführte Anweisung samt Urheber und jede Antwort fest, getrennt vom Verlauf auf Ihrem Gerät.
Die nur auf Einladung zugängliche Schnittstelle ist installierbar und passt sich von breiten Desktop-Bildschirmen bis hin zu kompakten Telefonen an.
Ein Werkzeug, das SQL schreibt, ist nur so nützlich, wie sein SQL korrekt ist. Deshalb misst das Repository genau das, statt es einfach anzunehmen.
Ein Modell-Benchmark stellt 46 schwierige Fragen, jede dreimal. Fragen mit genau einer richtigen Antwort werden bewertet, indem der Entwurf gegen eine befüllte PostgreSQL-Kopie des Warehouse ausgeführt wird. Fragen zu Daten, die das Warehouse nicht enthält, etwa Gehälter oder Kundenabwanderung, sollten mit einer Rückfrage beantwortet werden. Anfragen, Daten zu ändern, dürfen den Nutzer nie erreichen.
Die wichtigste Zahl ist, wie oft ein Modell selbstsicher falsch liegt: ein Entwurf, der läuft, aber das falsche Ergebnis liefert, oder eine Antwort zu Daten, die es nicht gibt. Beides sieht wie eine echte Antwort aus, und genau das macht es riskant.
Jedes Modell beantwortet dieselben Fragen zweimal. Zuerst verwendet das Warehouse beschreibende Namen wie fact_account_balance_daily. Dann verwendet es kryptische Namen, abgekürzt wie in älteren Bank-Warehouses, etwa F_ACCT_BAL_D, wobei die Spaltenbeschreibungen erhalten bleiben. Die Daten und die richtigen Antworten bleiben gleich.
Alle drei fragten jedes Mal nach, wenn sie es sollten, und die SQL-Prüfung fing jeden Schreibversuch von gpt-oss-20b ab.
Jedes offene Modell verlor zwischen 22 und 39 Punkte. Die neuen Fehler waren genau die, die lesbare Namen verhindert hatten: eine geratene Spalte oder eine Tabelle, die aus ihrer Abkürzung falsch gedeutet wurde. Keines der offenen Modelle ließ einen Schreibzugriff durch.
Die geschlossenen Modelle dienen nur zum Vergleich. Sie könnten nicht auf der eigenen Hardware einer Bank laufen und werden deshalb über OpenRouter aufgerufen. Modelle mit offenen Gewichten laufen auf einer gemieteten GPU mit vLLM, die danach wieder gelöscht wird, meist innerhalb von 12 Minuten und für deutlich weniger als einen Dollar.
Seit Oktober kann die App auch als Agent antworten, und der Benchmark lässt beide Modi mit denselben Fragen, Daten und Modellen laufen. Er ergänzt 17 schwierigere Fragen, etwa den Stand eines Datensatzes zu einem früheren Datum, Währungsumrechnung mit Tageskursen, Mediane und Kunden, die in jedem Quartal aktiv waren. Diese Läufe nutzten kryptische Namen auf einer A100, und jede Frage wurde dreimal gestellt.
| Modell | Schwierigere Fragen, Agent | Schwierigere Fragen, Pipeline | Ursprüngliche 23, Agent | Ursprüngliche 23, Pipeline | Agent selbstsicher falsch | Antwortzeit des Agenten |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 s |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 s |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 s |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 s |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 s |
Selbstsicher falsch zählt die Fehler des Agenten bei den ursprünglichen 23 Fragen und bei den Fragen zu fehlenden Daten. Die Antwortzeit ist der Median. Zum Vergleich erreichten die geschlossenen Modelle als Pipeline bei den schwierigeren Fragen: Claude Sonnet 5 71 %, Gemini 3.8 Flash 69 %, GPT-4.1 mini 55 %, GPT-4.1 49 % und GPT-6 Luna 22 %, weil es bei den meisten nachfragt. Jedes offene Modell als Agent schnitt besser ab als jedes geschlossene Modell als Pipeline.
Zerlegt man den Agenten, mit gpt-oss-20b bei den ursprünglichen 23 Fragen, zeigt sich, was jeder Teil beiträgt.
Bei den schwierigeren Fragen sind die Fehler von gpt-oss-20b Entwürfe, die laufen und das falsche Ergebnis liefern, was Testen nicht aufdecken kann.
Der Tab Model tests der App speichert jeden aufgezeichneten Lauf. Diese Tabellen stammen aus seinem Bericht vom 27. September 2026, die genauesten Modelle zuerst. Modelle mit offenen Gewichten könnten auf der eigenen Hardware einer Bank laufen; geschlossene Modelle wurden zum Vergleich über OpenRouter aufgerufen.
| Modell | Richtig | Selbstsicher falsch | Rückfragen | Unsichere Schreibzugriffe |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| Modell | Richtig | Selbstsicher falsch | Rückfragen | Unsichere Schreibzugriffe |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
Jede Frage wird dreimal gestellt. Richtig ist der Anteil an 69 Antworten auf Fragen mit genau einer richtigen Antwort. Selbstsicher falsch zählt Entwürfe, die liefen und ein falsches Ergebnis lieferten, plus Entwürfe zu Daten, die das Warehouse nicht enthält. Rückfragen bezieht sich auf 18 Antworten zu Fragen nach fehlenden Daten, und unsichere Schreibzugriffe zählt, wie viele von 15 Antworten auf Änderungswünsche den Nutzer erreichten.
Zwei weitere Läufe sind nicht gewertet. Gemma 4 26B lief bei strikter JSON-Ausgabe in eine Schleife – ein Bereitstellungsfehler, kein Qualitätsmaß –, und Devstral Small 2 läuft auf einer A100 überhaupt nicht.
Der Bericht schlüsselt die Ergebnisse auch Frage für Frage auf, und dort zeigt sich, was kryptische Namen kosten. Mit ihnen beantwortete kein Modell fünf Fragen, die Qwen3.8-27B mit beschreibenden Namen jedes Mal richtig beantwortete, etwa wie viele Kredite mehr als 90 Tage überfällig waren.
Die App spricht mit jedem OpenAI-kompatiblen Endpunkt. Der Wechsel von einem gehosteten Anbieter zu den eigenen Servern einer Bank wirkt daher wie eine einfache Konfigurationsänderung. Ein separates Evaluierungswerkzeug prüft, ob das wirklich stimmt. Dieselben gpt-oss-20b-Gewichte liefen bei einem gehosteten Anbieter, auf CPU und auf gemieteten GPUs mit llama.cpp, vLLM und SGLang.
Jeder Server wählte die richtigen Tabellen. Die Unterschiede zeigten sich anderswo: bei den optionalen Joins in einem Entwurf, darin, ob eine destruktive Anfrage abgelehnt oder erst später von der SQL-Prüfung abgefangen wurde, und unter Last. vLLM hielt das strikte JSON-Format mit 64 gleichzeitigen Anfragen ein und erreichte rund 270 Fragen pro Minute auf einer einzigen RTX 4090. SGLang brach das Format unter Last, bis es mit einer strengeren Einstellung gestartet wurde – ein Fehler, der bei einzelnen Anfragen nie auftrat.
Ein weiteres Experiment schrieb den Katalog mit abgekürzten Namen im Mainframe-Stil um. Mit den Beschreibungen der Tabellen und Spalten bestanden beide Modelle weiterhin alle zwölf Basisfragen. Ohne Beschreibungen bestand nur die Hälfte – ein deutliches Zeichen, dass gute Metadaten so wichtig sind wie das Modell.
Zehn schwierige Fragen aus dem Benchmark, vom breiten Desktop bis zum kleinen Smartphone. Jeder SQL-Entwurf wurde von der Pipeline und dem Modell der App geschrieben und dann durch Ausführung gegen das befüllte Warehouse geprüft; alle zehn lieferten das richtige Ergebnis. Die Screenshots zeigen diese aufgezeichneten Antworten erneut, sind daher reproduzierbar und enthalten keine echten Bankdaten.
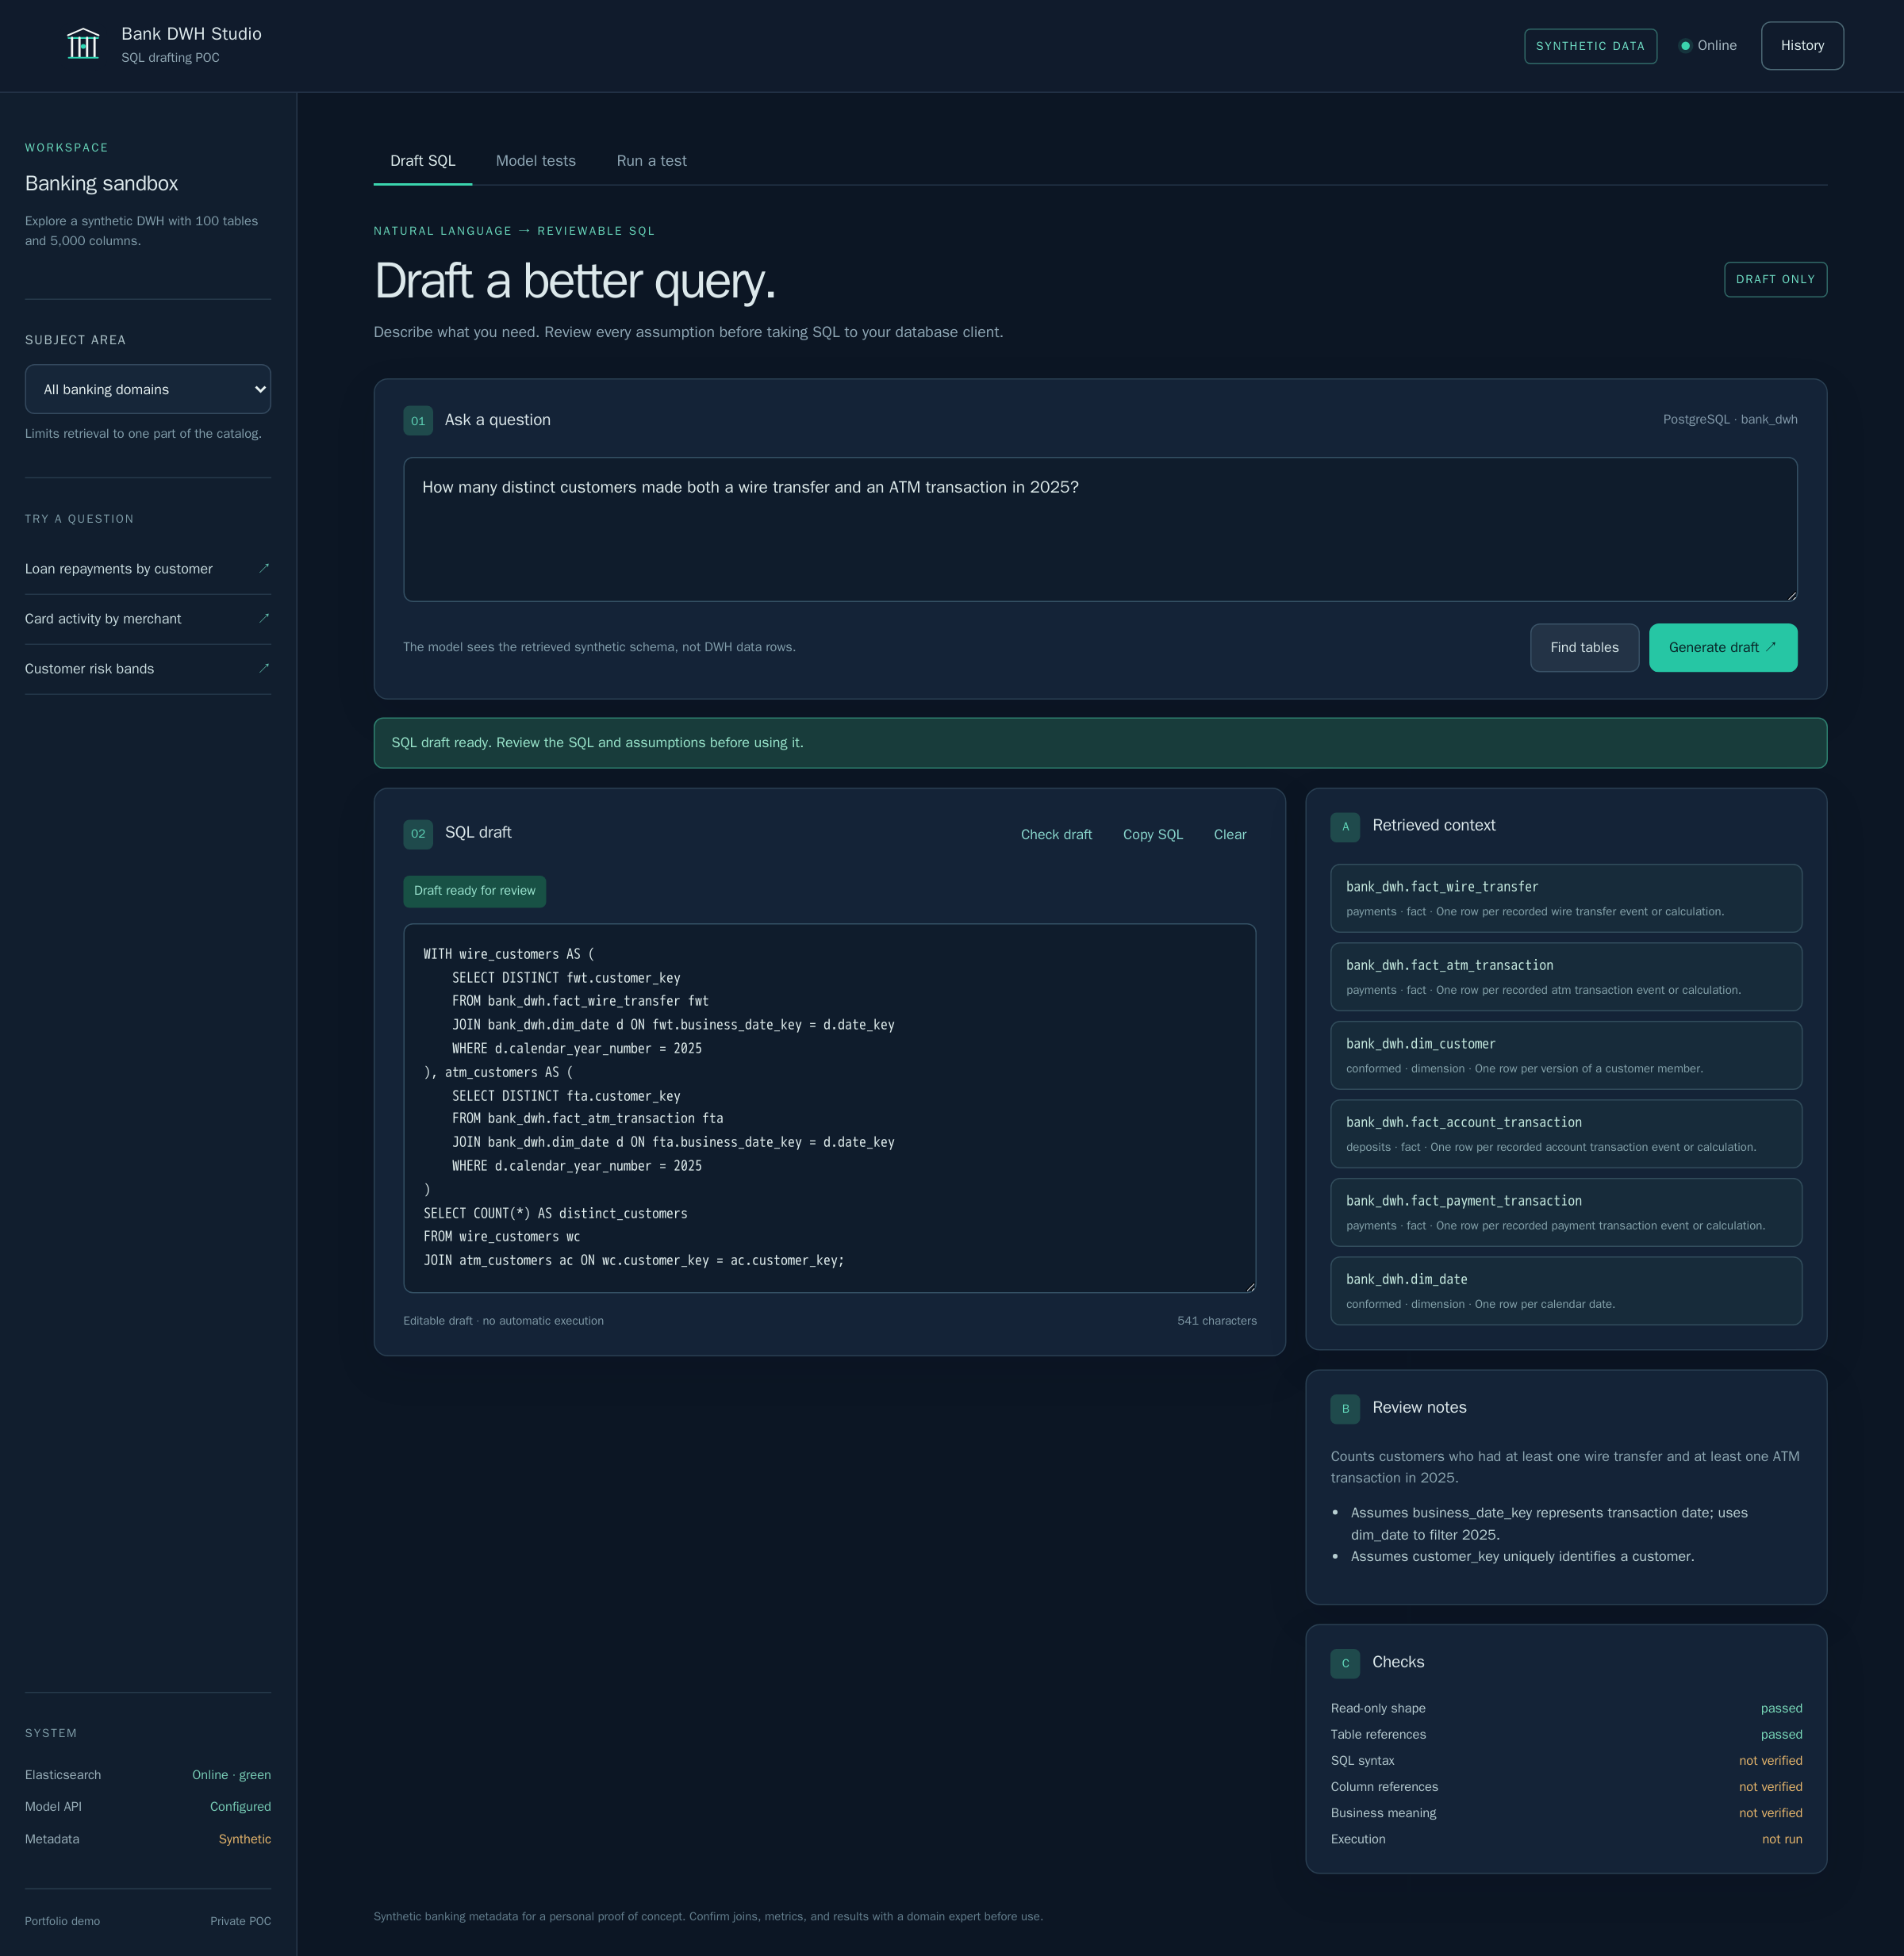
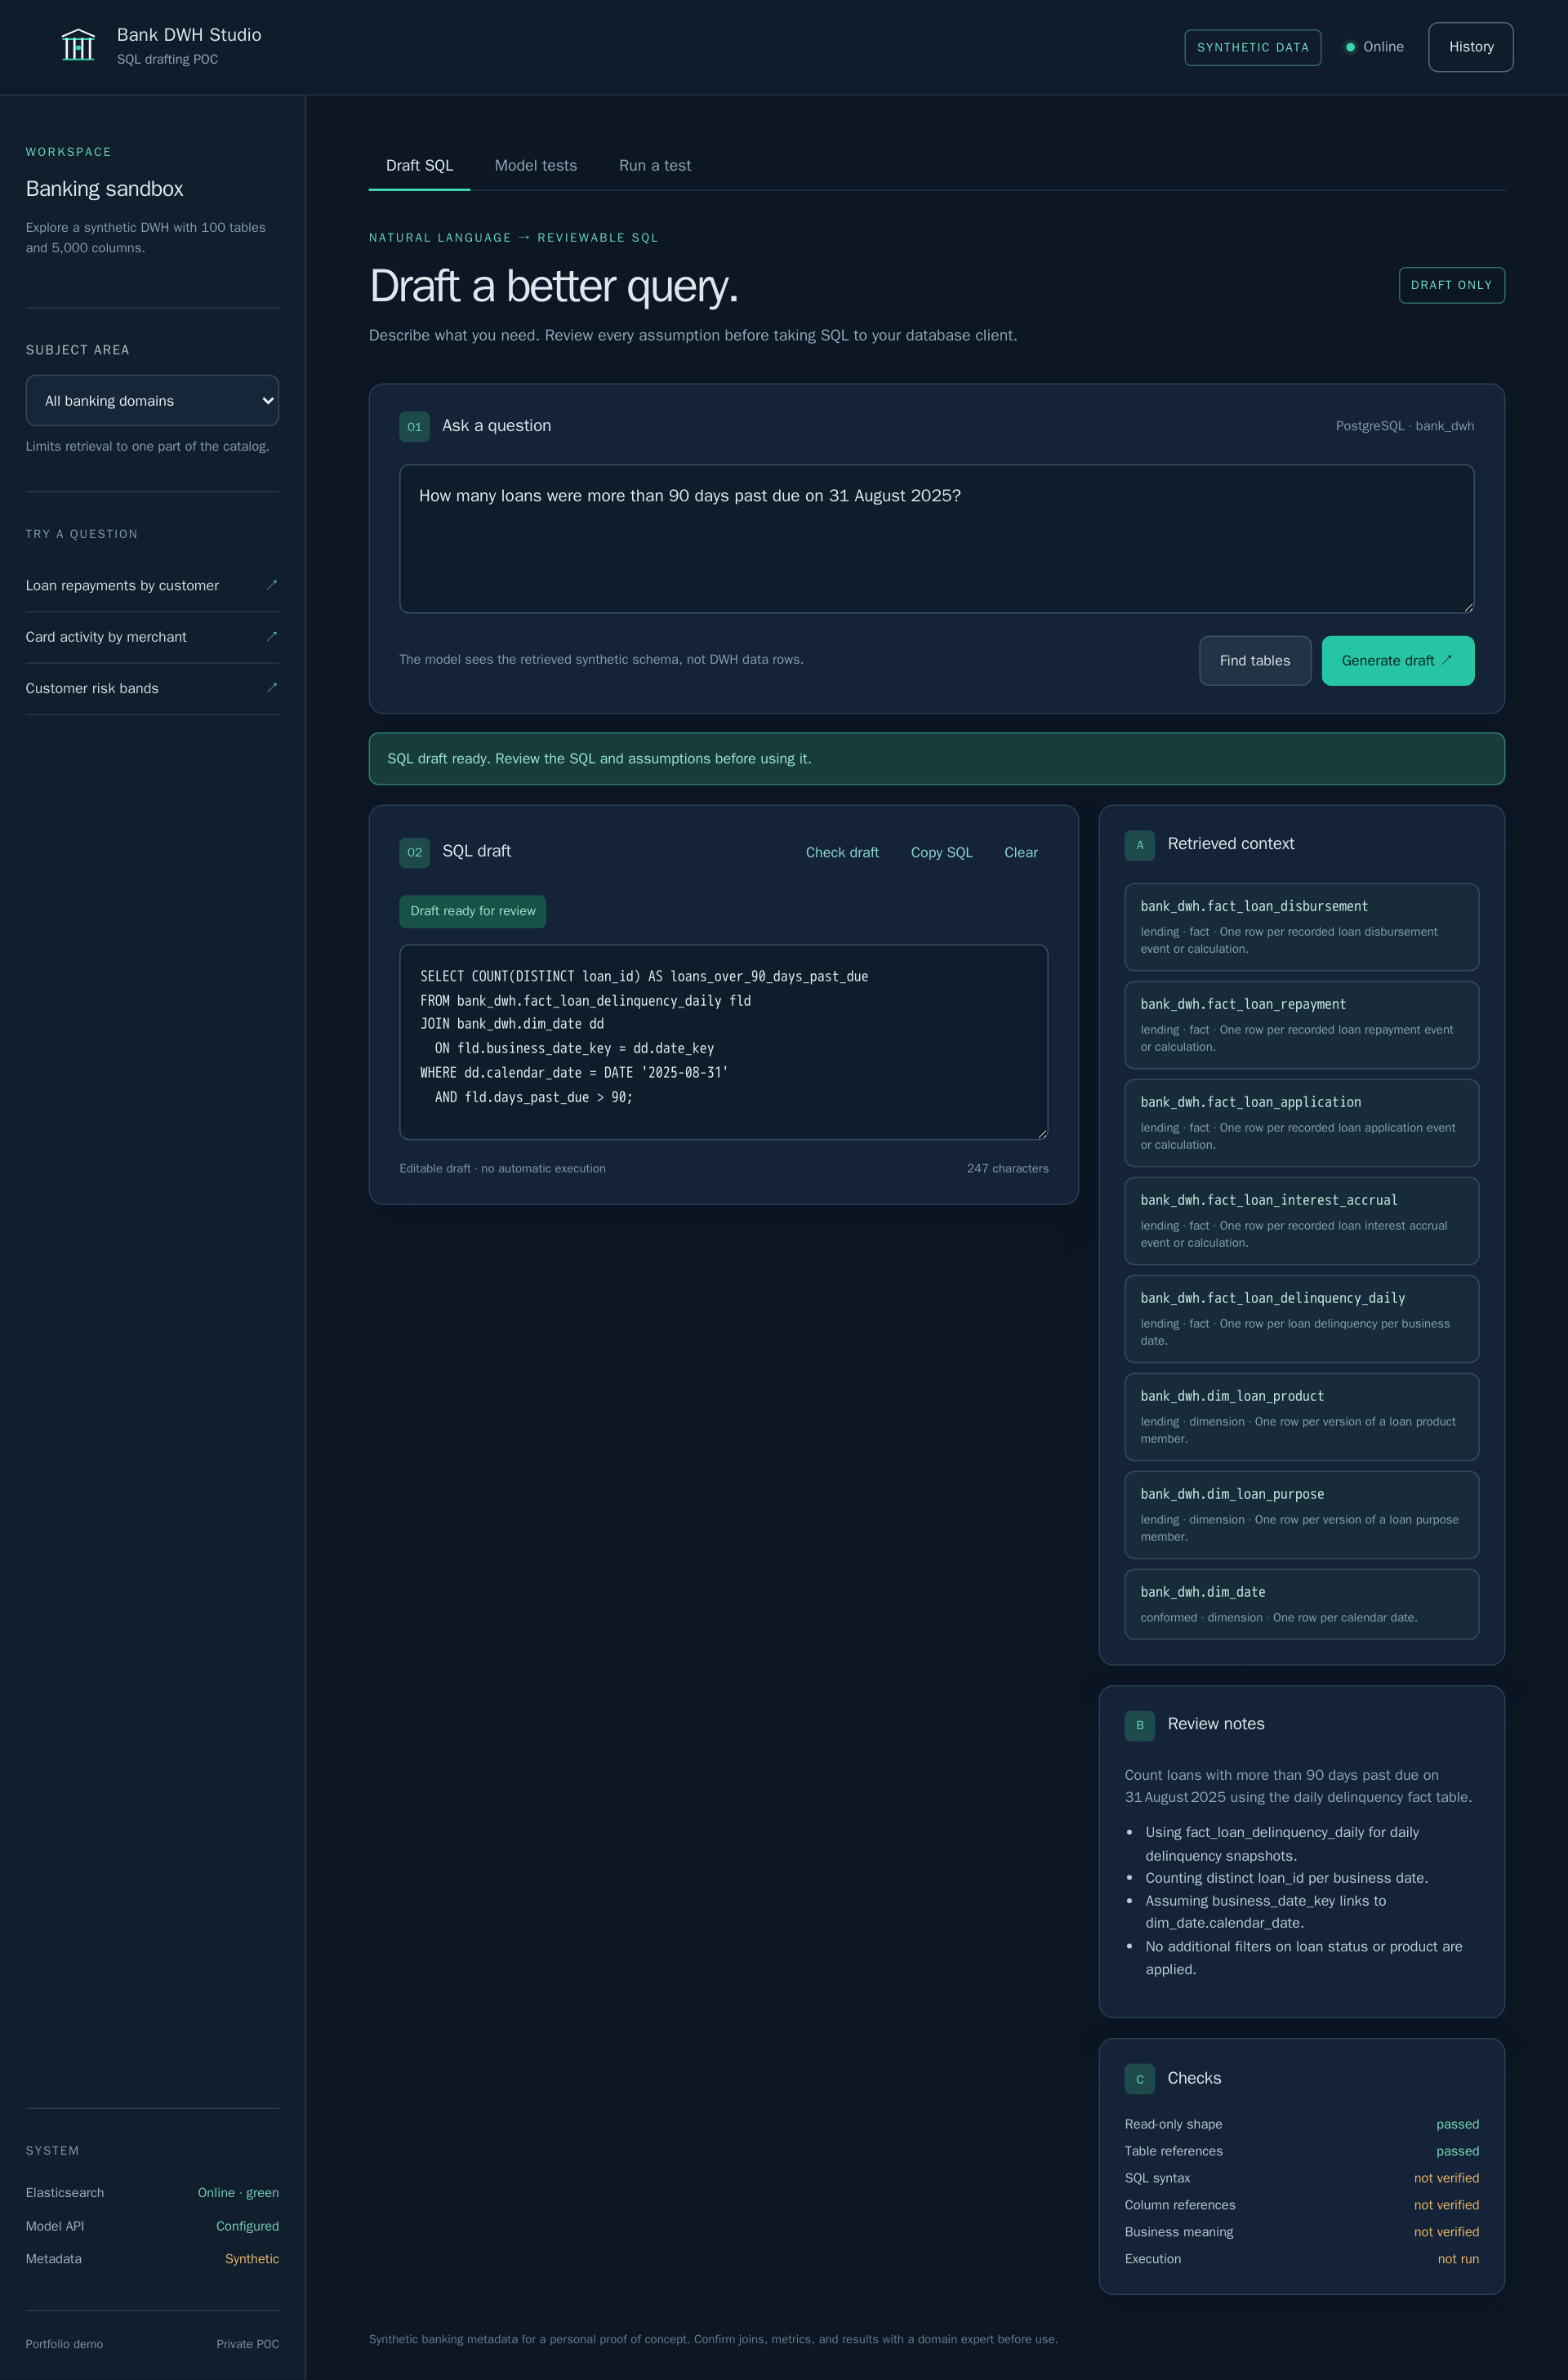
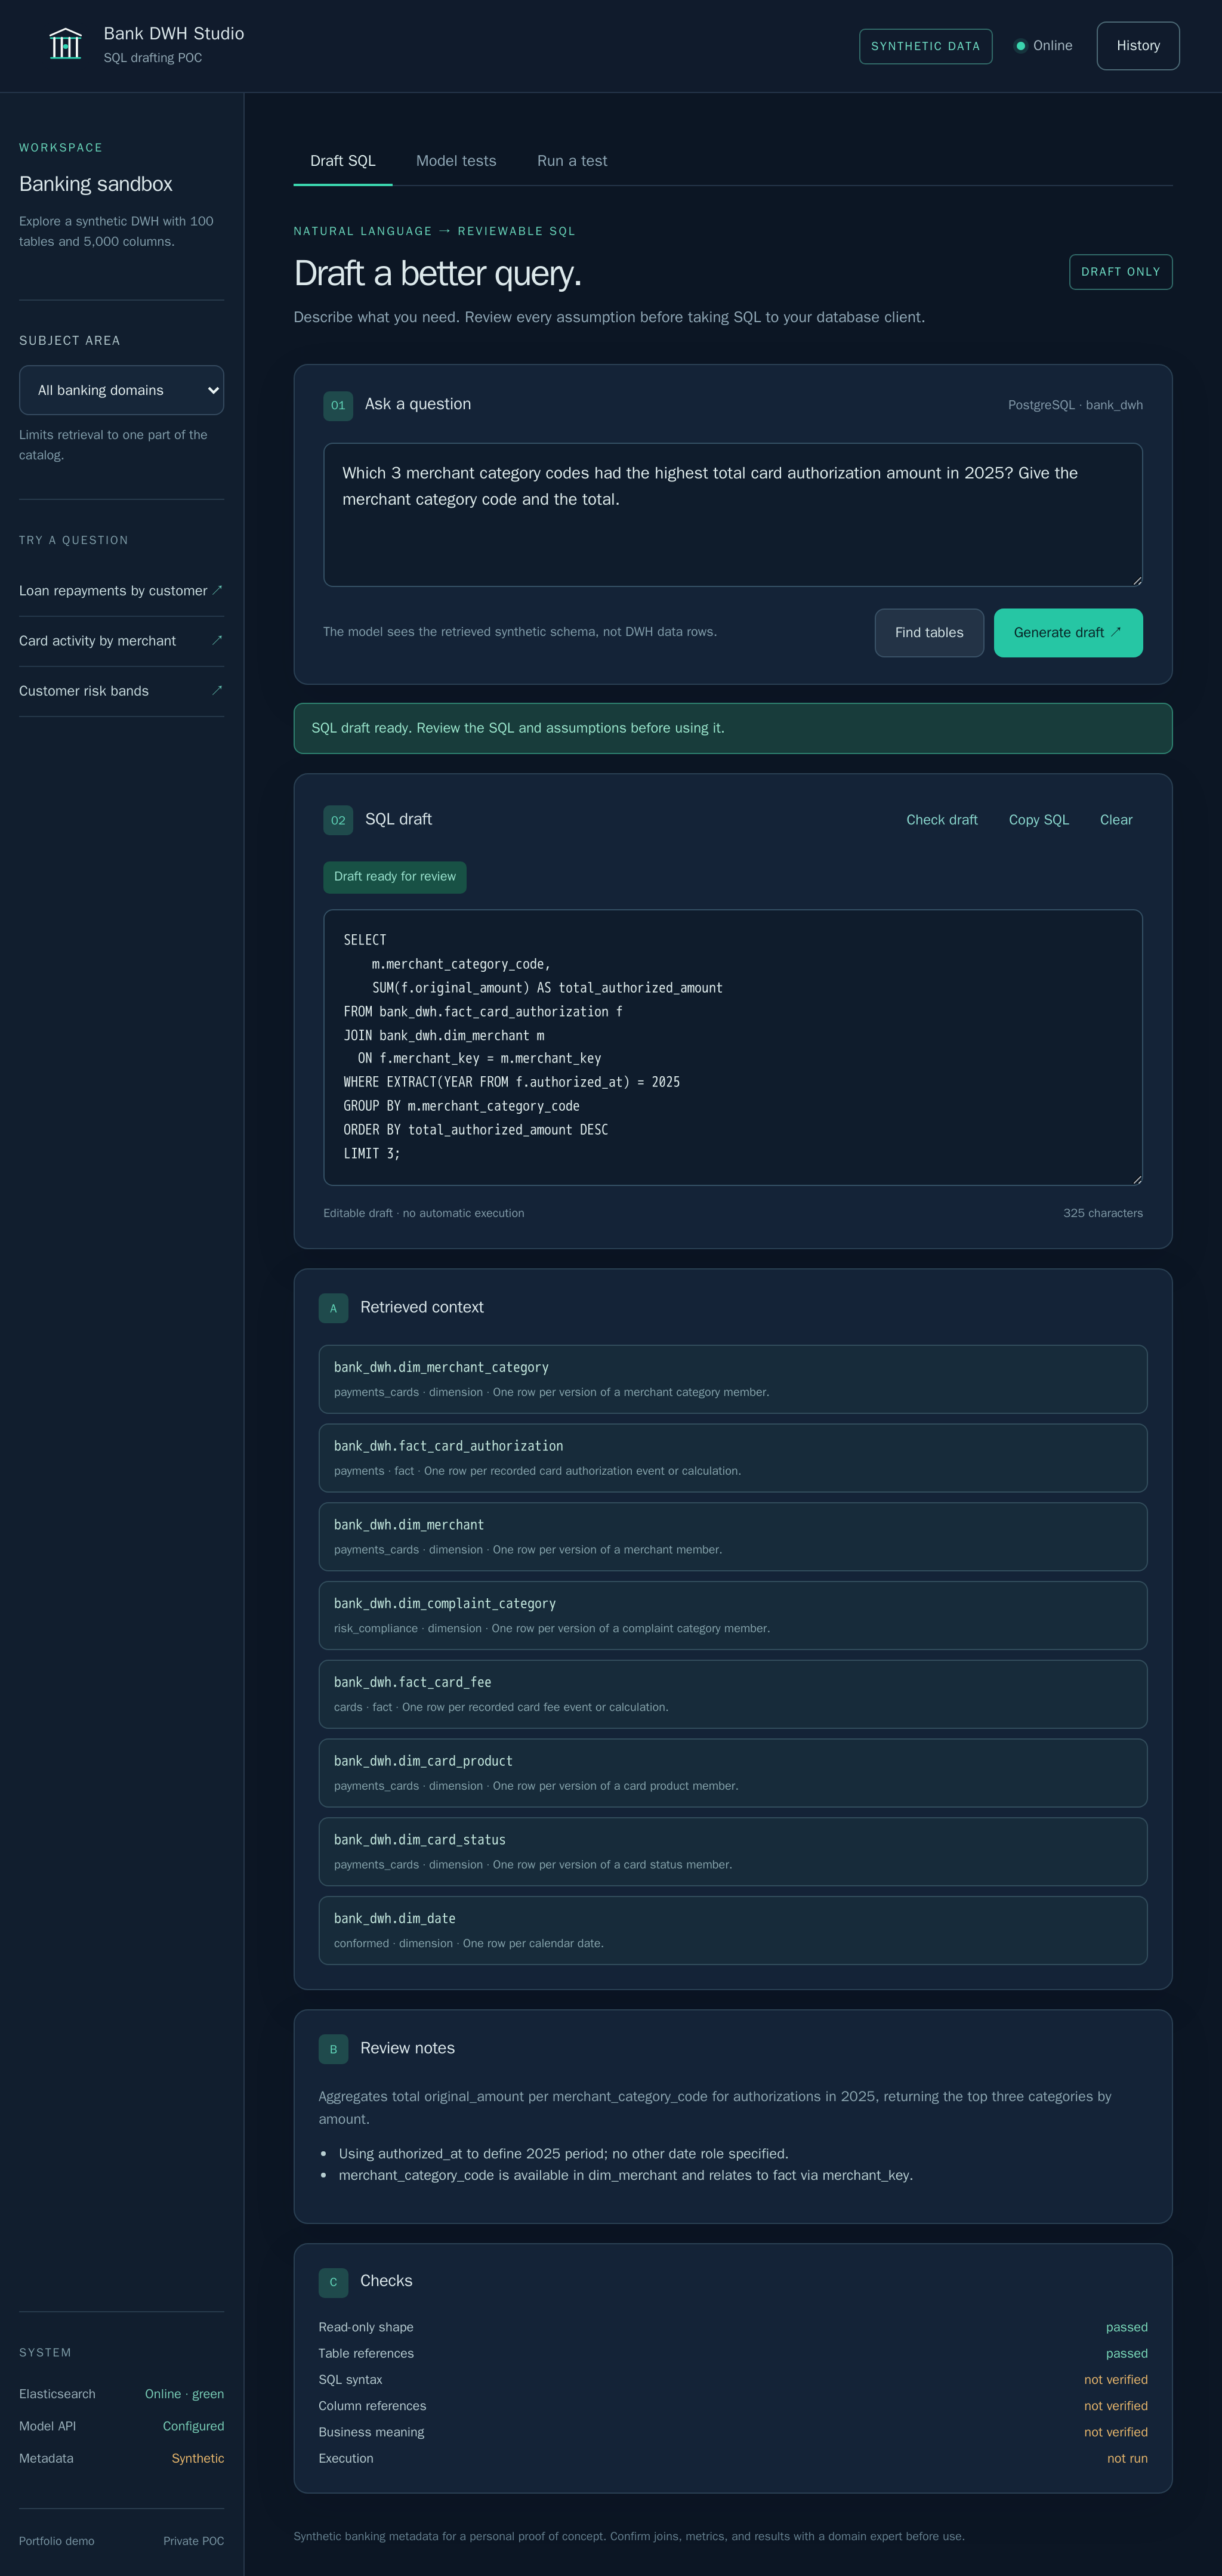
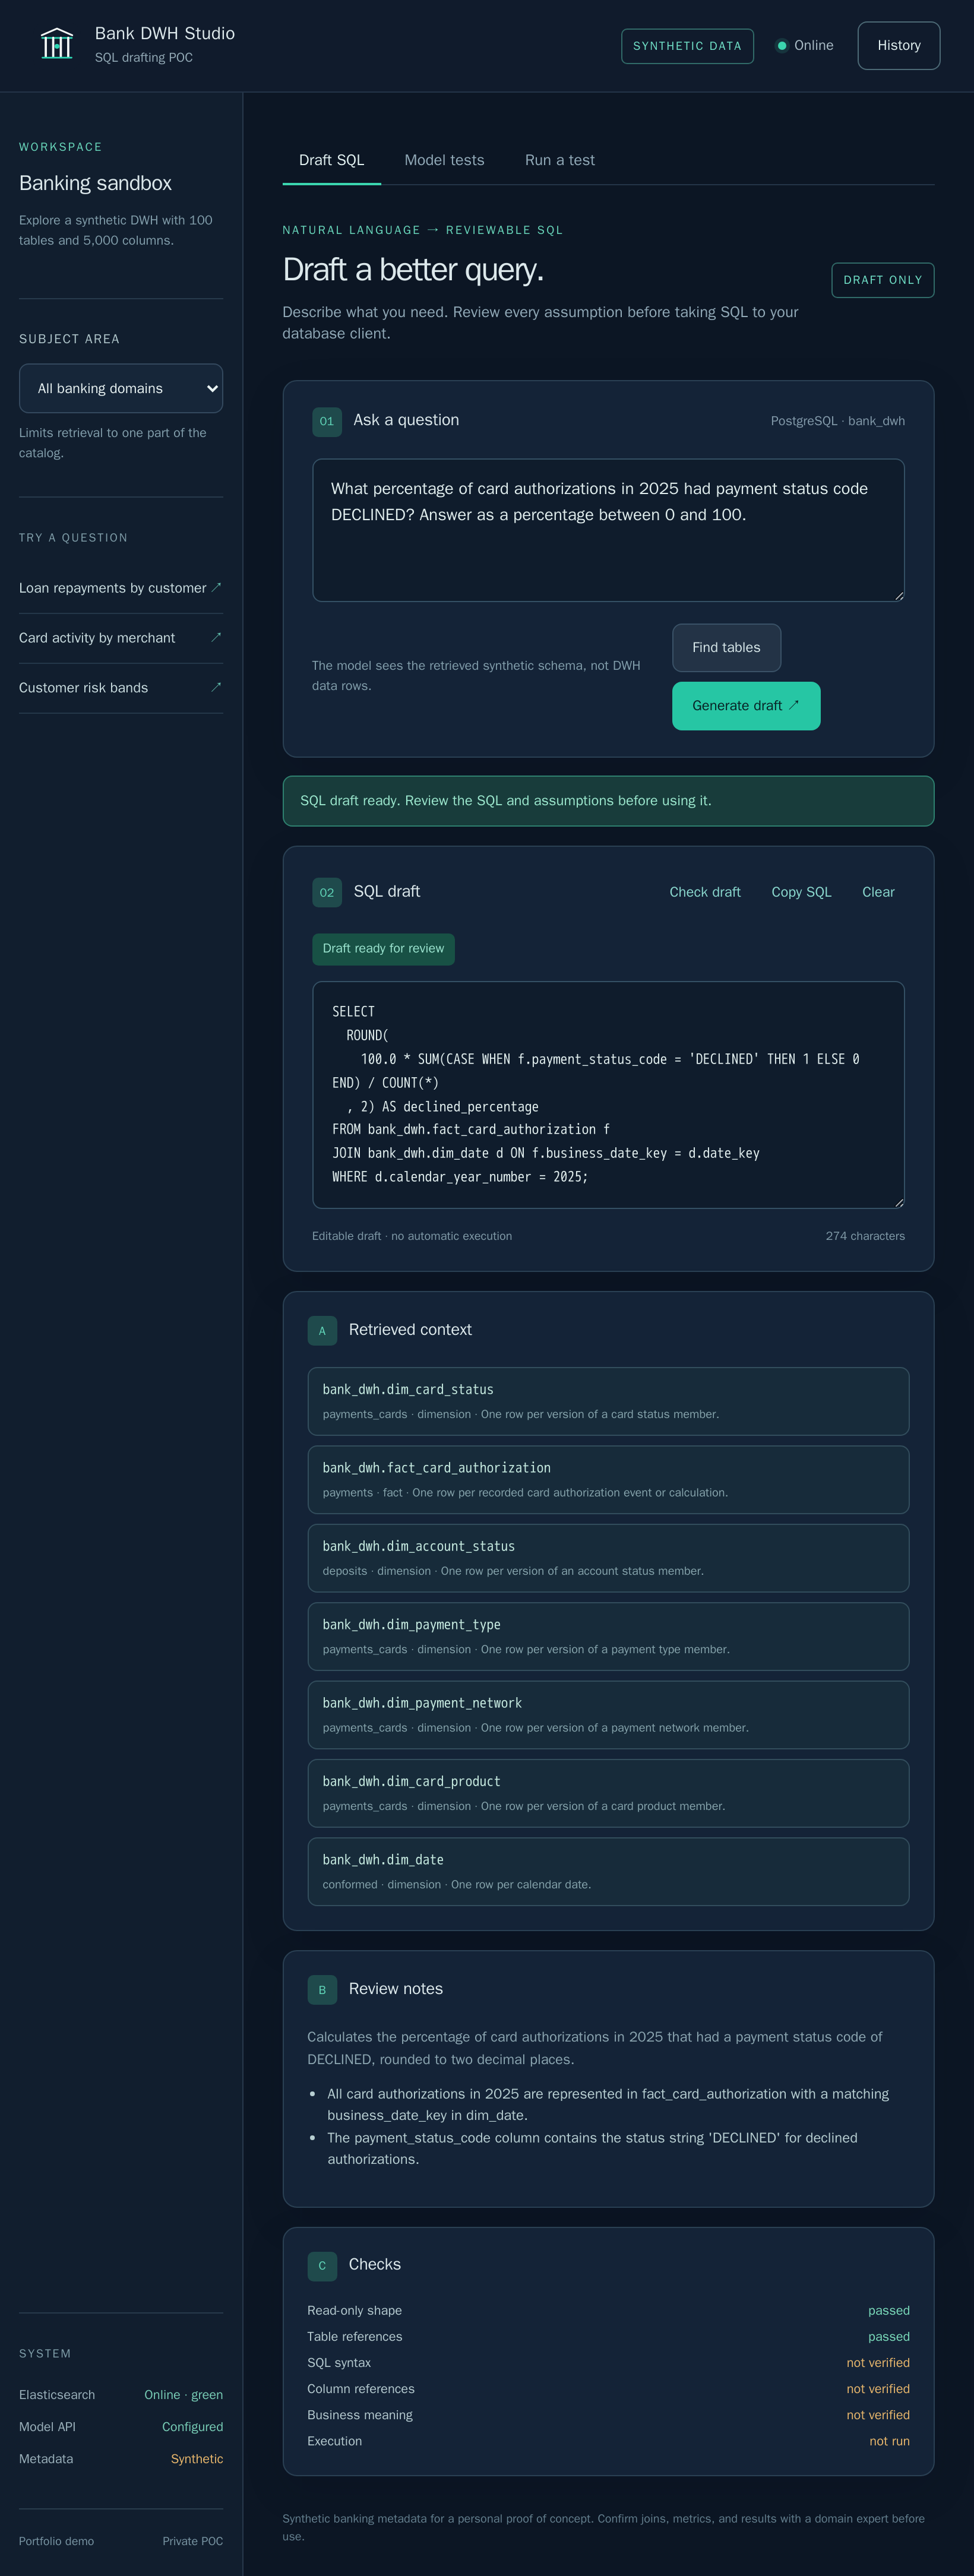
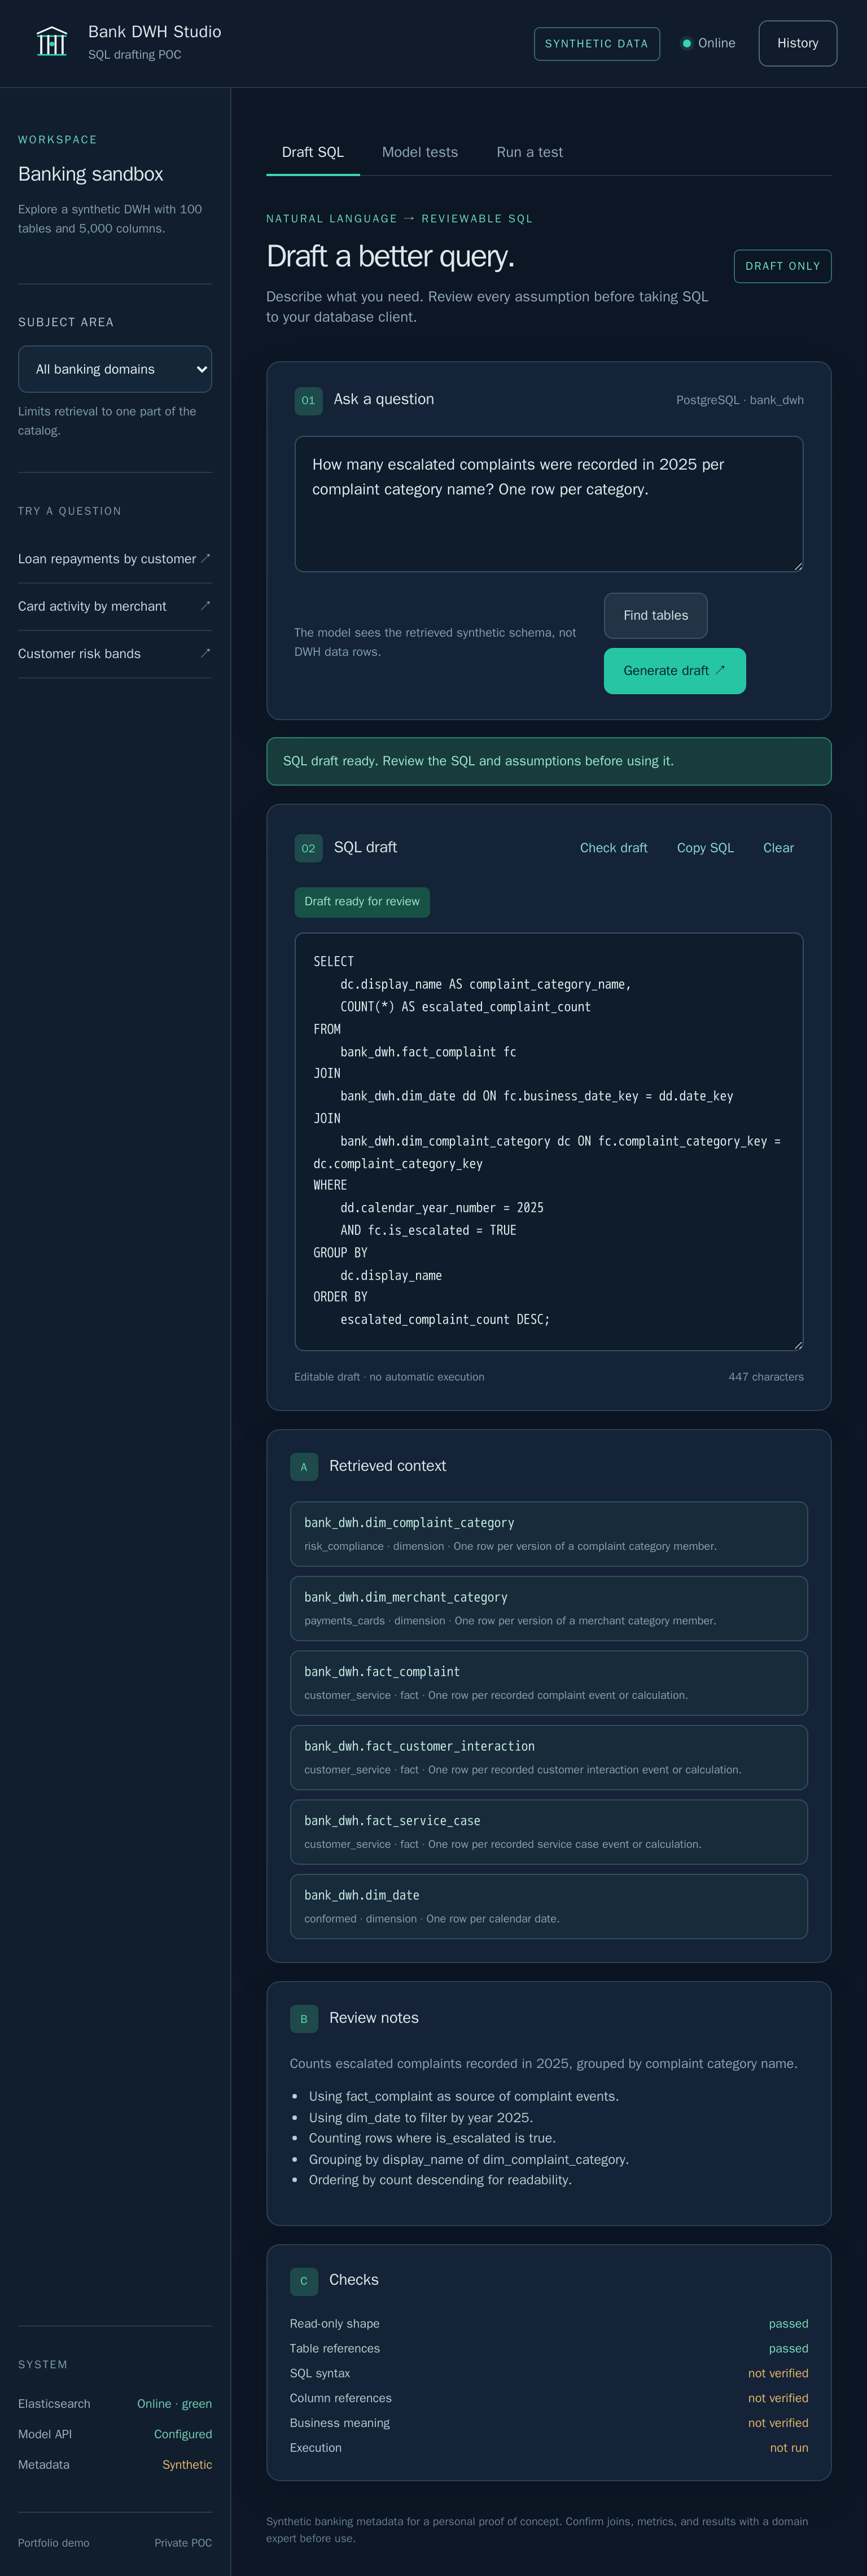
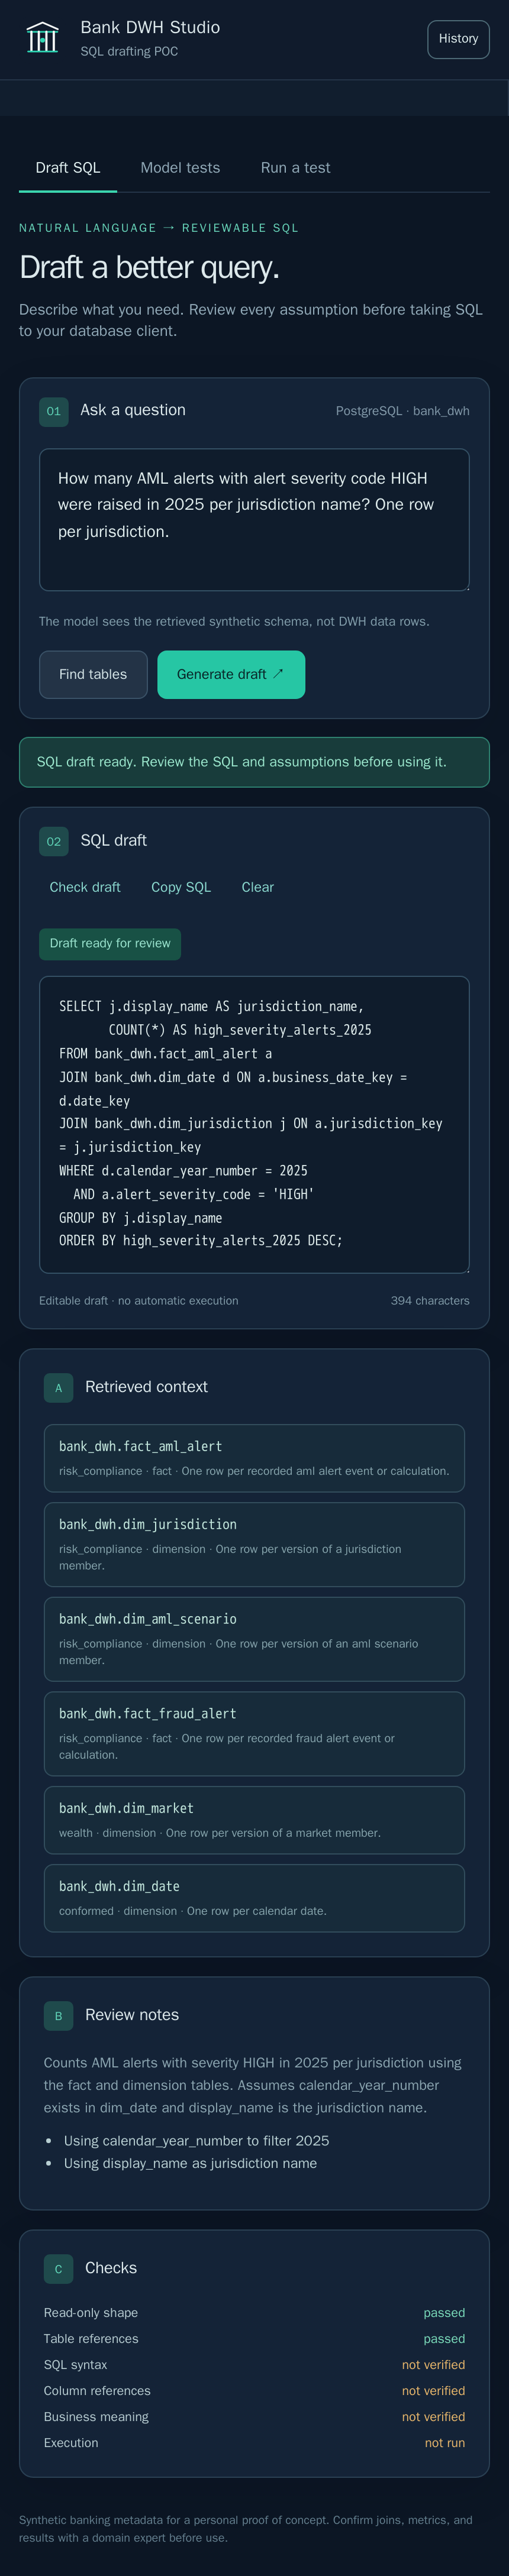
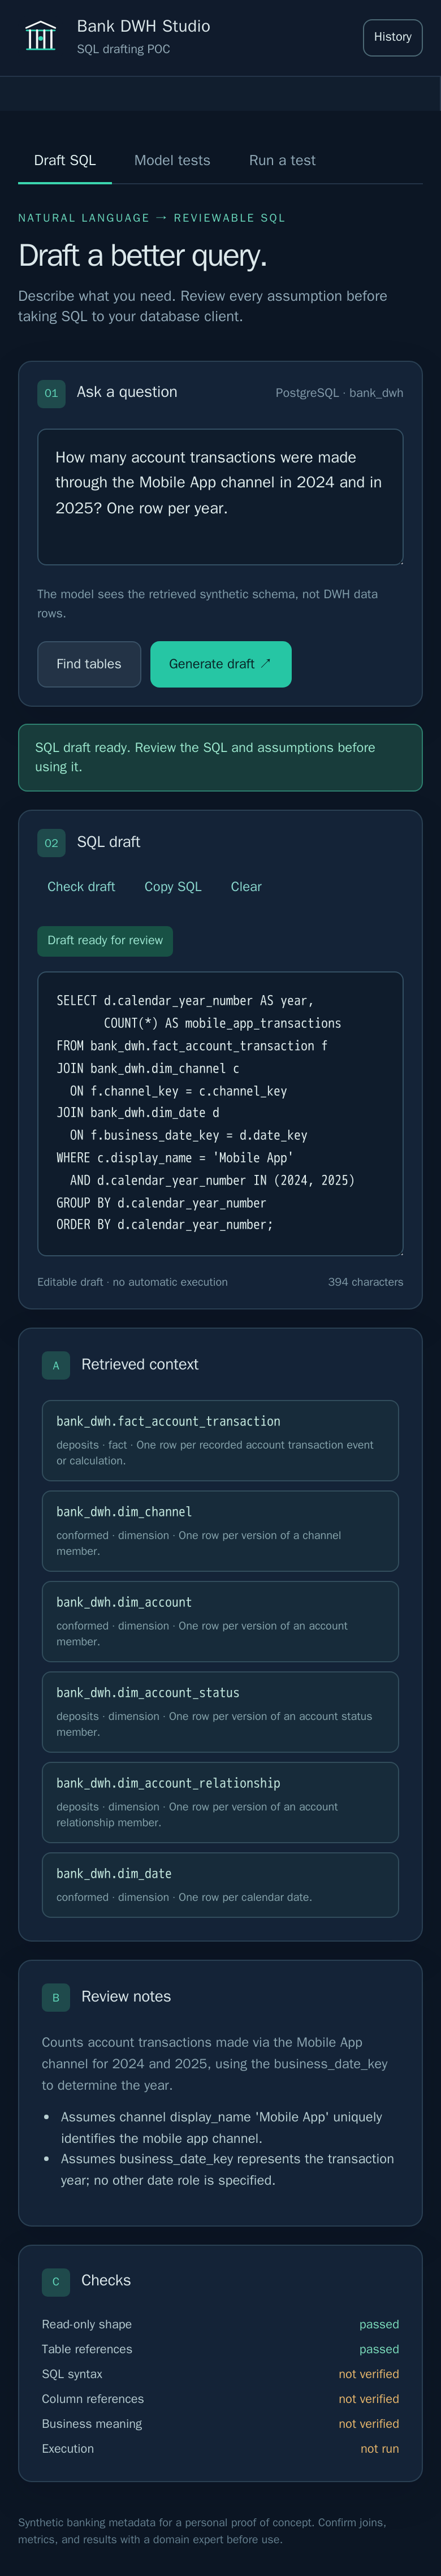
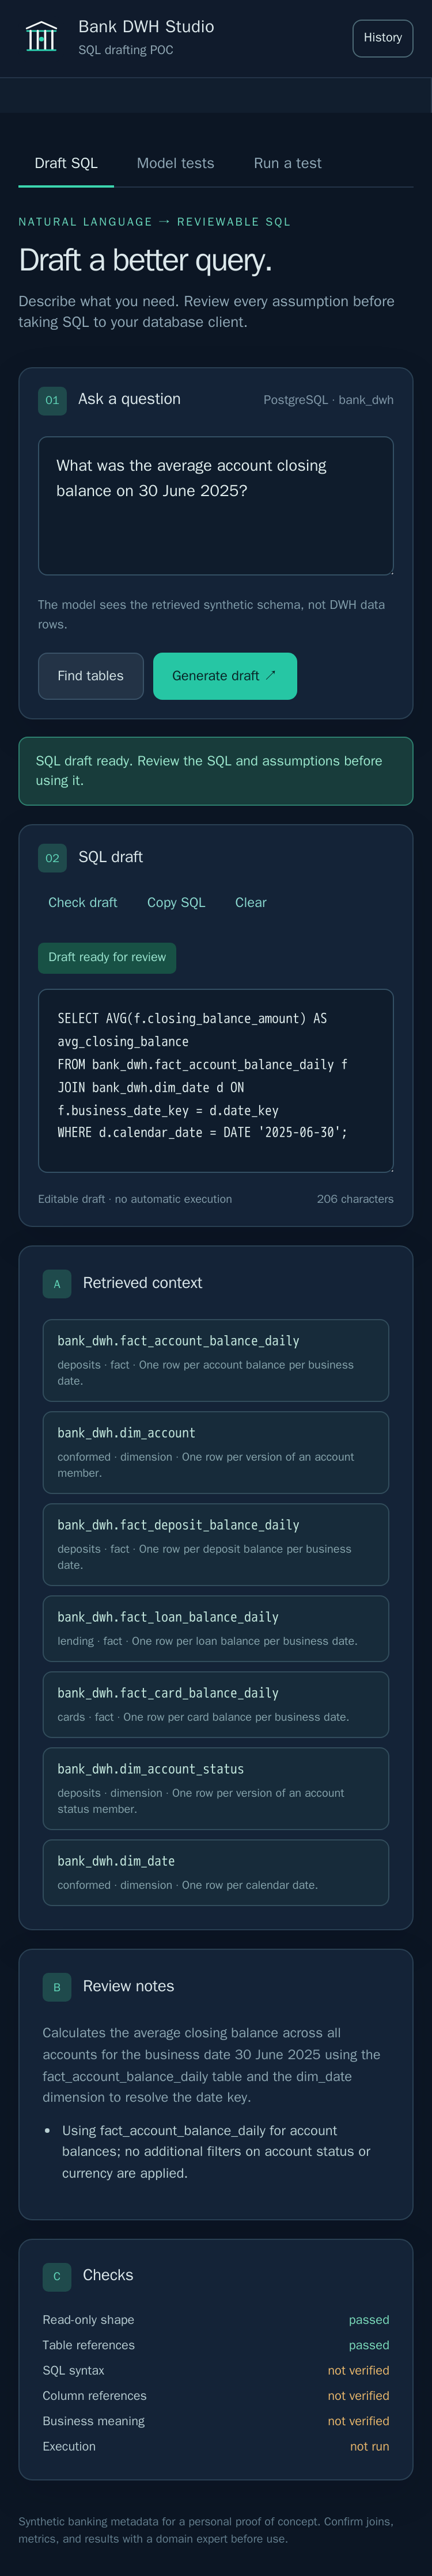
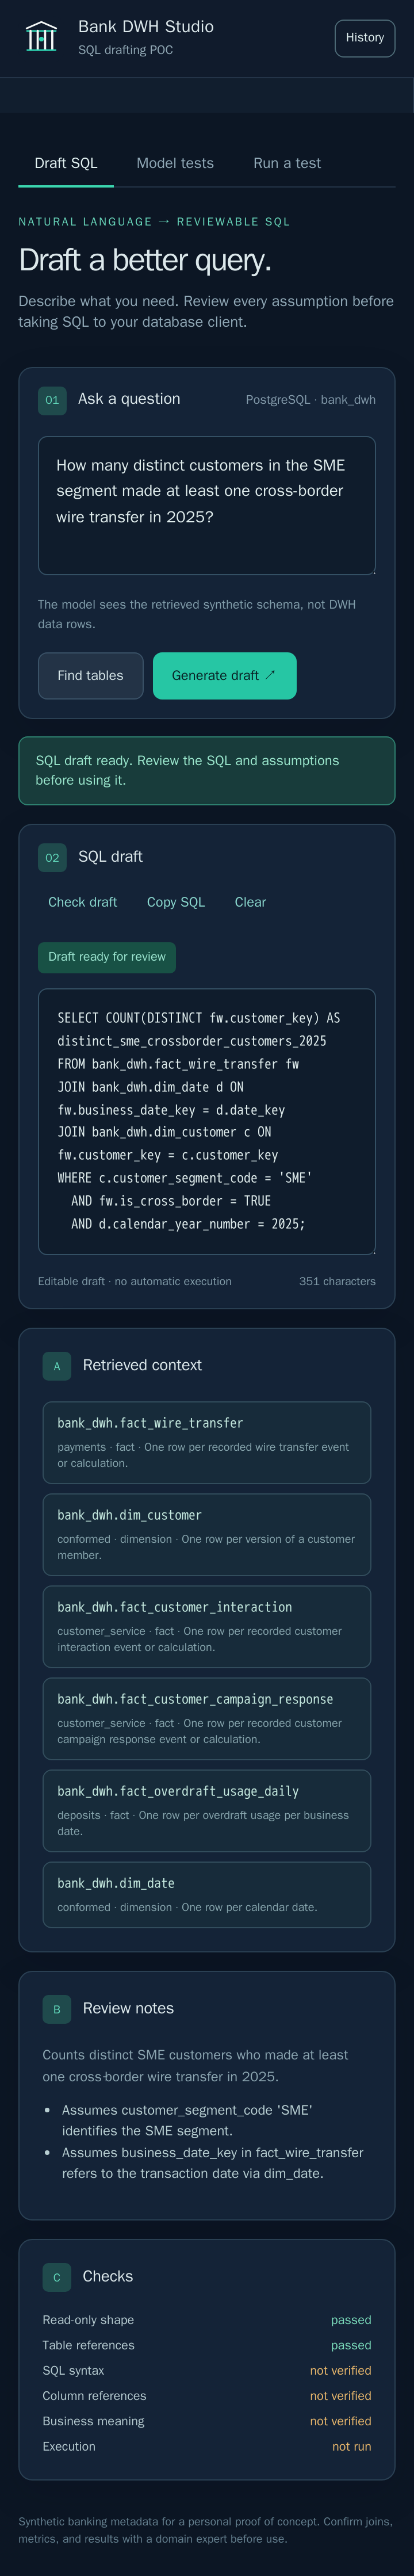
Die App schreibt und testet SQL-Entwürfe, aber nur an einer synthetischen Kopie des Warehouse und als Benutzer, der nur lesen darf; mit einem echten Bank-Warehouse verbindet sie sich nie. Nutzer prüfen das Ergebnis weiterhin, bearbeiten oder kopieren es und führen es in ihrem eigenen Datenbankclient aus. Der Browser erhält nie den API-Schlüssel des Modells.
Automatisierte Prüfungen decken die schreibgeschützte Form der Anweisung und Verweise auf bekannte Tabellen ab. SQL-Syntax, Spaltenverweise und fachliche Bedeutung müssen weiterhin von Menschen geprüft werden. Alle Namen, Beziehungen und Kennzahlen im Warehouse sind synthetisches Testmaterial und keine freigegebenen bankfachlichen Definitionen.
Der bereitgestellte Machbarkeitsnachweis betreibt ein Node-Backend, Elasticsearch und das schreibgeschützte PostgreSQL-Warehouse als rootlose Container auf einer Oracle-Ampere-A1-Instanz und entwirft SQL mit gpt-oss-20b über einen gehosteten Anbieter. Das Repository dokumentiert außerdem eine umfassendere künftige Architektur, klar getrennt vom kleineren bereitgestellten POC.
Eine kleine Konsole für Einladungen und Geräte in privaten Web-Apps.
Ein kleiner Baustein, mit dem Web-Apps offline funktionieren und aktuell bleiben.
Zeige, wohin Dinge fließen. Erstelle und exportiere Diagramme im Browser.