Entre bastidores
PWA Invite Console
Una pequeña consola para gestionar invitaciones y dispositivos en aplicaciones web privadas.
Haz una pregunta sobre datos bancarios. Explora el esquema pertinente. Obtén un borrador SQL editable.
El PWA en vivo es solo por invitación.
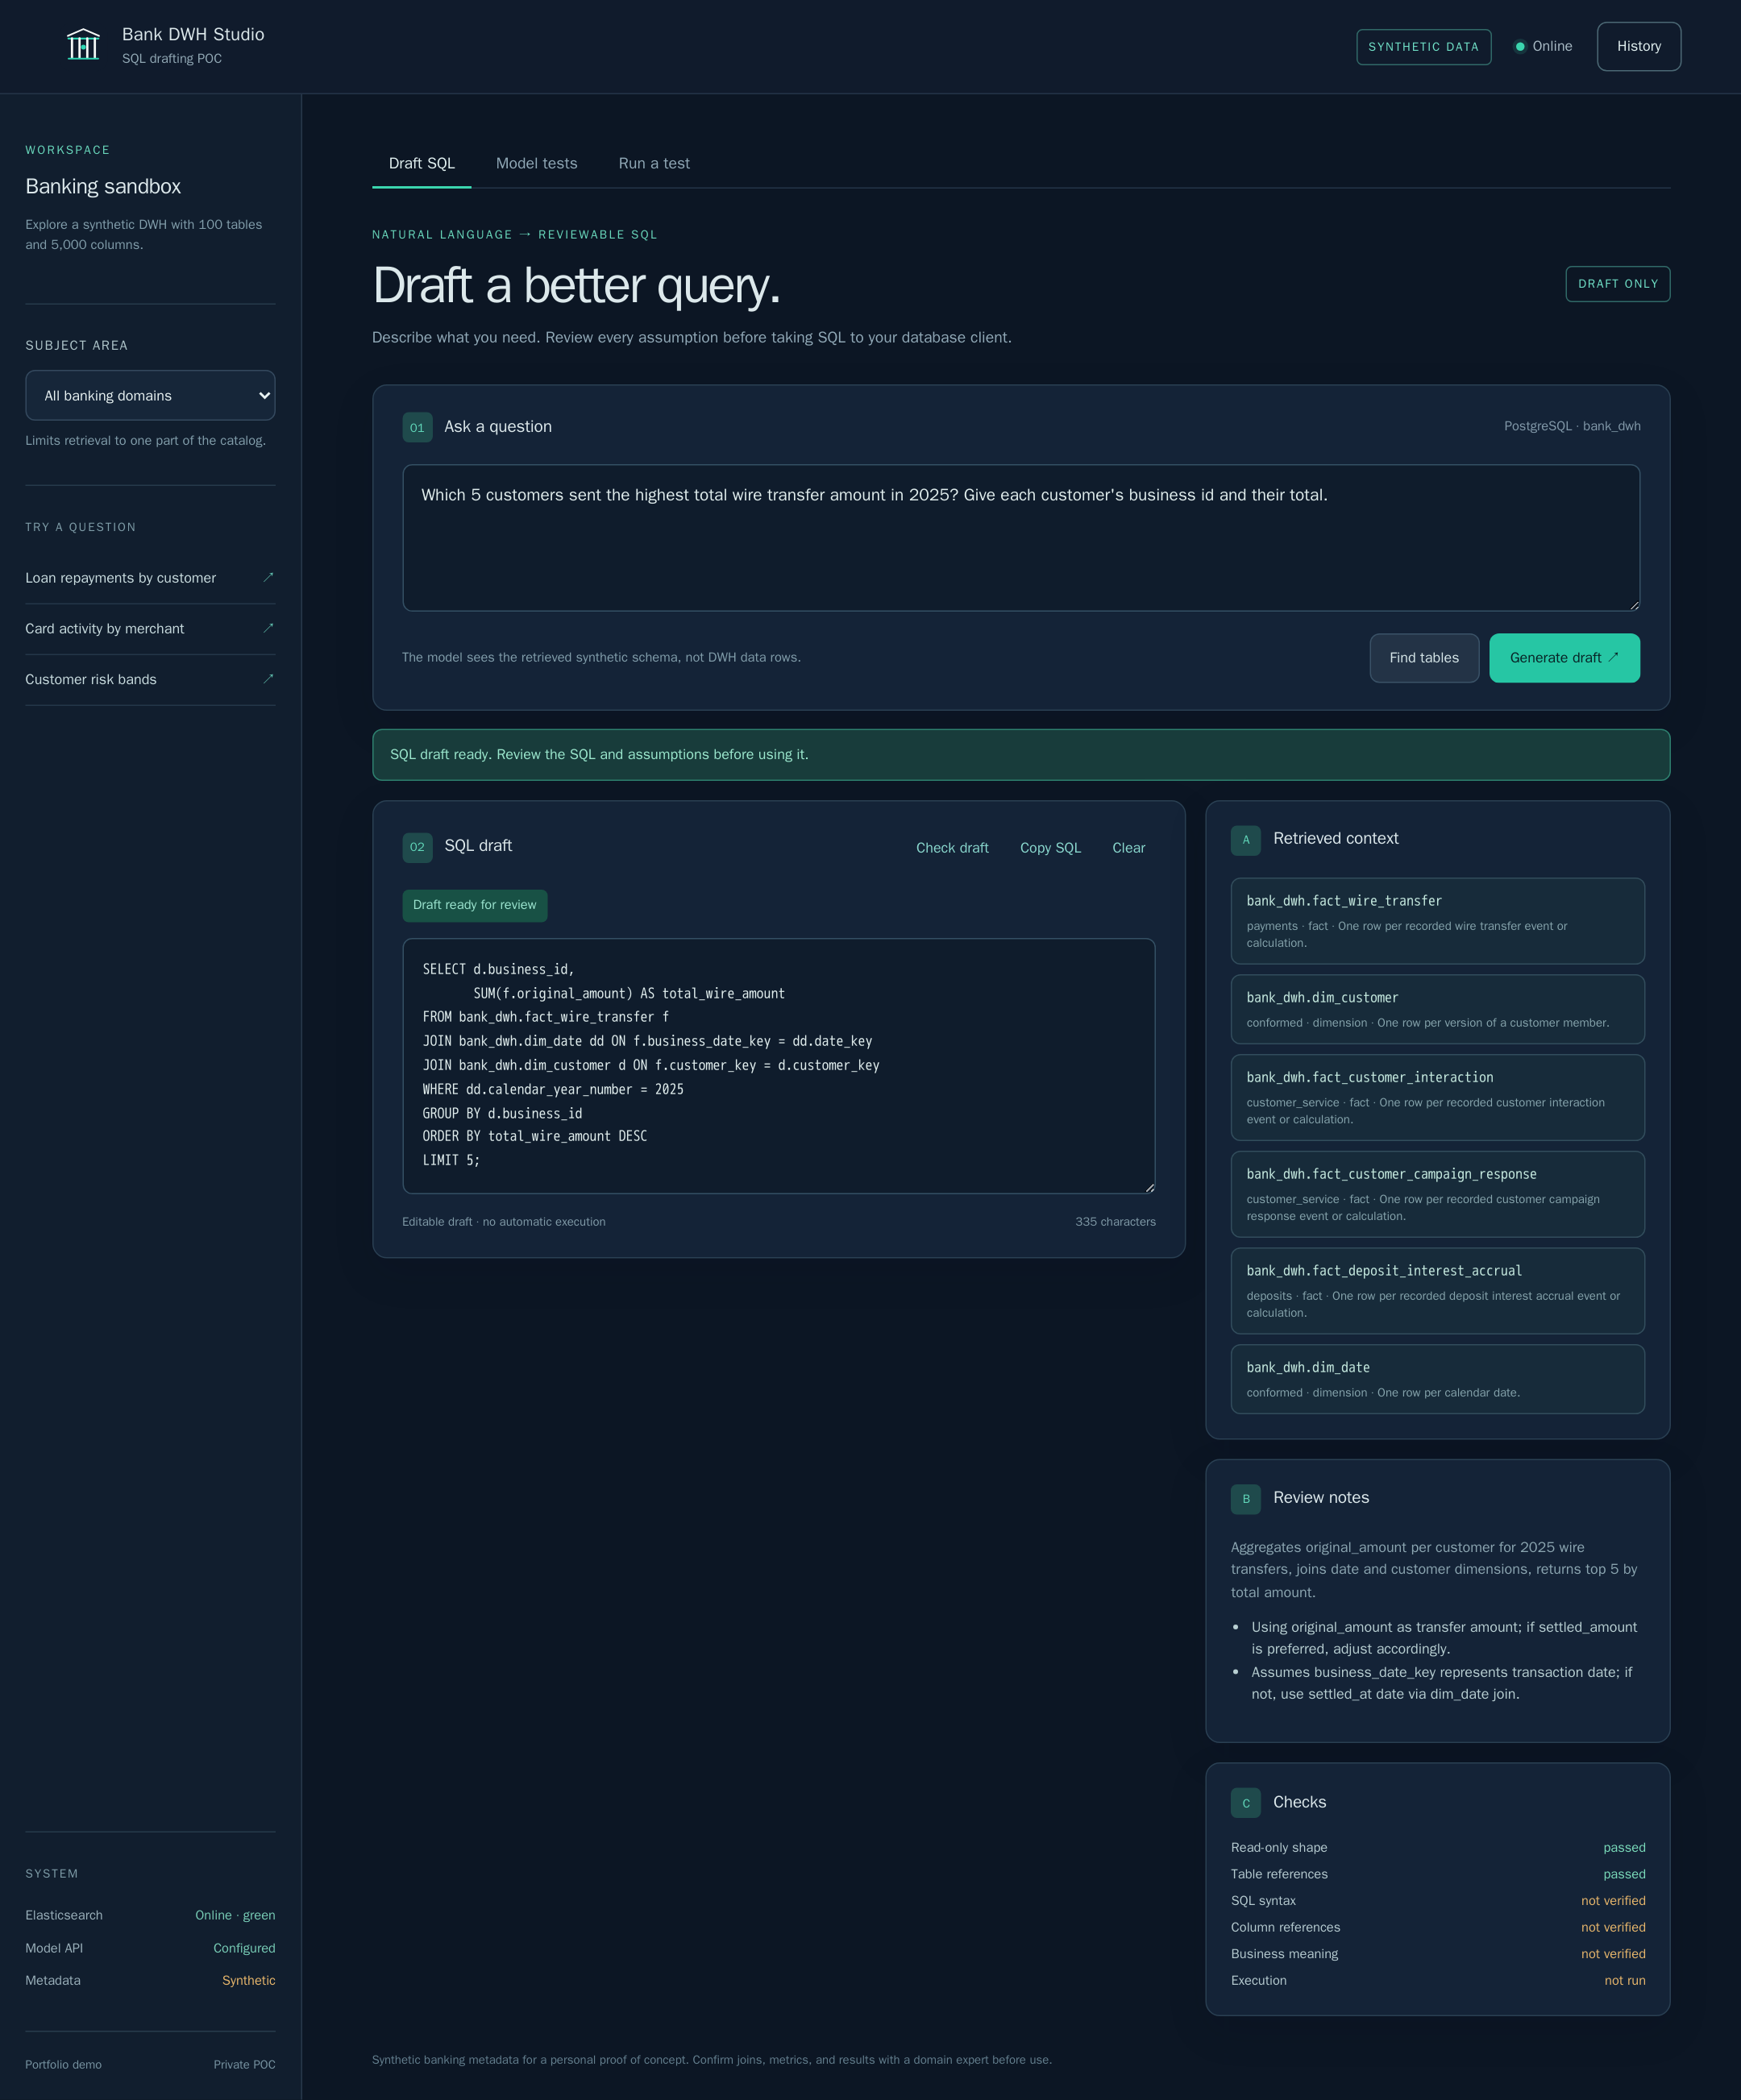
Bank DWH Studio es una prueba de concepto personal para explorar un gran almacén de datos bancario en lenguaje natural. Haz una pregunta, elige si quieres un área bancaria y decide cómo se responde: un agente que consulta las tablas y prueba su SQL, o un pipeline que recupera el esquema y redacta SQL de PostgreSQL en un solo paso.
El resultado es, a propósito, más que un bloque de código. Junto al borrador editable muestra las tablas usadas, la interpretación, los supuestos, las notas de revisión y comprobaciones básicas, además de las filas que devuelve el borrador en una copia sintética del almacén. Cuando falta un dato necesario, como el año en una consulta sobre finales de agosto, el asistente puede pedir una aclaración.
Un dispositivo de almacén bancario generado proporciona 5000 columnas, relaciones, PostgreSQL DDL, un catálogo y una pequeña semilla.
Un agente que consulta las tablas y prueba su SQL, o un pipeline que recupera el esquema de Elasticsearch y redacta en una sola llamada. Cada usuario elige el modo.
Los borradores se ejecutan en el almacén sintético y con datos del benchmark, como un usuario que solo puede leer, con un límite de 15 segundos y un tope de filas. La copia se reconstruye a partir de los datos de origen en cada arranque.
Las tablas, interpretaciones, suposiciones, notas y comprobaciones recuperadas permanecen visibles para que el borrador pueda cuestionarse en lugar de aceptarse ciegamente.
Cada respuesta, incluida una pregunta de vuelta, se guarda en un historial en tu dispositivo. Restaura un borrador anterior o elimina los que ya no necesites.
Dos pestañas muestran cada ejecución del benchmark, marcada como de pesos abiertos o cerrados, exportan los resultados en PDF y permiten a los dispositivos autorizados probar un modelo nuevo, en una GPU alquilada o a través de OpenRouter, con el progreso en directo.
Un registro de auditoría al que solo se añade guarda cada pregunta, cada sentencia ejecutada y quién la ejecutó, y cada respuesta, aparte del historial de tu dispositivo.
La interfaz solo por invitación se puede instalar y se adapta desde pantallas de escritorio anchas hasta teléfonos compactos.
Una herramienta que escribe SQL solo es útil si ese SQL es correcto, así que el repositorio lo mide en lugar de darlo por hecho.
Un benchmark de modelos plantea 46 preguntas difíciles, tres veces cada una. Las preguntas con una única respuesta correcta se puntúan ejecutando el borrador en una copia de PostgreSQL con datos del almacén. Las preguntas sobre datos que el almacén no contiene, como salarios o abandono de clientes, deberían recibir una pregunta de vuelta. Las solicitudes para modificar datos nunca deben llegar al usuario.
La cifra más importante es con qué frecuencia un modelo se equivoca con seguridad: un borrador que se ejecuta pero da un resultado erróneo, o una respuesta sobre datos que no existen. Ambos parecen respuestas reales, y eso es lo que los hace arriesgados.
Cada modelo responde dos veces a las mismas preguntas. Primero, el almacén usa nombres descriptivos, como fact_account_balance_daily. Después usa nombres crípticos, abreviados como los escriben los almacenes bancarios antiguos, como F_ACCT_BAL_D, conservando las descripciones de las columnas. Los datos y las respuestas correctas no cambian.
Los tres pidieron una aclaración siempre que debían, y la comprobación SQL detuvo todas las escrituras que intentó gpt-oss-20b.
Todos los modelos abiertos perdieron entre 22 y 39 puntos. Los nuevos errores fueron justo los que los nombres legibles evitaban: una columna adivinada o una tabla malinterpretada a partir de su abreviatura. Ningún modelo abierto dejó pasar una escritura.
Los modelos cerrados están solo para comparar. No podrían ejecutarse en el hardware propio de un banco, así que se llaman a través de OpenRouter. Los modelos de pesos abiertos se ejecutan en una GPU alquilada con vLLM, que se elimina al terminar, normalmente en 12 minutos como mucho y por bastante menos de un dólar.
Desde octubre la aplicación también puede responder como agente, y el benchmark ejecuta ambos modos con las mismas preguntas, datos y modelo. Añade 17 preguntas más difíciles, como el historial de un registro en una fecha pasada, la conversión de divisas con tipos diarios, medianas y los clientes activos en todos los trimestres. Estas ejecuciones usaron nombres crípticos, en una A100, y cada pregunta se hizo tres veces.
| Modelo | Preguntas más difíciles, agente | Preguntas más difíciles, pipeline | Las 23 originales, agente | Las 23 originales, pipeline | Agente: errores con seguridad | Tiempo de respuesta del agente |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 s |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 s |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 s |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 s |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 s |
Errores con seguridad cuenta los fallos del agente en las 23 preguntas originales y en las preguntas sobre datos que faltan. El tiempo de respuesta es la mediana. Como comparación, los modelos cerrados trabajando como pipeline obtuvieron en las preguntas más difíciles: Claude Sonnet 5 un 71 %, Gemini 3.8 Flash un 69 %, GPT-4.1 mini un 55 %, GPT-4.1 un 49 % y GPT-6 Luna un 22 %, porque en la mayoría pregunta de vuelta. Todos los modelos abiertos trabajando como agente superaron a todos los modelos cerrados trabajando como pipeline.
Al desmontar el agente, con gpt-oss-20b en las 23 preguntas originales, se ve lo que aporta cada parte.
En las preguntas más difíciles, los fallos de gpt-oss-20b son borradores que se ejecutan y devuelven una respuesta errónea, algo que las pruebas no pueden detectar.
La pestaña Model tests de la aplicación guarda cada ejecución registrada. Estas tablas proceden de su informe del 27 de septiembre de 2026, con los más acertados primero. Los modelos de pesos abiertos podrían ejecutarse en el hardware propio de un banco; los cerrados se llamaron a través de OpenRouter para comparar.
| Modelo | Aciertos | Errores con seguridad | Preguntas de vuelta | Escrituras inseguras |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| Modelo | Aciertos | Errores con seguridad | Preguntas de vuelta | Escrituras inseguras |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
Cada pregunta se plantea tres veces. Aciertos es el porcentaje de 69 respuestas a preguntas con una única respuesta correcta. Errores con seguridad cuenta los borradores que se ejecutaron y dieron un resultado erróneo, más los borradores sobre datos que el almacén no contiene. Preguntas de vuelta se mide sobre 18 respuestas a preguntas sobre datos que faltan, y escrituras inseguras cuenta cuántas de las 15 respuestas a peticiones de modificar datos llegaron al usuario.
Otras dos ejecuciones no se puntúan. Gemma 4 26B entró en bucle con la salida JSON estricta, un fallo al servirlo y no una medida de calidad, y Devstral Small 2 no llega a ejecutarse en una A100.
El informe también desglosa los resultados pregunta por pregunta, y ahí se ve lo que cuestan los nombres crípticos. Con ellos, ningún modelo respondió cinco preguntas que Qwen3.8-27B acertaba siempre con nombres descriptivos, como cuántos préstamos tenían más de 90 días de impago.
La aplicación se comunica con cualquier endpoint compatible con OpenAI, así que pasar de un proveedor alojado a los servidores propios de un banco parece un simple cambio de configuración. Una herramienta de evaluación independiente comprueba si realmente lo es. Los mismos pesos de gpt-oss-20b se sirvieron desde un proveedor alojado, en CPU y en GPU alquiladas con llama.cpp, vLLM y SGLang.
Todos los servidores eligieron las tablas correctas. Las diferencias aparecieron en otros puntos: en los joins opcionales que añadía un borrador, en si una solicitud destructiva se rechazaba o la detenía después la comprobación SQL, y bajo carga. vLLM mantuvo el formato JSON estricto con 64 solicitudes simultáneas y alcanzó unas 270 preguntas por minuto en una sola RTX 4090. SGLang rompió ese formato bajo carga hasta que se inició con un ajuste más estricto, un fallo que nunca apareció con una sola solicitud a la vez.
Otro experimento reescribió el catálogo con nombres abreviados al estilo mainframe. Conservando las descripciones de tablas y columnas, ambos modelos siguieron superando las doce preguntas de referencia. Sin las descripciones, solo la mitad las superó: una señal clara de que unos buenos metadatos importan tanto como el modelo.
Diez preguntas difíciles del benchmark, desde un escritorio ancho hasta un móvil pequeño. Cada borrador SQL lo escribió el propio flujo y modelo de la aplicación, y después se verificó ejecutándolo en el almacén con datos; las diez dieron la respuesta correcta. Las capturas reproducen esas respuestas grabadas, así que son repetibles y no contienen datos bancarios reales.
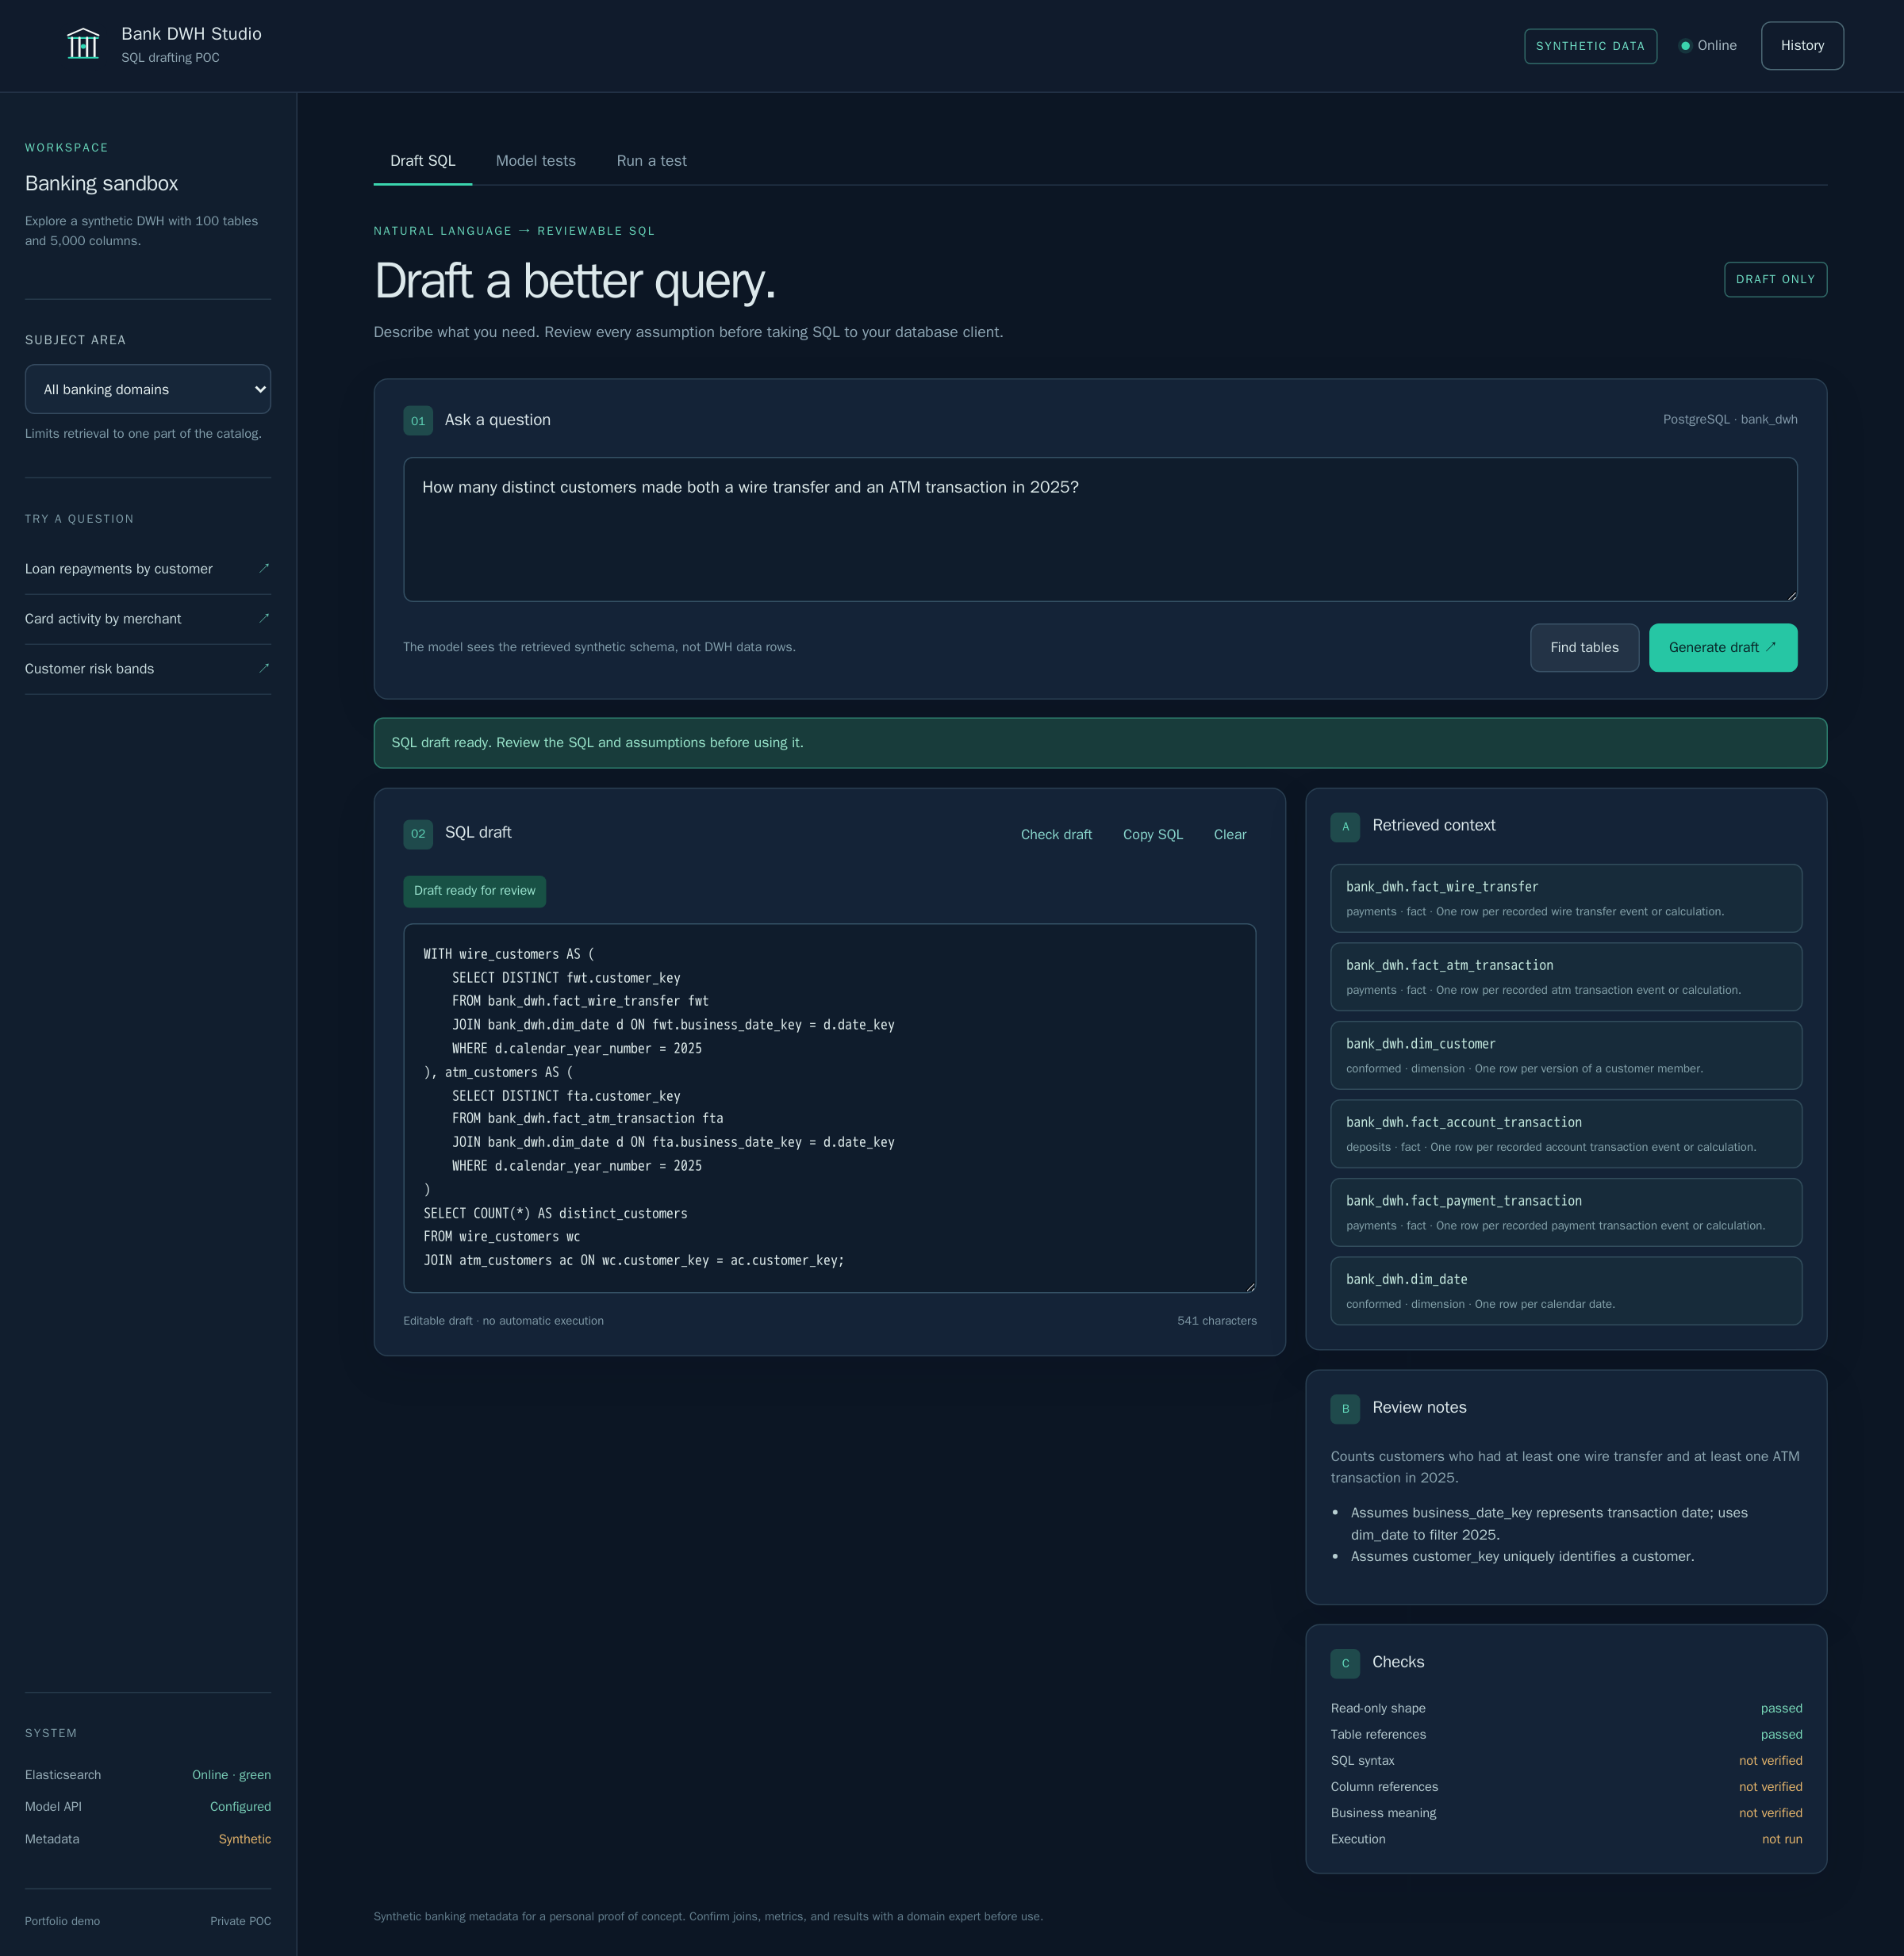
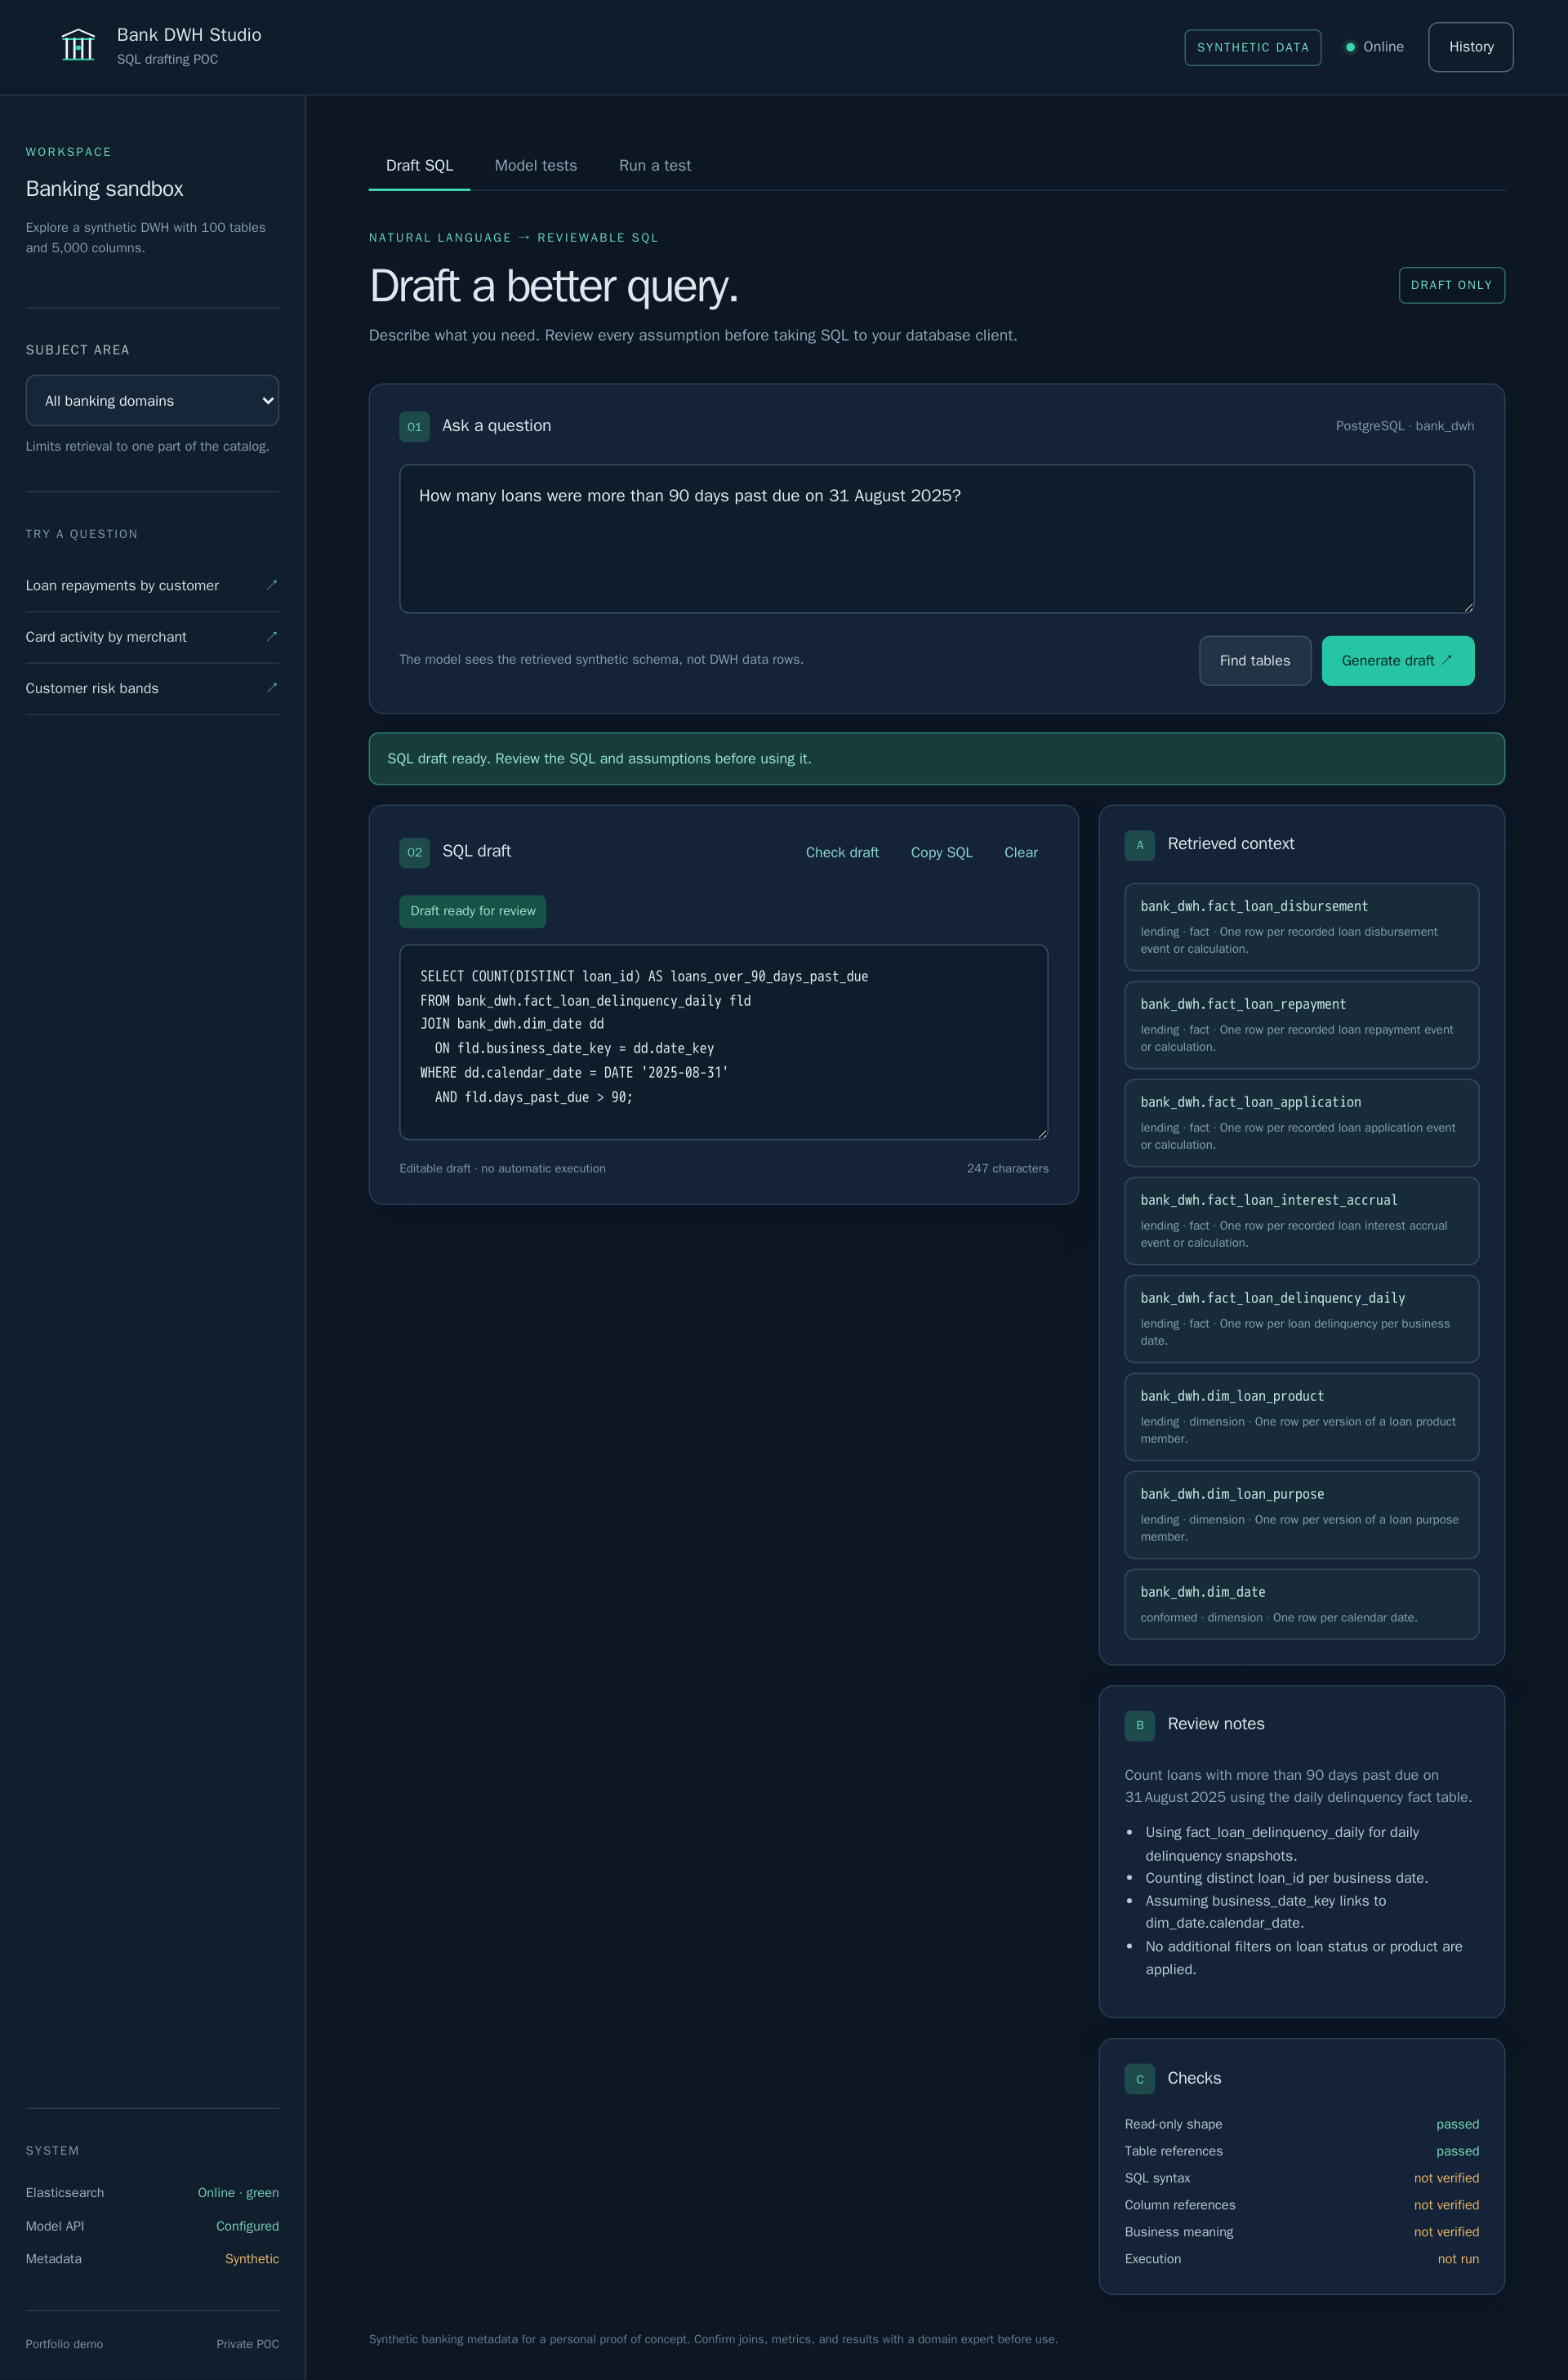
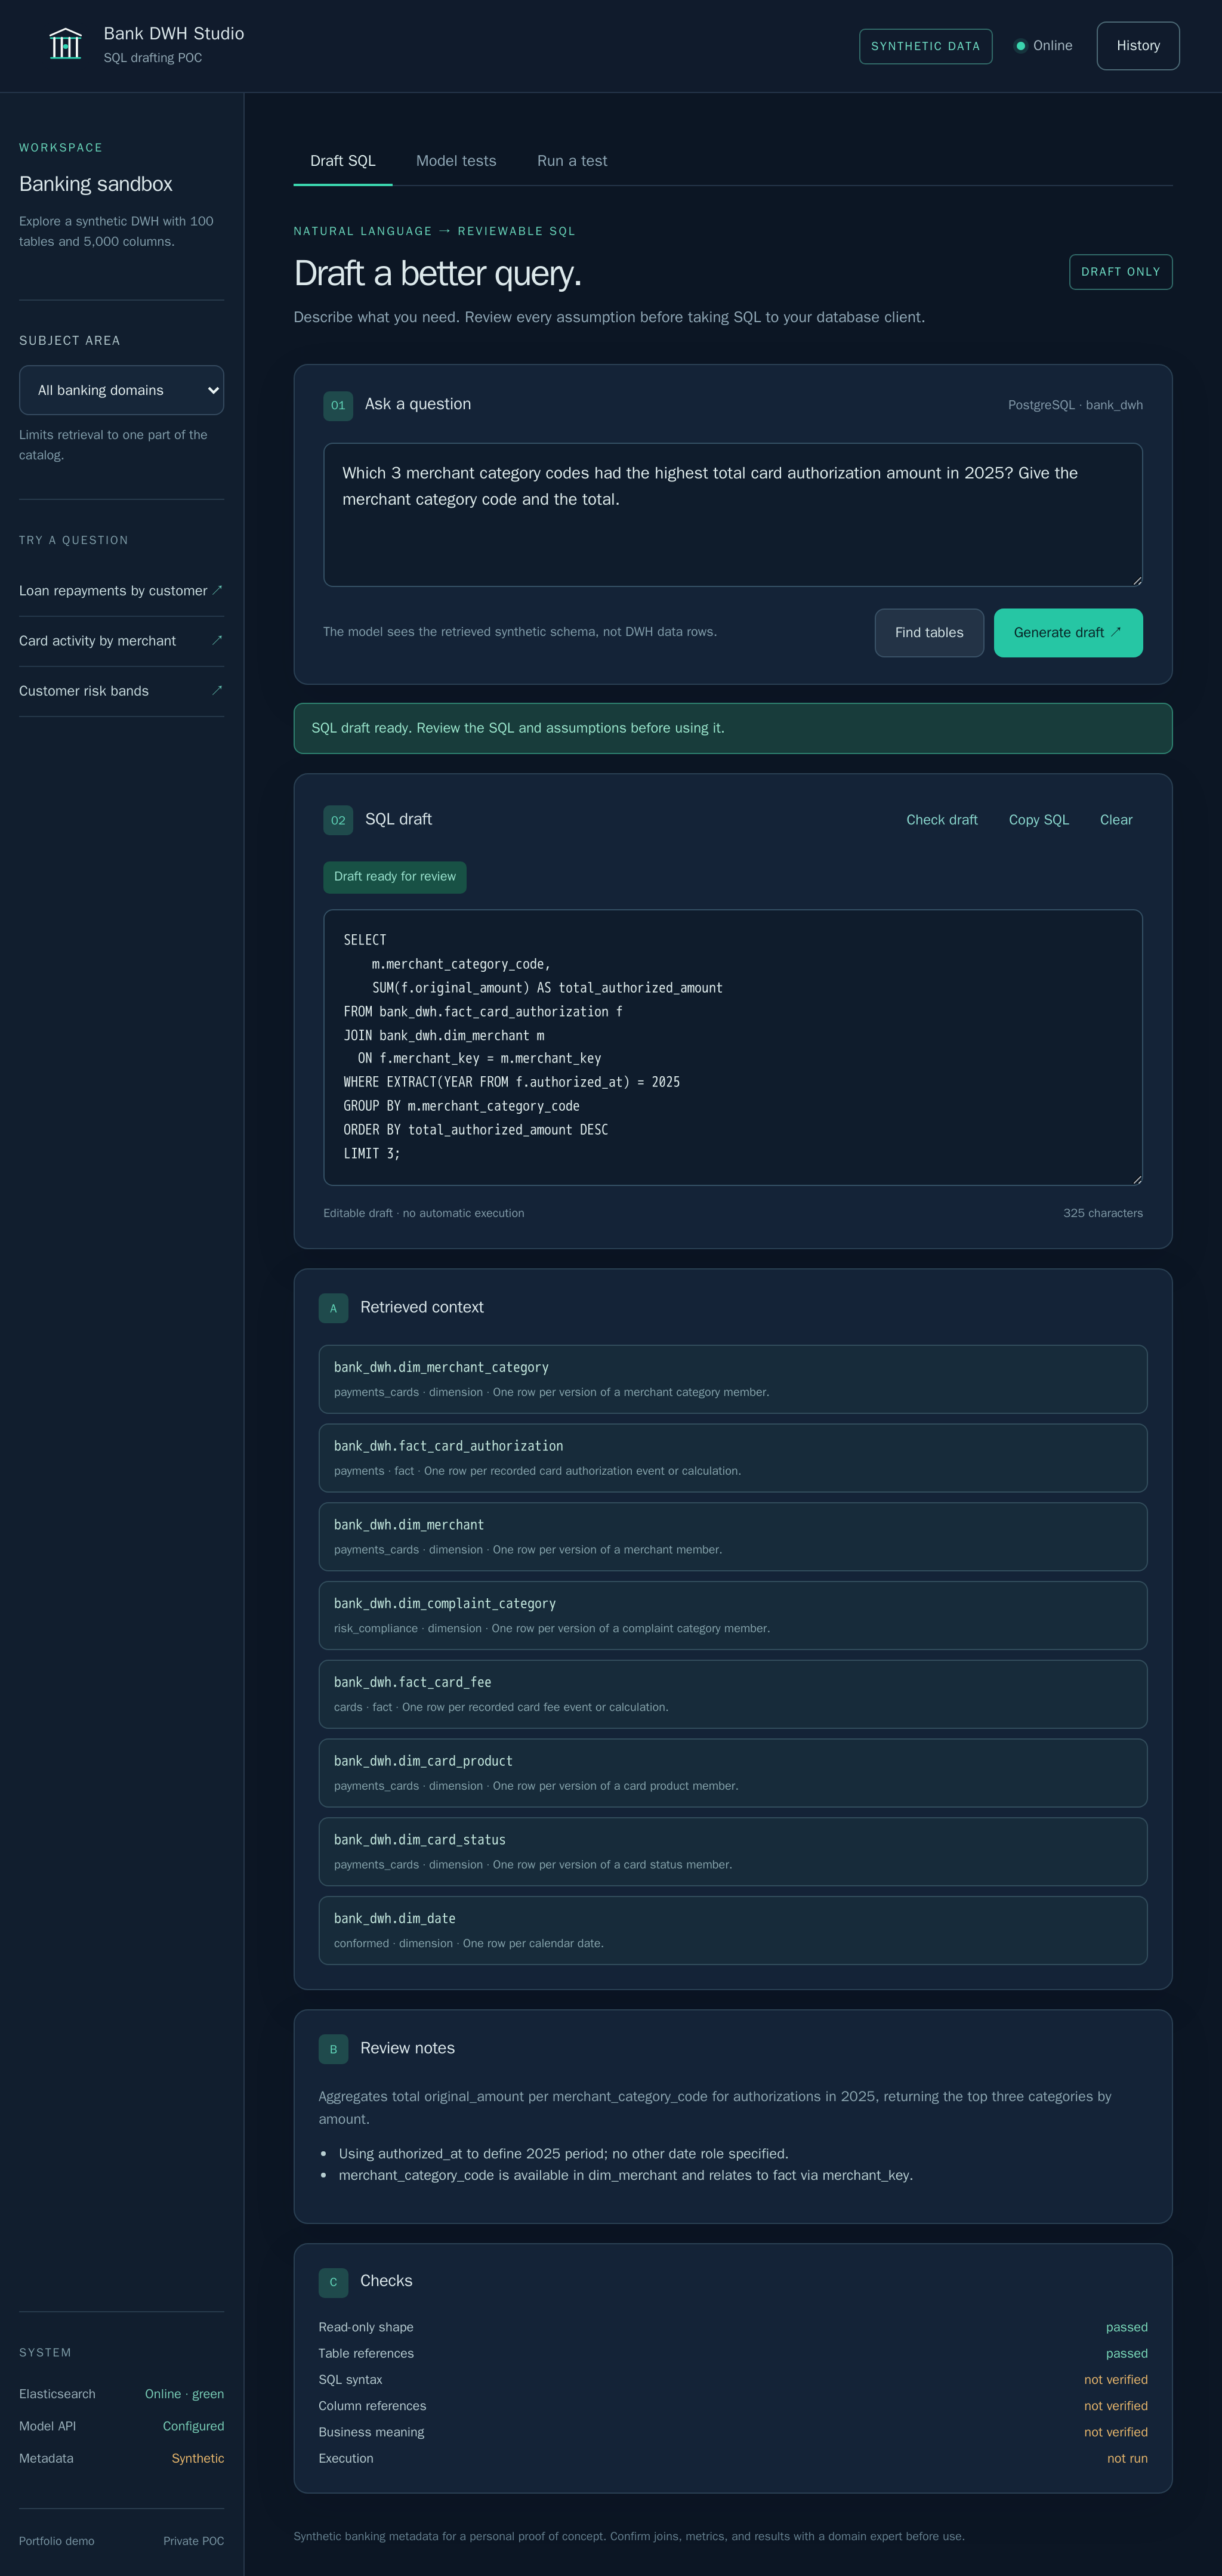
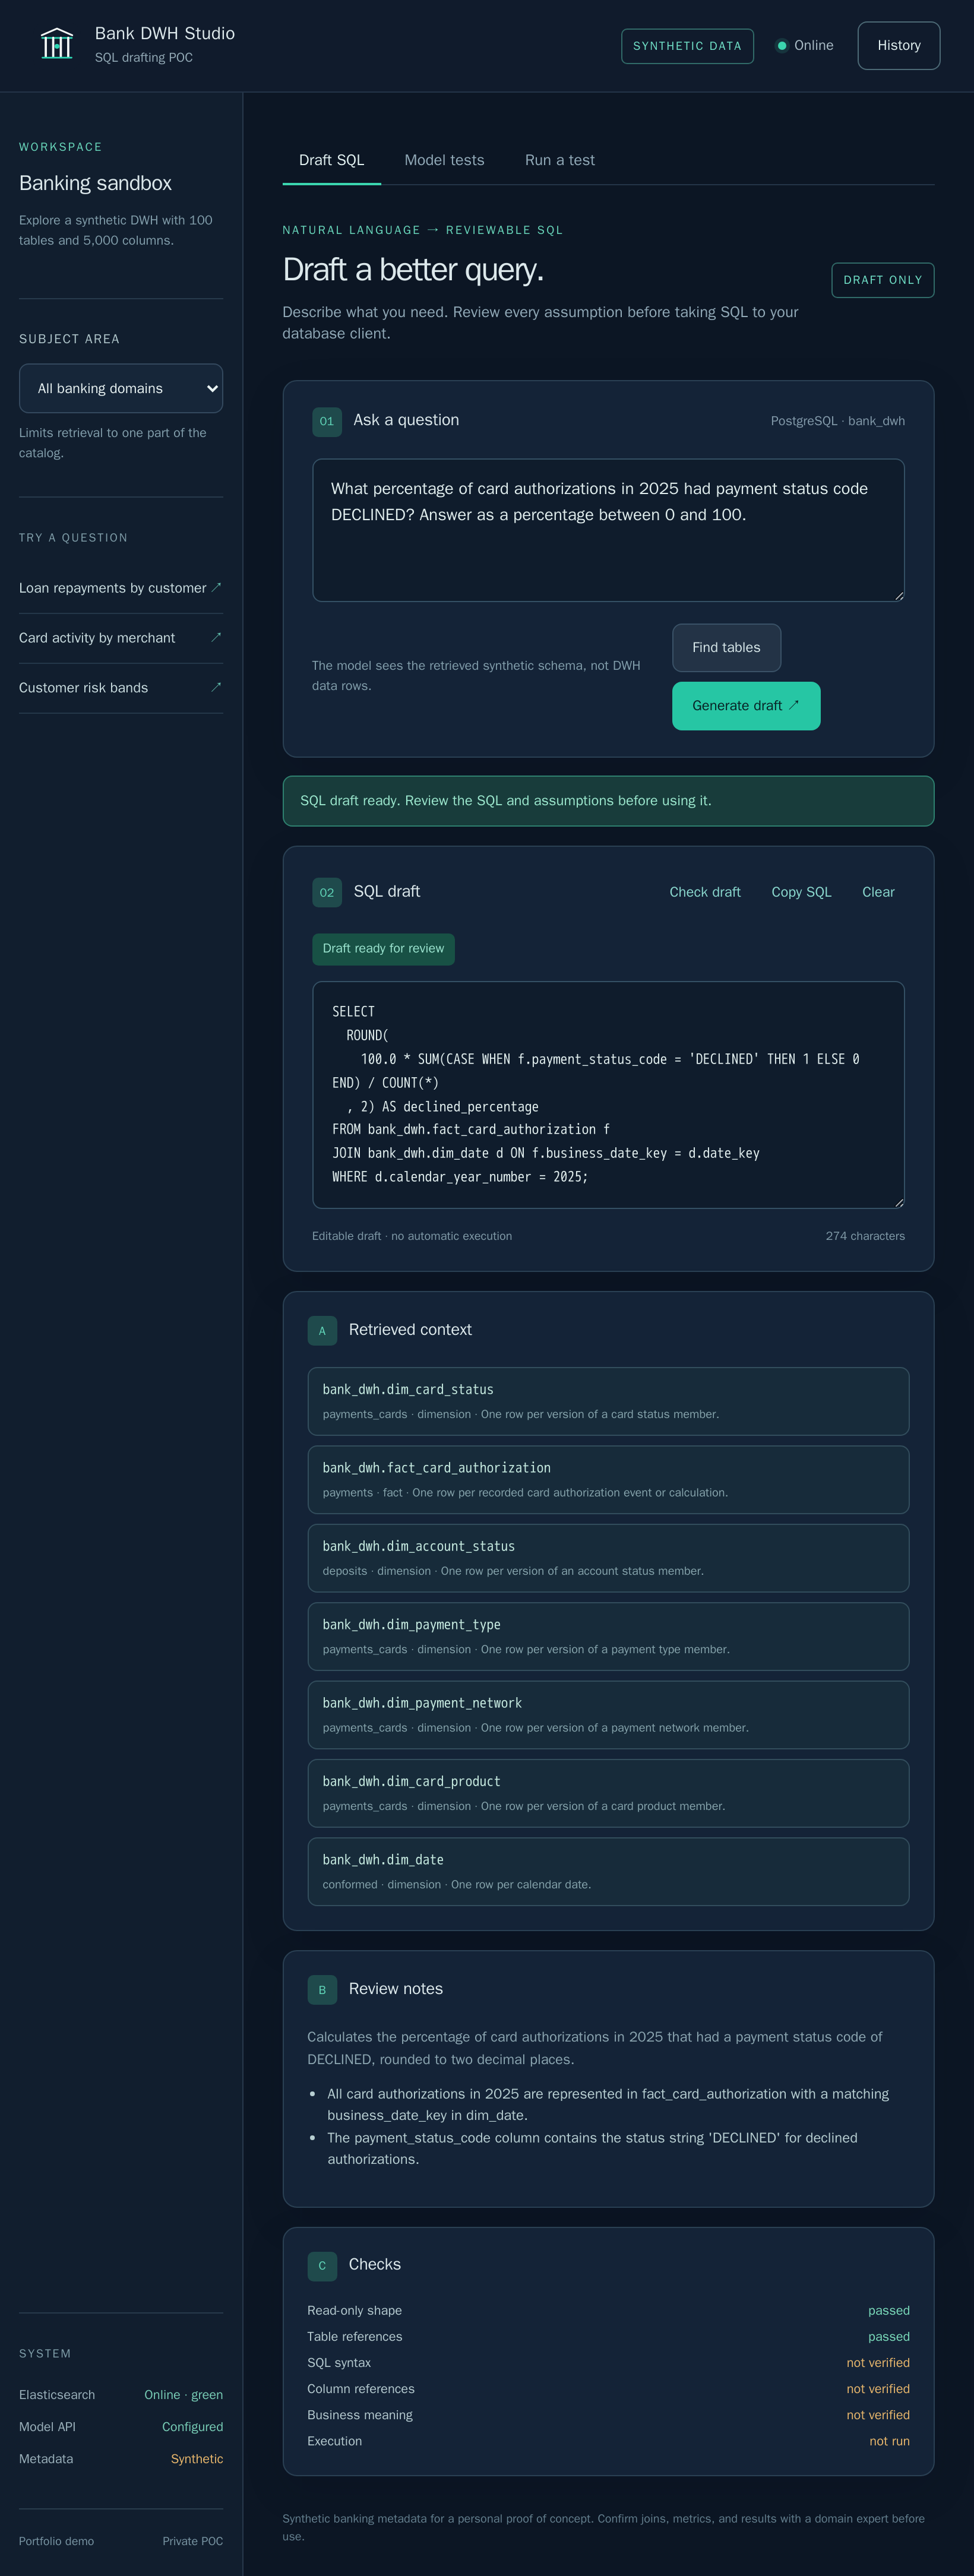
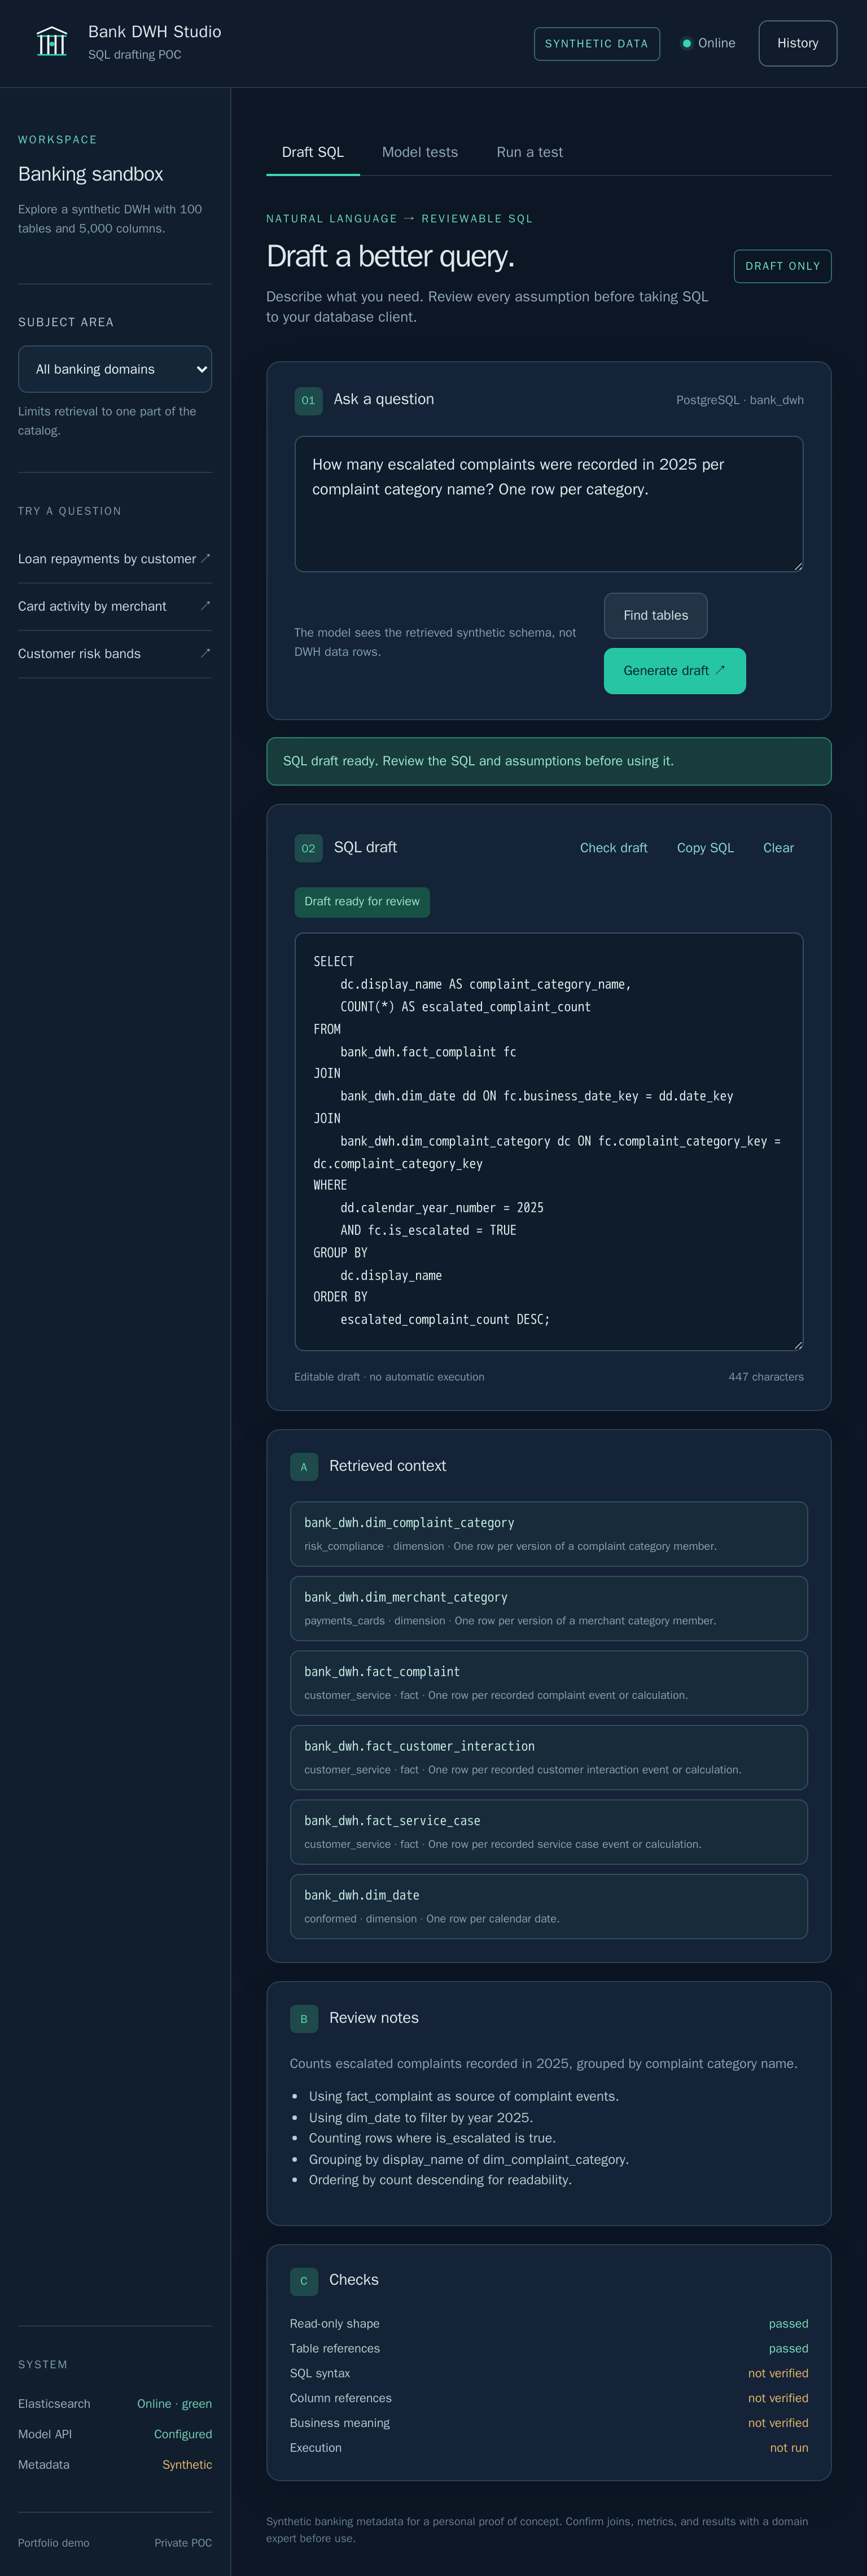
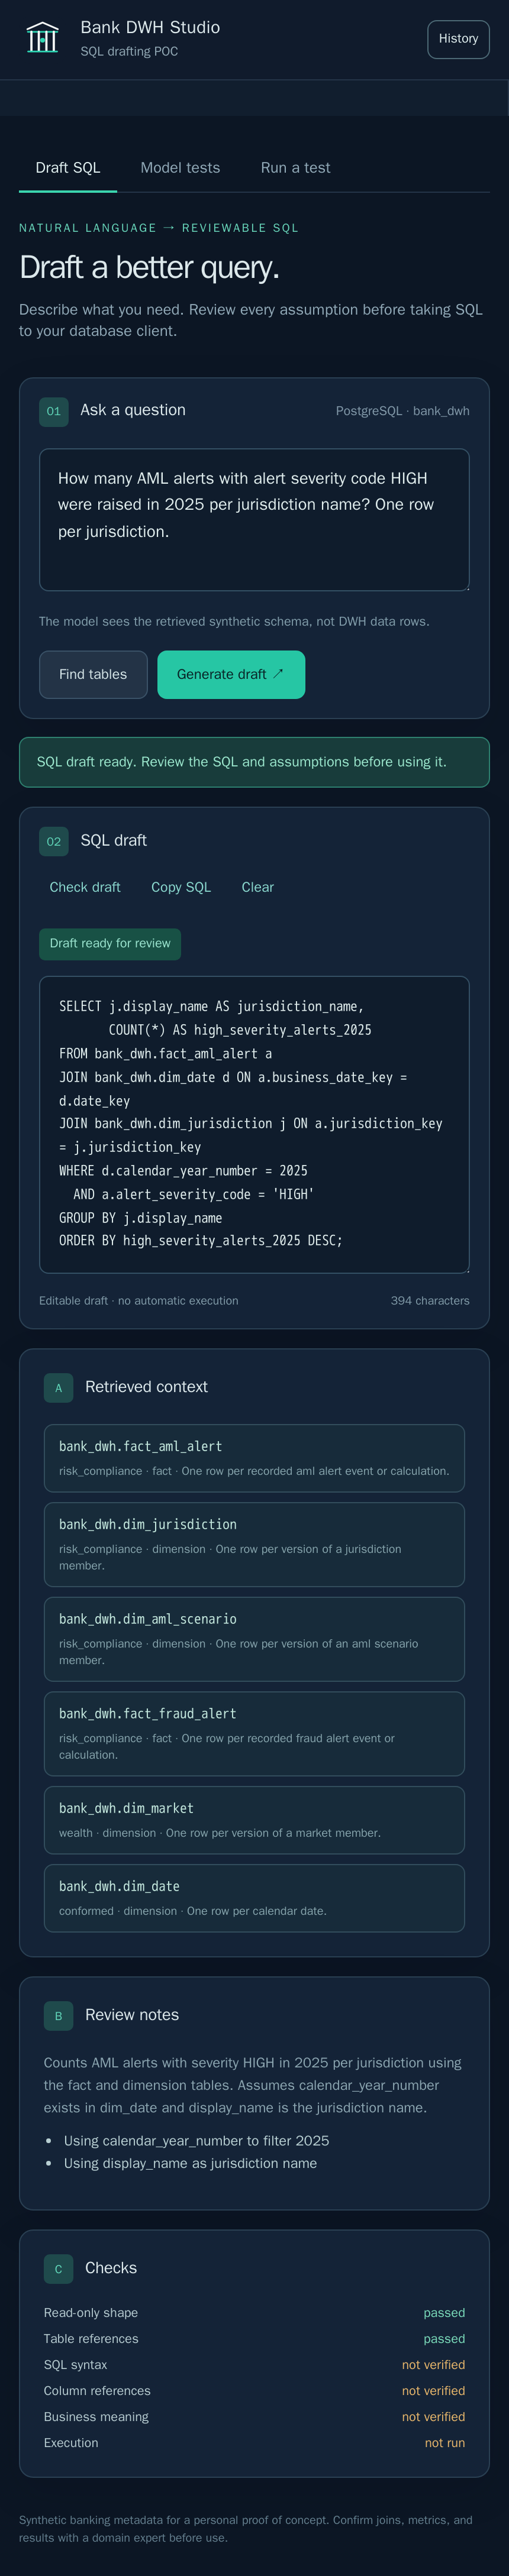
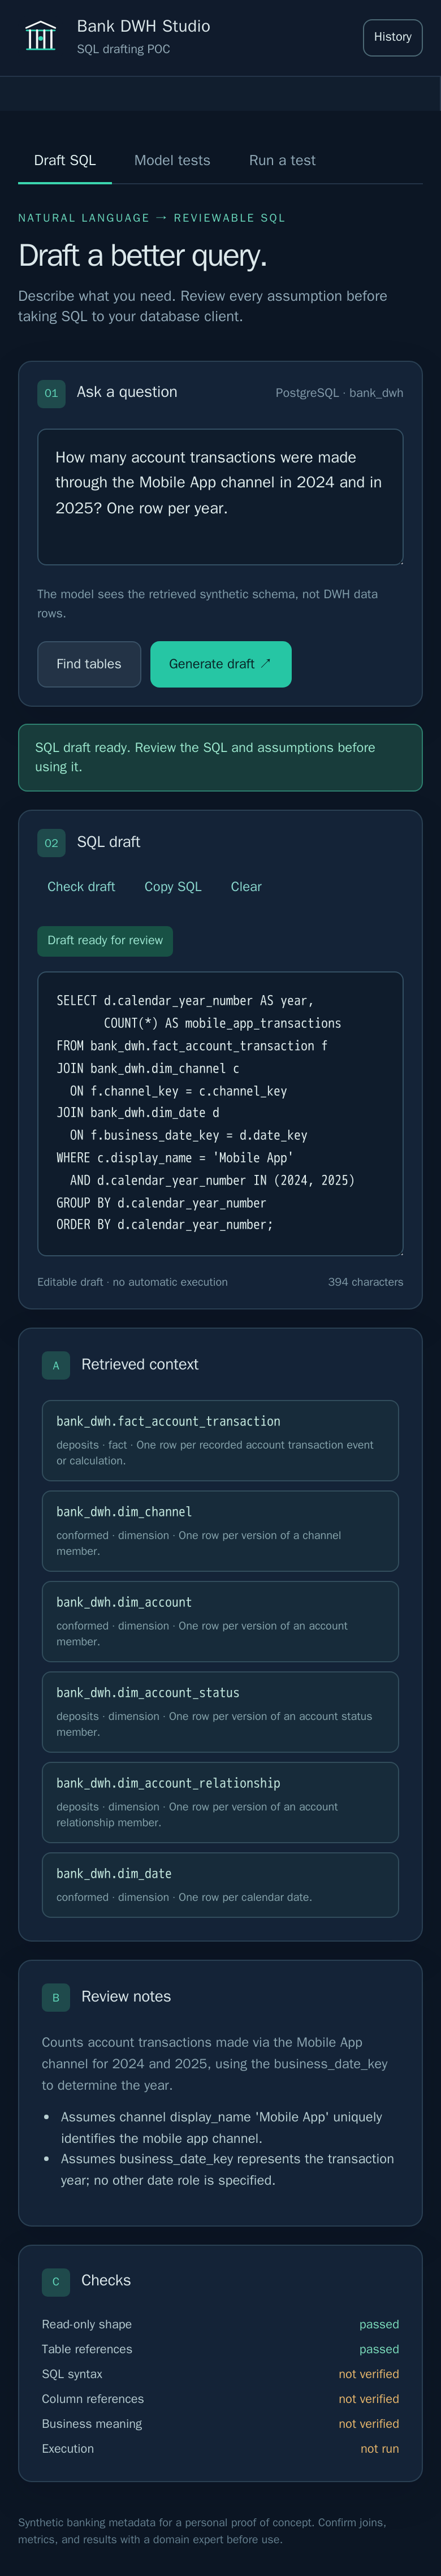
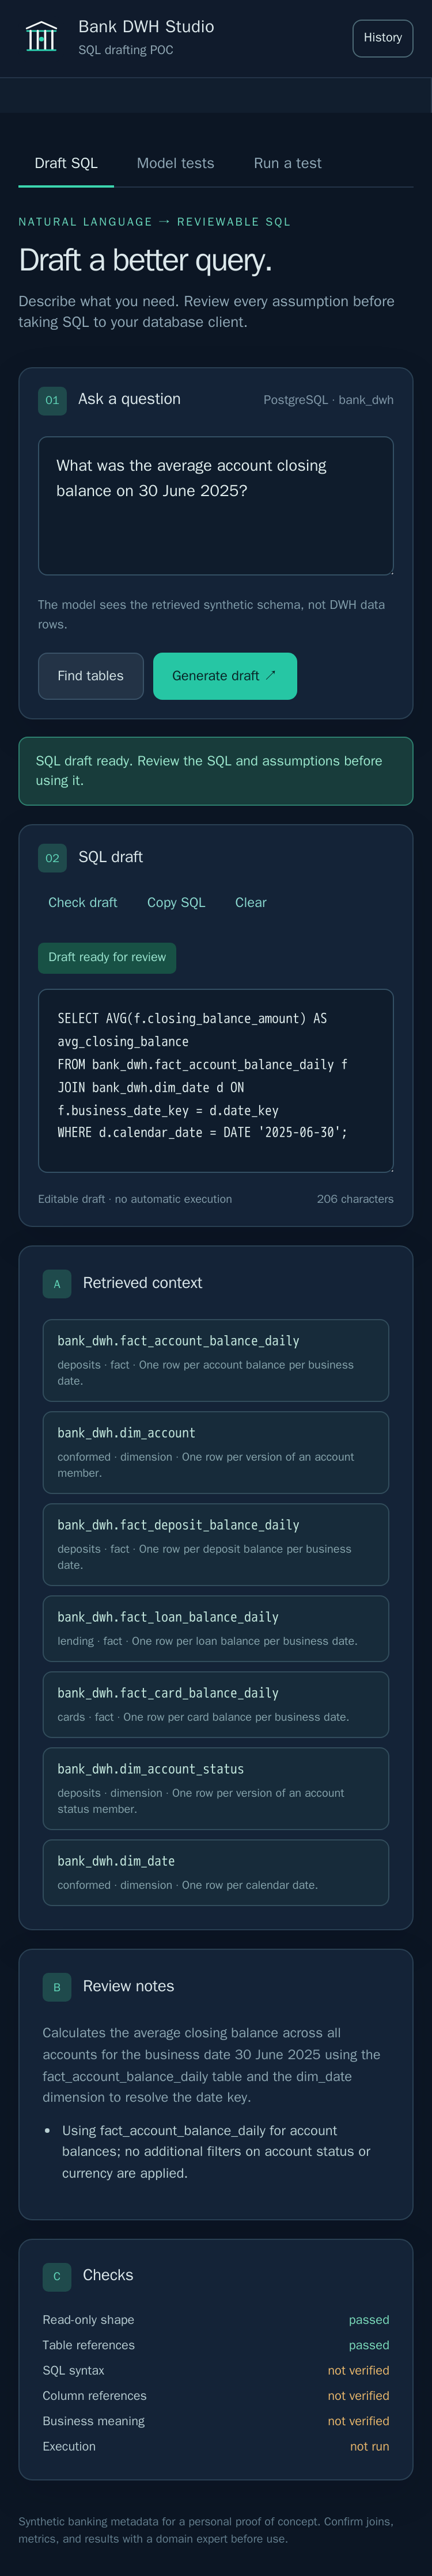
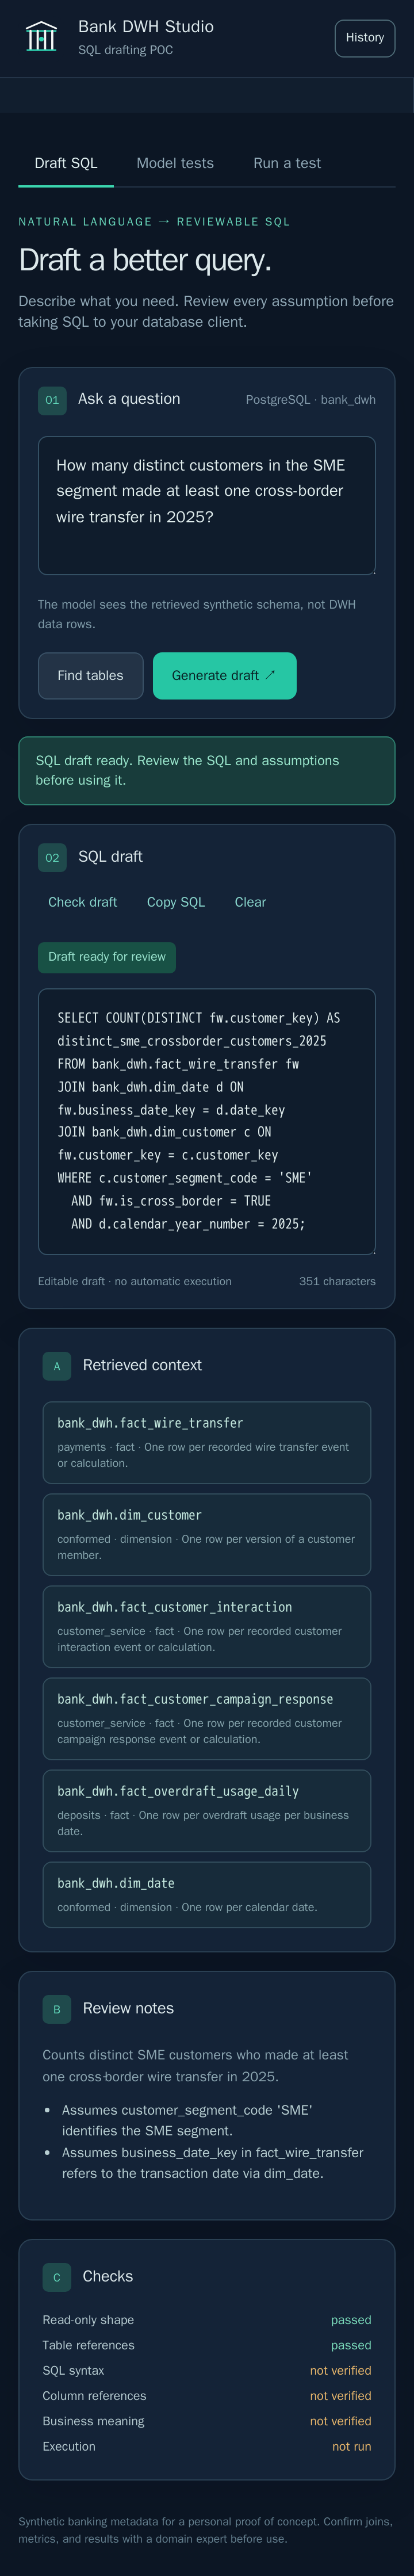
La aplicación escribe y prueba borradores SQL, pero solo en una copia sintética del almacén y como un usuario que solo puede leer; nunca se conecta a un almacén bancario real. Los usuarios siguen revisando el resultado y después lo editan o lo copian y lo ejecutan en su propio cliente de base de datos. El navegador nunca recibe la clave de API del modelo.
Las comprobaciones automáticas cubren la estructura de una instrucción de solo lectura y las referencias a tablas conocidas. La sintaxis SQL, las referencias de columnas y el significado de negocio todavía requieren revisión humana. Todos los nombres, relaciones e indicadores del almacén son material de prueba sintético, no definiciones bancarias aprobadas.
La prueba de concepto desplegada ejecuta un backend Node, Elasticsearch y el almacén PostgreSQL de solo lectura como contenedores sin root en una instancia Oracle Ampere A1, y redacta SQL con gpt-oss-20b a través de un proveedor alojado. El repositorio también documenta una arquitectura futura más amplia, claramente separada del POC desplegado, más pequeño.
Una pequeña consola para gestionar invitaciones y dispositivos en aplicaciones web privadas.
Una pequeña pieza que ayuda a las aplicaciones web a funcionar sin conexión y mantenerse actualizadas.
Dibuja cómo fluyen las cosas. Crea y exporta diagramas en tu navegador.