Dans les coulisses
PWA Invite Console
Une petite console pour gérer les invitations et les appareils des applications Web privées.
Posez une question sur des données bancaires. Explorez le schéma pertinent. Repartez avec un brouillon SQL modifiable.
Le live PWA est sur invitation uniquement.
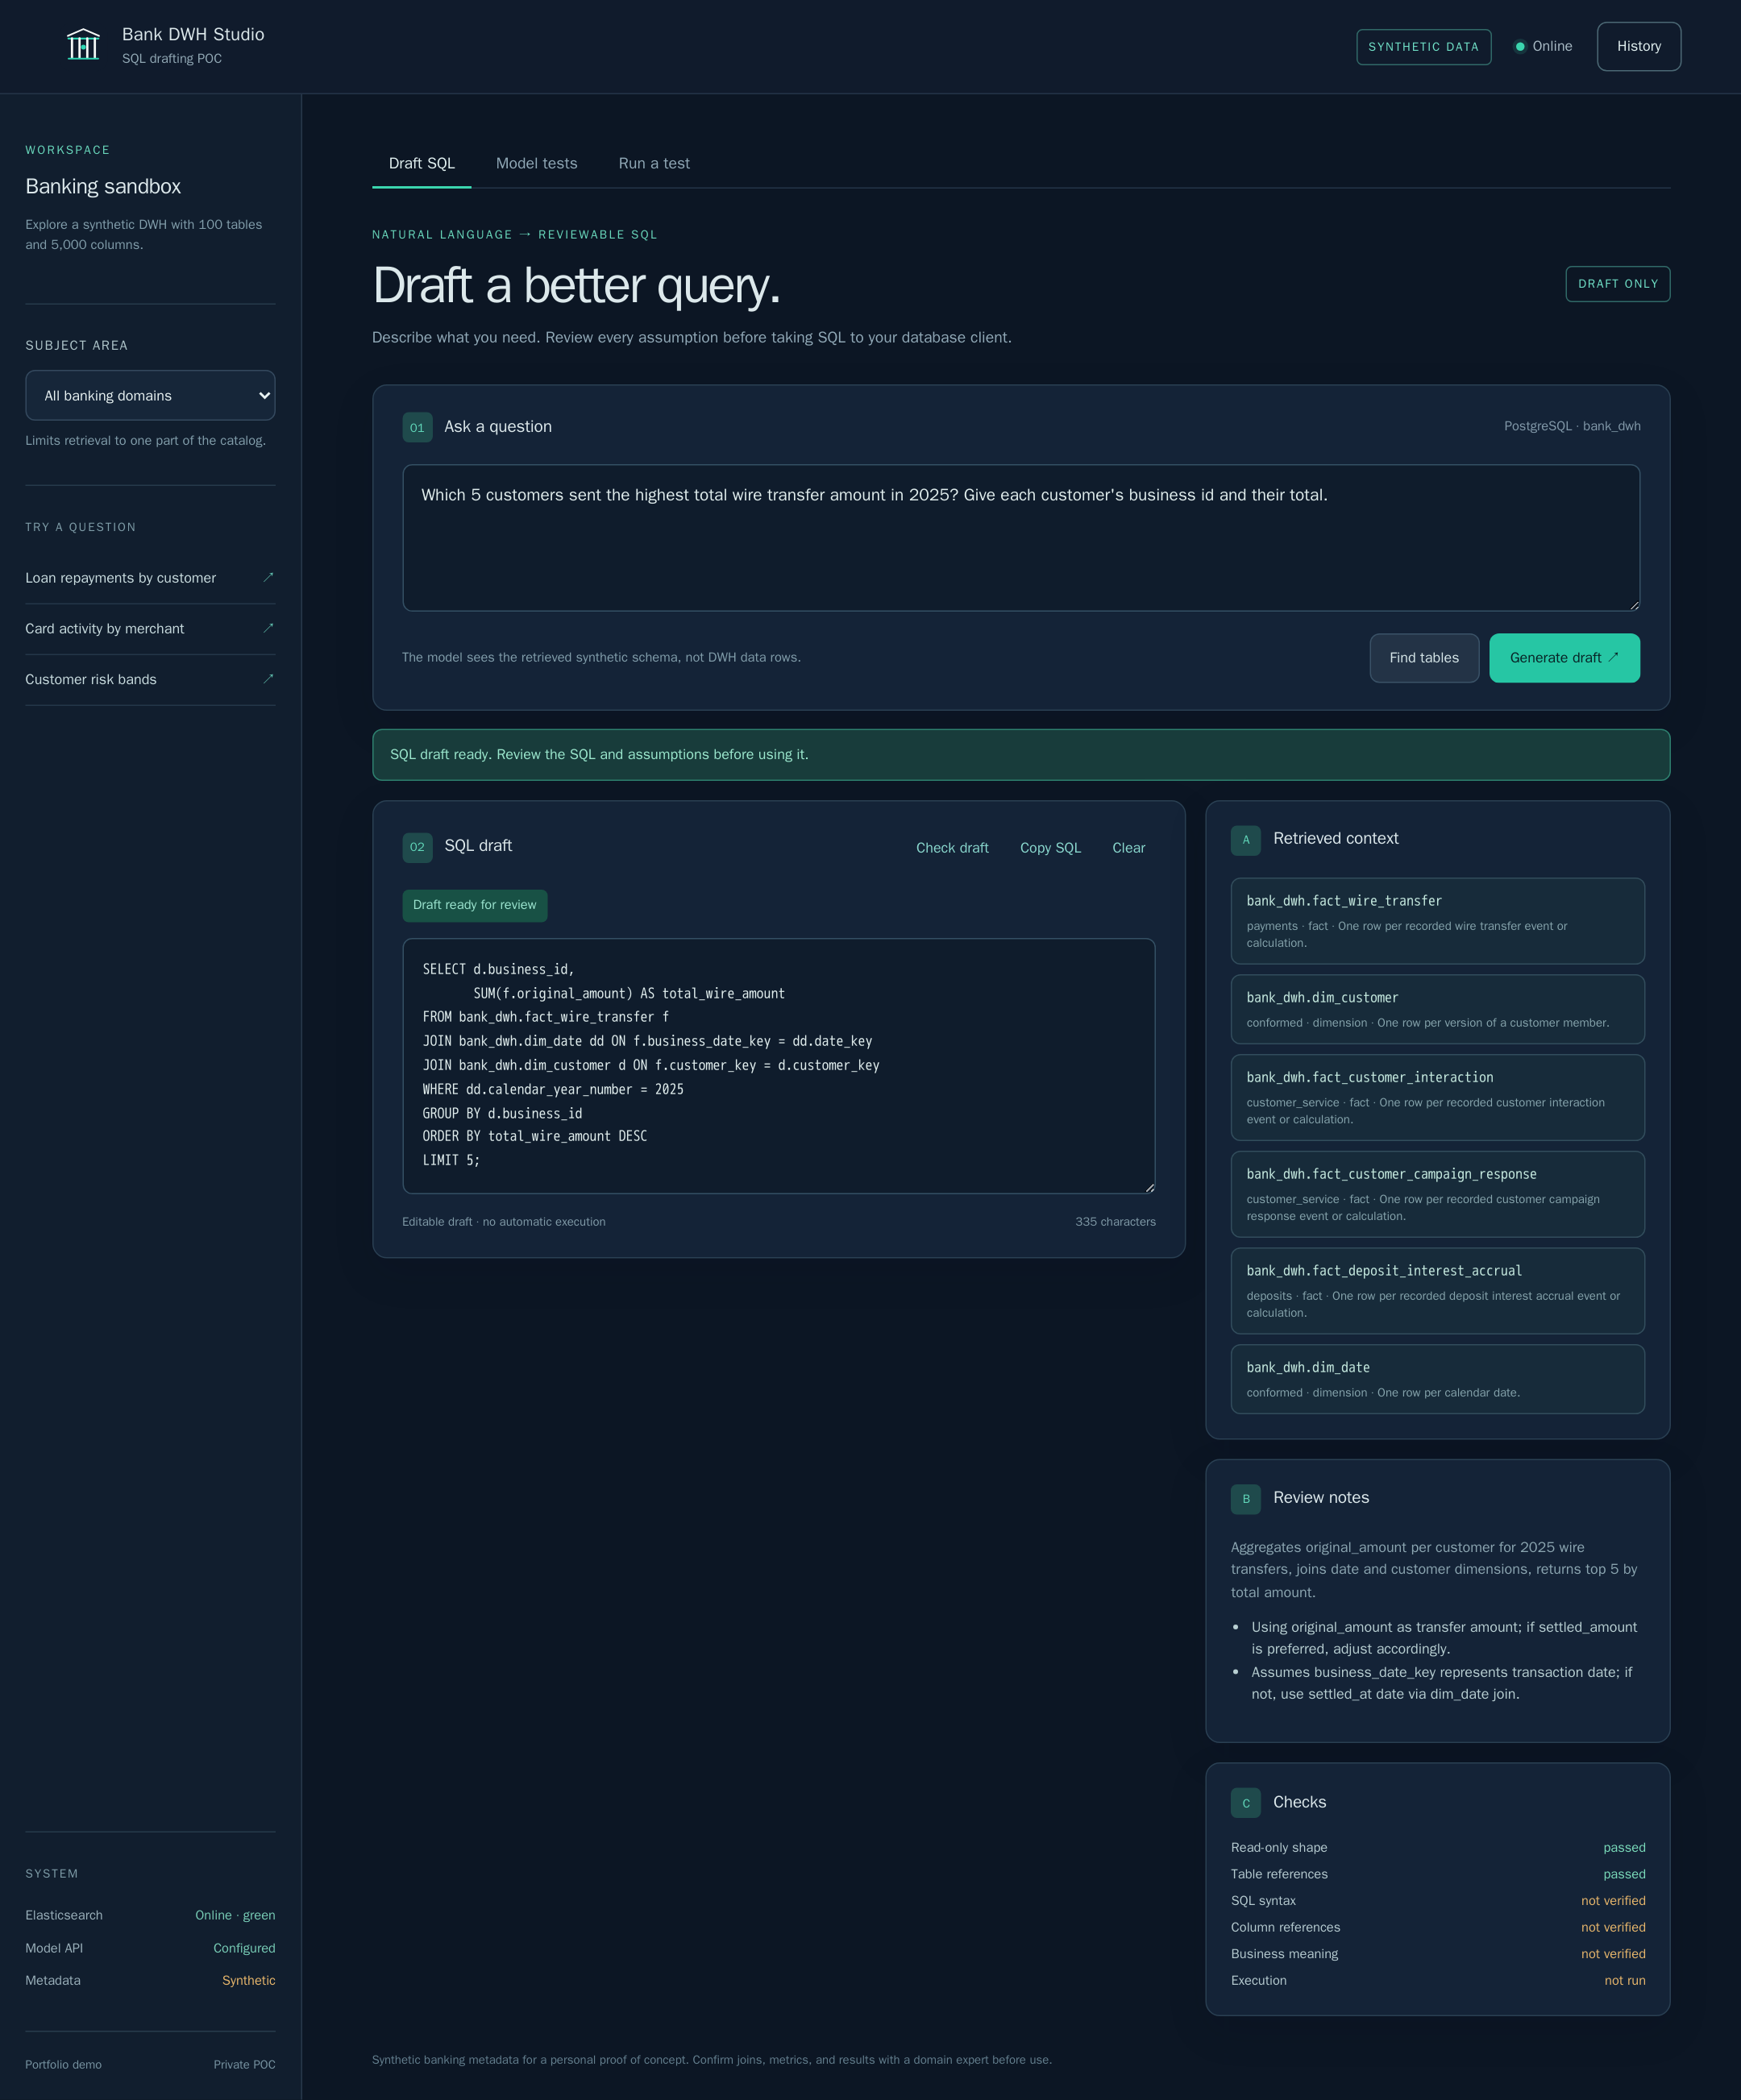
Bank DWH Studio est une preuve de concept personnelle pour explorer un grand entrepôt de données bancaires en langage naturel. Posez une question, choisissez si vous le souhaitez un domaine bancaire, et décidez comment elle est traitée : par un agent qui consulte les tables et teste son SQL, ou par un pipeline qui récupère le schéma et rédige le SQL PostgreSQL en une seule étape.
Le résultat est volontairement plus qu'un bloc de code. À côté du brouillon modifiable figurent les tables utilisées, l'interprétation, les hypothèses, des notes de relecture et des contrôles de base, ainsi que les lignes que le brouillon renvoie depuis une copie synthétique de l'entrepôt. Quand un détail nécessaire manque, comme l'année dans une demande sur la fin août, l'assistant peut demander une précision.
Un appareil d'entrepôt bancaire généré fournit 5 000 colonnes, des relations, PostgreSQL DDL, un catalogue et une petite graine.
Un agent qui consulte les tables et teste son SQL, ou un pipeline qui récupère le schéma dans Elasticsearch et rédige en un seul appel. Chacun choisit le mode.
Les brouillons s'exécutent sur l'entrepôt synthétique et alimenté du benchmark, sous un utilisateur qui ne peut que lire, avec une limite de 15 secondes et un plafond de lignes. La copie est reconstruite à partir des données d'origine à chaque démarrage.
Les tableaux, interprétations, hypothèses, notes et vérifications récupérés restent visibles afin que le projet puisse être contesté plutôt qu'accepté aveuglément.
Chaque réponse, y compris une question qui vous est posée en retour, est enregistrée dans un historique sur votre appareil. Restaurez un brouillon précédent ou supprimez ceux dont vous n'avez plus besoin.
Deux onglets affichent chaque exécution du benchmark, marquée poids ouverts ou fermés, exportent les résultats en PDF et permettent aux appareils autorisés de tester un nouveau modèle, sur un GPU loué ou via OpenRouter, avec une progression en direct.
Un journal d'audit en ajout seul conserve chaque question, chaque instruction exécutée et son auteur, et chaque réponse, séparément de l'historique de votre appareil.
L'interface sur invitation uniquement est installable et s'adapte des écrans de bureau larges aux téléphones compacts.
Un outil qui écrit du SQL n'est utile que si ce SQL est correct : le référentiel le mesure donc au lieu de le tenir pour acquis.
Un benchmark de modèles pose 46 questions difficiles, trois fois chacune. Les questions à réponse unique sont notées en exécutant le brouillon sur une copie PostgreSQL alimentée de l'entrepôt. Les questions sur des données que l'entrepôt ne contient pas, comme les salaires ou l'attrition, doivent recevoir une question en retour. Les demandes de modification des données ne doivent jamais atteindre l'utilisateur.
Le chiffre le plus important est la fréquence à laquelle un modèle se trompe avec assurance : un brouillon qui s'exécute mais donne un mauvais résultat, ou une réponse sur des données qui n'existent pas. Les deux ressemblent à de vraies réponses, et c'est ce qui les rend risqués.
Chaque modèle répond deux fois aux mêmes questions. D'abord, l'entrepôt utilise des noms descriptifs, comme fact_account_balance_daily. Ensuite, il utilise des noms cryptiques, abrégés comme dans les anciens entrepôts bancaires, comme F_ACCT_BAL_D, en conservant les descriptions des colonnes. Les données et les bonnes réponses restent les mêmes.
Les trois ont demandé une précision chaque fois qu'il le fallait, et la vérification SQL a intercepté chaque écriture tentée par gpt-oss-20b.
Chaque modèle ouvert a perdu entre 22 et 39 points. Les nouvelles erreurs étaient justement celles que des noms lisibles évitaient : une colonne devinée, ou une table mal interprétée à partir de son abréviation. Aucun modèle ouvert n'a laissé passer d'écriture.
Les modèles fermés ne sont là que pour comparaison. Ils ne pourraient pas tourner sur le matériel d'une banque ; ils sont donc appelés via OpenRouter. Les modèles à poids ouverts tournent sur un GPU loué avec vLLM, supprimé ensuite, généralement en 12 minutes au plus et pour bien moins d'un dollar.
Depuis octobre, l'application peut aussi répondre en tant qu'agent, et le benchmark fait tourner les deux modes sur les mêmes questions, données et modèles. Il ajoute 17 questions plus difficiles, comme l'historique d'un enregistrement à une date passée, la conversion de devises avec des cours quotidiens, des médianes et les clients actifs à chaque trimestre. Ces séries ont utilisé des noms cryptiques, sur une A100, chaque question étant posée trois fois.
| Modèle | Questions plus difficiles, agent | Questions plus difficiles, pipeline | Les 23 d'origine, agent | Les 23 d'origine, pipeline | Agent faux avec assurance | Temps de réponse de l'agent |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 s |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 s |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 s |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 s |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 s |
Faux avec assurance compte les erreurs de l'agent sur les 23 questions d'origine et sur les questions portant sur des données absentes. Le temps de réponse est la médiane. À titre de comparaison, les modèles fermés utilisés en pipeline ont obtenu sur les questions plus difficiles : Claude Sonnet 5 71 %, Gemini 3.8 Flash 69 %, GPT-4.1 mini 55 %, GPT-4.1 49 % et GPT-6 Luna 22 %, car il redemande des précisions sur la plupart. Chaque modèle ouvert utilisé en agent a fait mieux que chaque modèle fermé utilisé en pipeline.
En démontant l'agent, avec gpt-oss-20b sur les 23 questions d'origine, on voit ce que chaque partie apporte.
Sur les questions plus difficiles, les erreurs de gpt-oss-20b sont des brouillons qui s'exécutent et renvoient une mauvaise réponse, ce que les tests ne peuvent pas détecter.
L'onglet Model tests de l'application conserve chaque exécution enregistrée. Ces tableaux proviennent de son rapport du 27 septembre 2026, les plus justes en premier. Les modèles à poids ouverts pourraient tourner sur le matériel d'une banque ; les modèles fermés ont été appelés via OpenRouter pour comparaison.
| Modèle | Justes | Faux avec assurance | Questions en retour | Écritures dangereuses |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| Modèle | Justes | Faux avec assurance | Questions en retour | Écritures dangereuses |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
Chaque question est posée trois fois. Justes est la part des 69 réponses aux questions à réponse unique. Faux avec assurance compte les brouillons qui ont tourné et donné un mauvais résultat, plus les brouillons portant sur des données absentes de l'entrepôt. Questions en retour porte sur 18 réponses à des questions sur des données manquantes, et écritures dangereuses compte combien des 15 réponses aux demandes de modification ont atteint l'utilisateur.
Deux autres exécutions ne sont pas notées. Gemma 4 26B a bouclé avec la sortie JSON stricte, une défaillance de service et non une mesure de qualité, et Devstral Small 2 ne tourne pas du tout sur un A100.
Le rapport détaille aussi les résultats question par question, et c'est là que se voit le coût des noms cryptiques. Avec eux, aucun modèle n'a répondu à cinq questions que Qwen3.8-27B réussissait à chaque fois avec des noms descriptifs, comme le nombre de prêts en retard de plus de 90 jours.
L'application communique avec tout point d'accès compatible OpenAI : passer d'un fournisseur hébergé aux serveurs d'une banque ressemble donc à un simple changement de configuration. Un outil d'évaluation distinct vérifie si c'est vraiment le cas. Les mêmes poids gpt-oss-20b ont été servis par un fournisseur hébergé, sur CPU et sur des GPU loués via llama.cpp, vLLM et SGLang.
Chaque serveur a choisi les bonnes tables. Les différences sont apparues ailleurs : dans les jointures facultatives ajoutées à un brouillon, dans le fait qu'une demande destructive soit refusée ou interceptée plus tard par la vérification SQL, et sous charge. vLLM a respecté le format JSON strict avec 64 requêtes simultanées et a atteint environ 270 questions par minute sur une seule RTX 4090. SGLang a rompu ce format sous charge jusqu'à ce qu'il soit lancé avec un réglage plus strict, une défaillance qui n'est jamais apparue avec une requête à la fois.
Une autre expérience a réécrit le catalogue avec des noms abrégés de style mainframe. En conservant les descriptions des tables et des colonnes, les deux modèles ont encore réussi les douze questions de référence. Sans les descriptions, seule la moitié a réussi : un signe clair que de bonnes métadonnées comptent autant que le modèle.
Dix questions difficiles du benchmark, d'un grand écran de bureau à un petit téléphone. Chaque brouillon SQL a été écrit par le pipeline et le modèle de l'application, puis vérifié en l'exécutant sur l'entrepôt alimenté ; les dix ont donné la bonne réponse. Les captures rejouent ces réponses enregistrées : elles sont donc reproductibles et ne contiennent aucune donnée bancaire réelle.
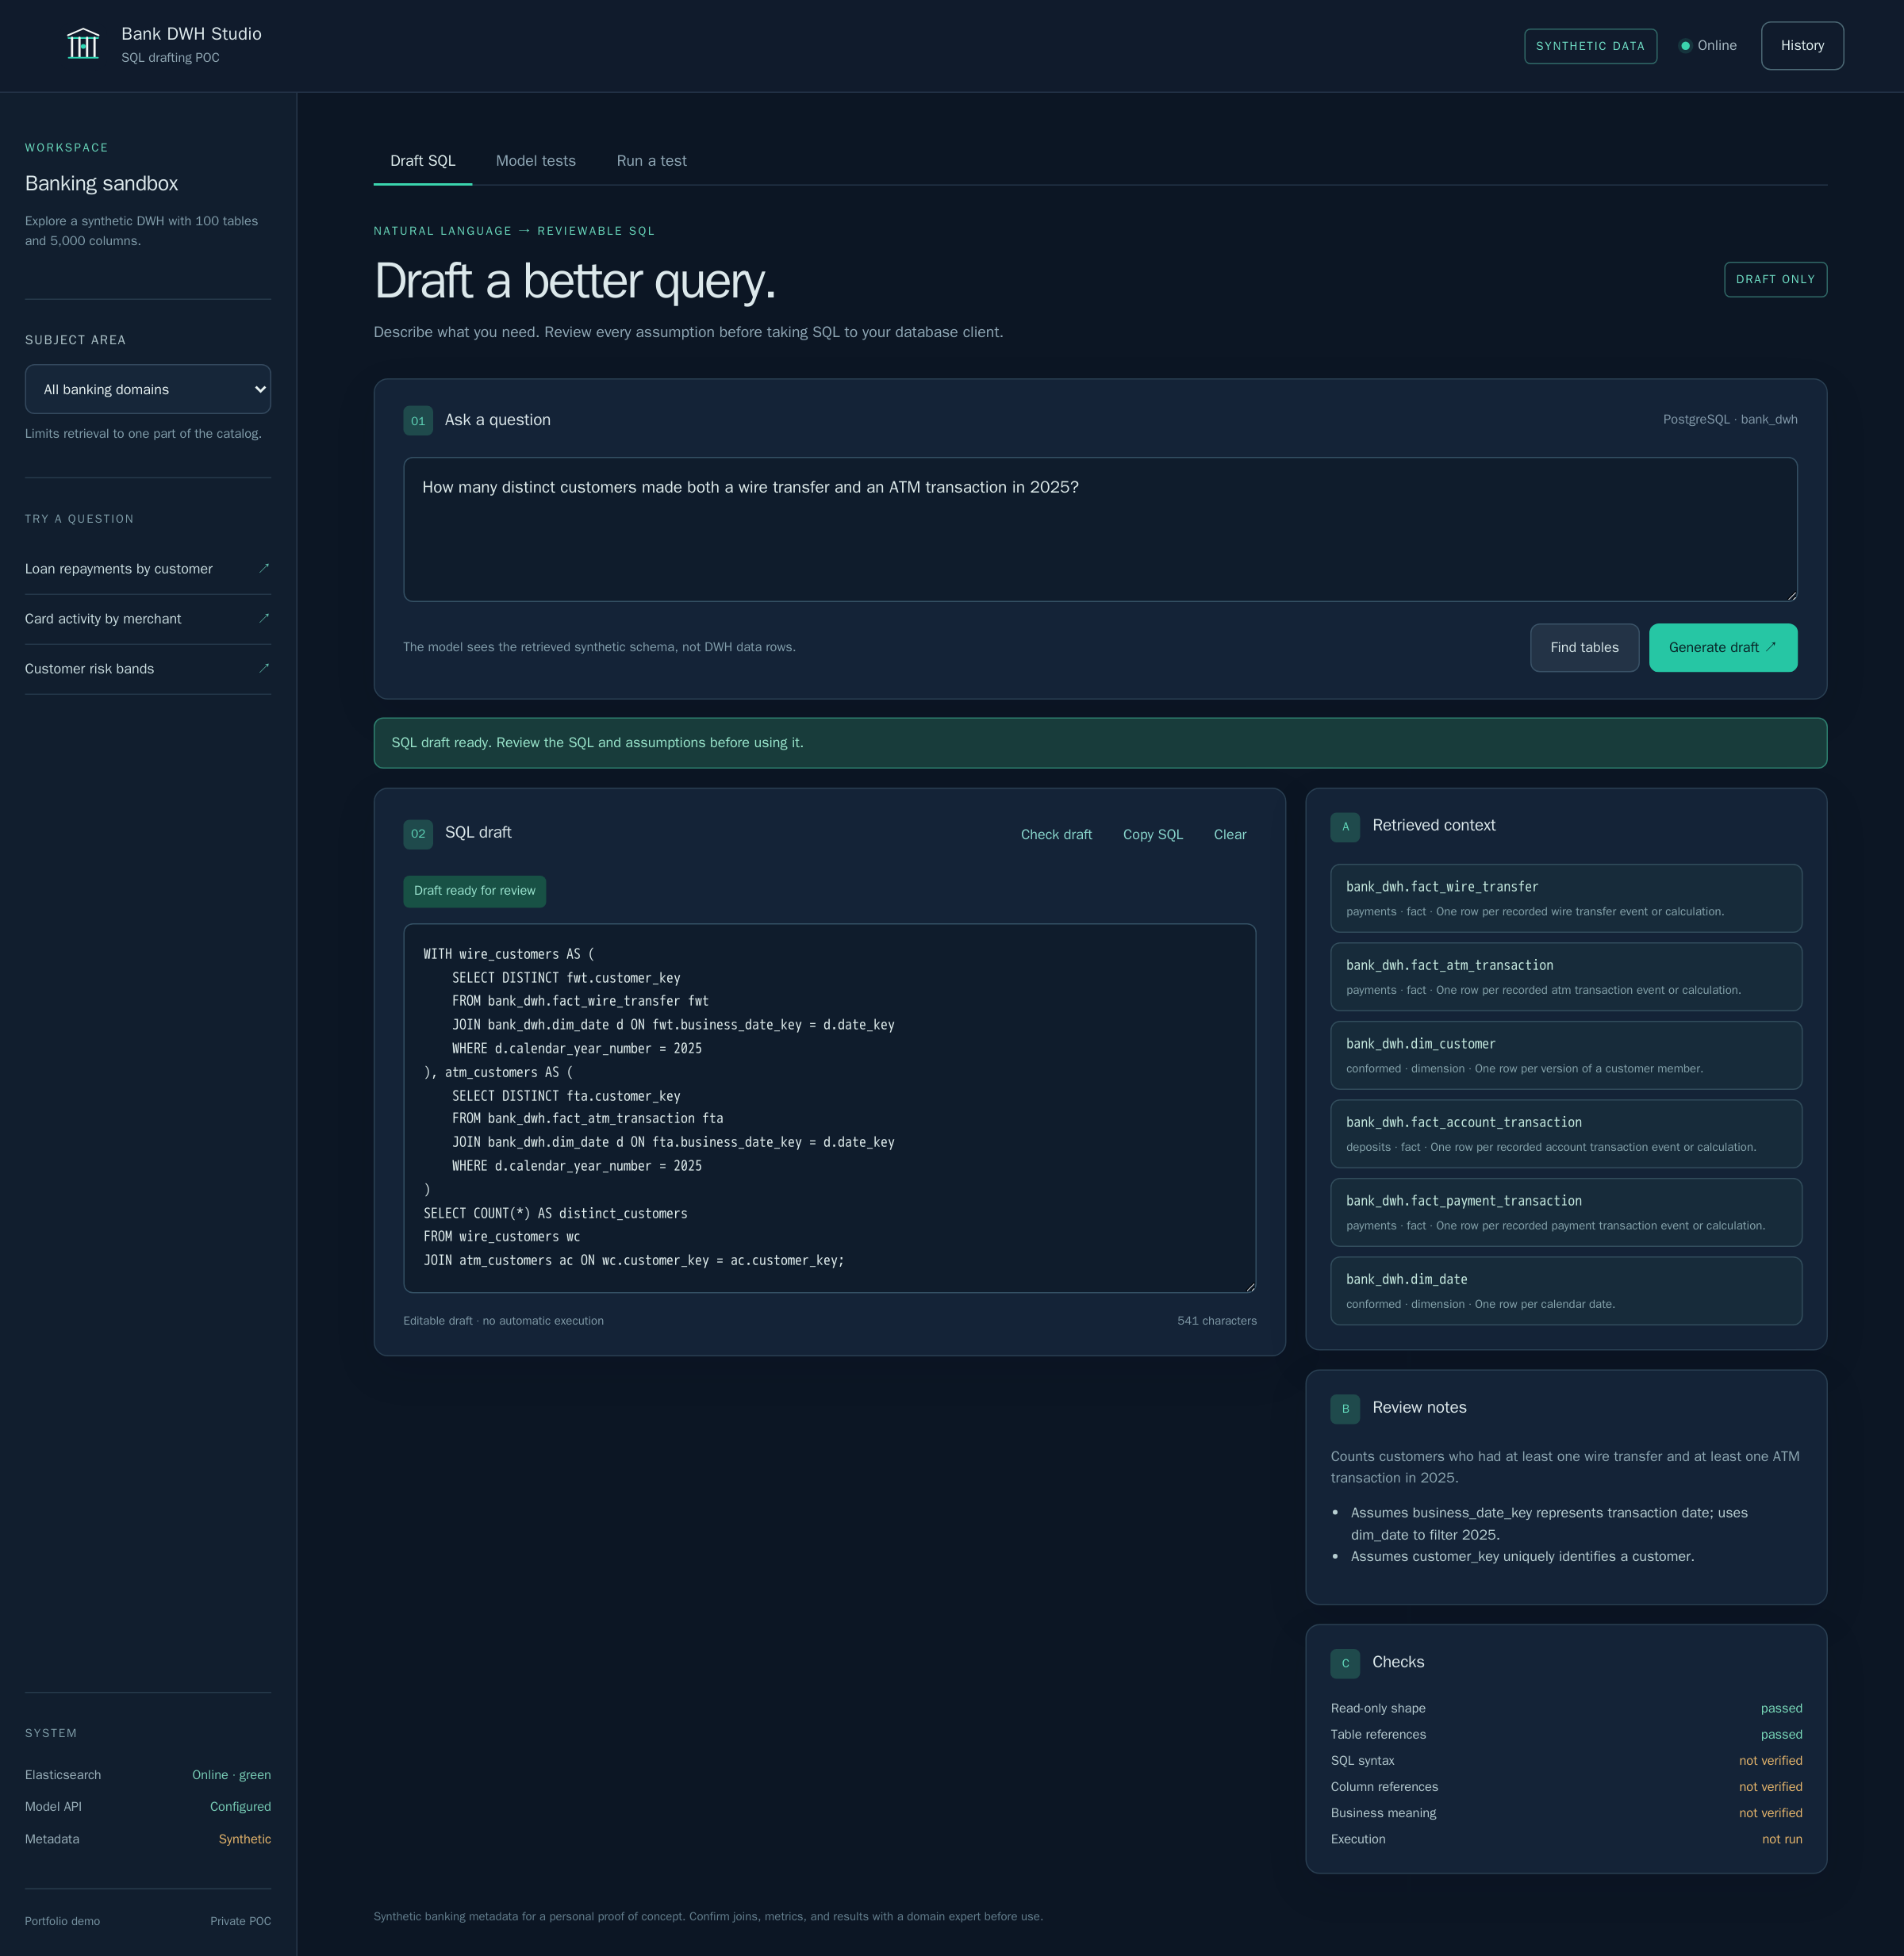
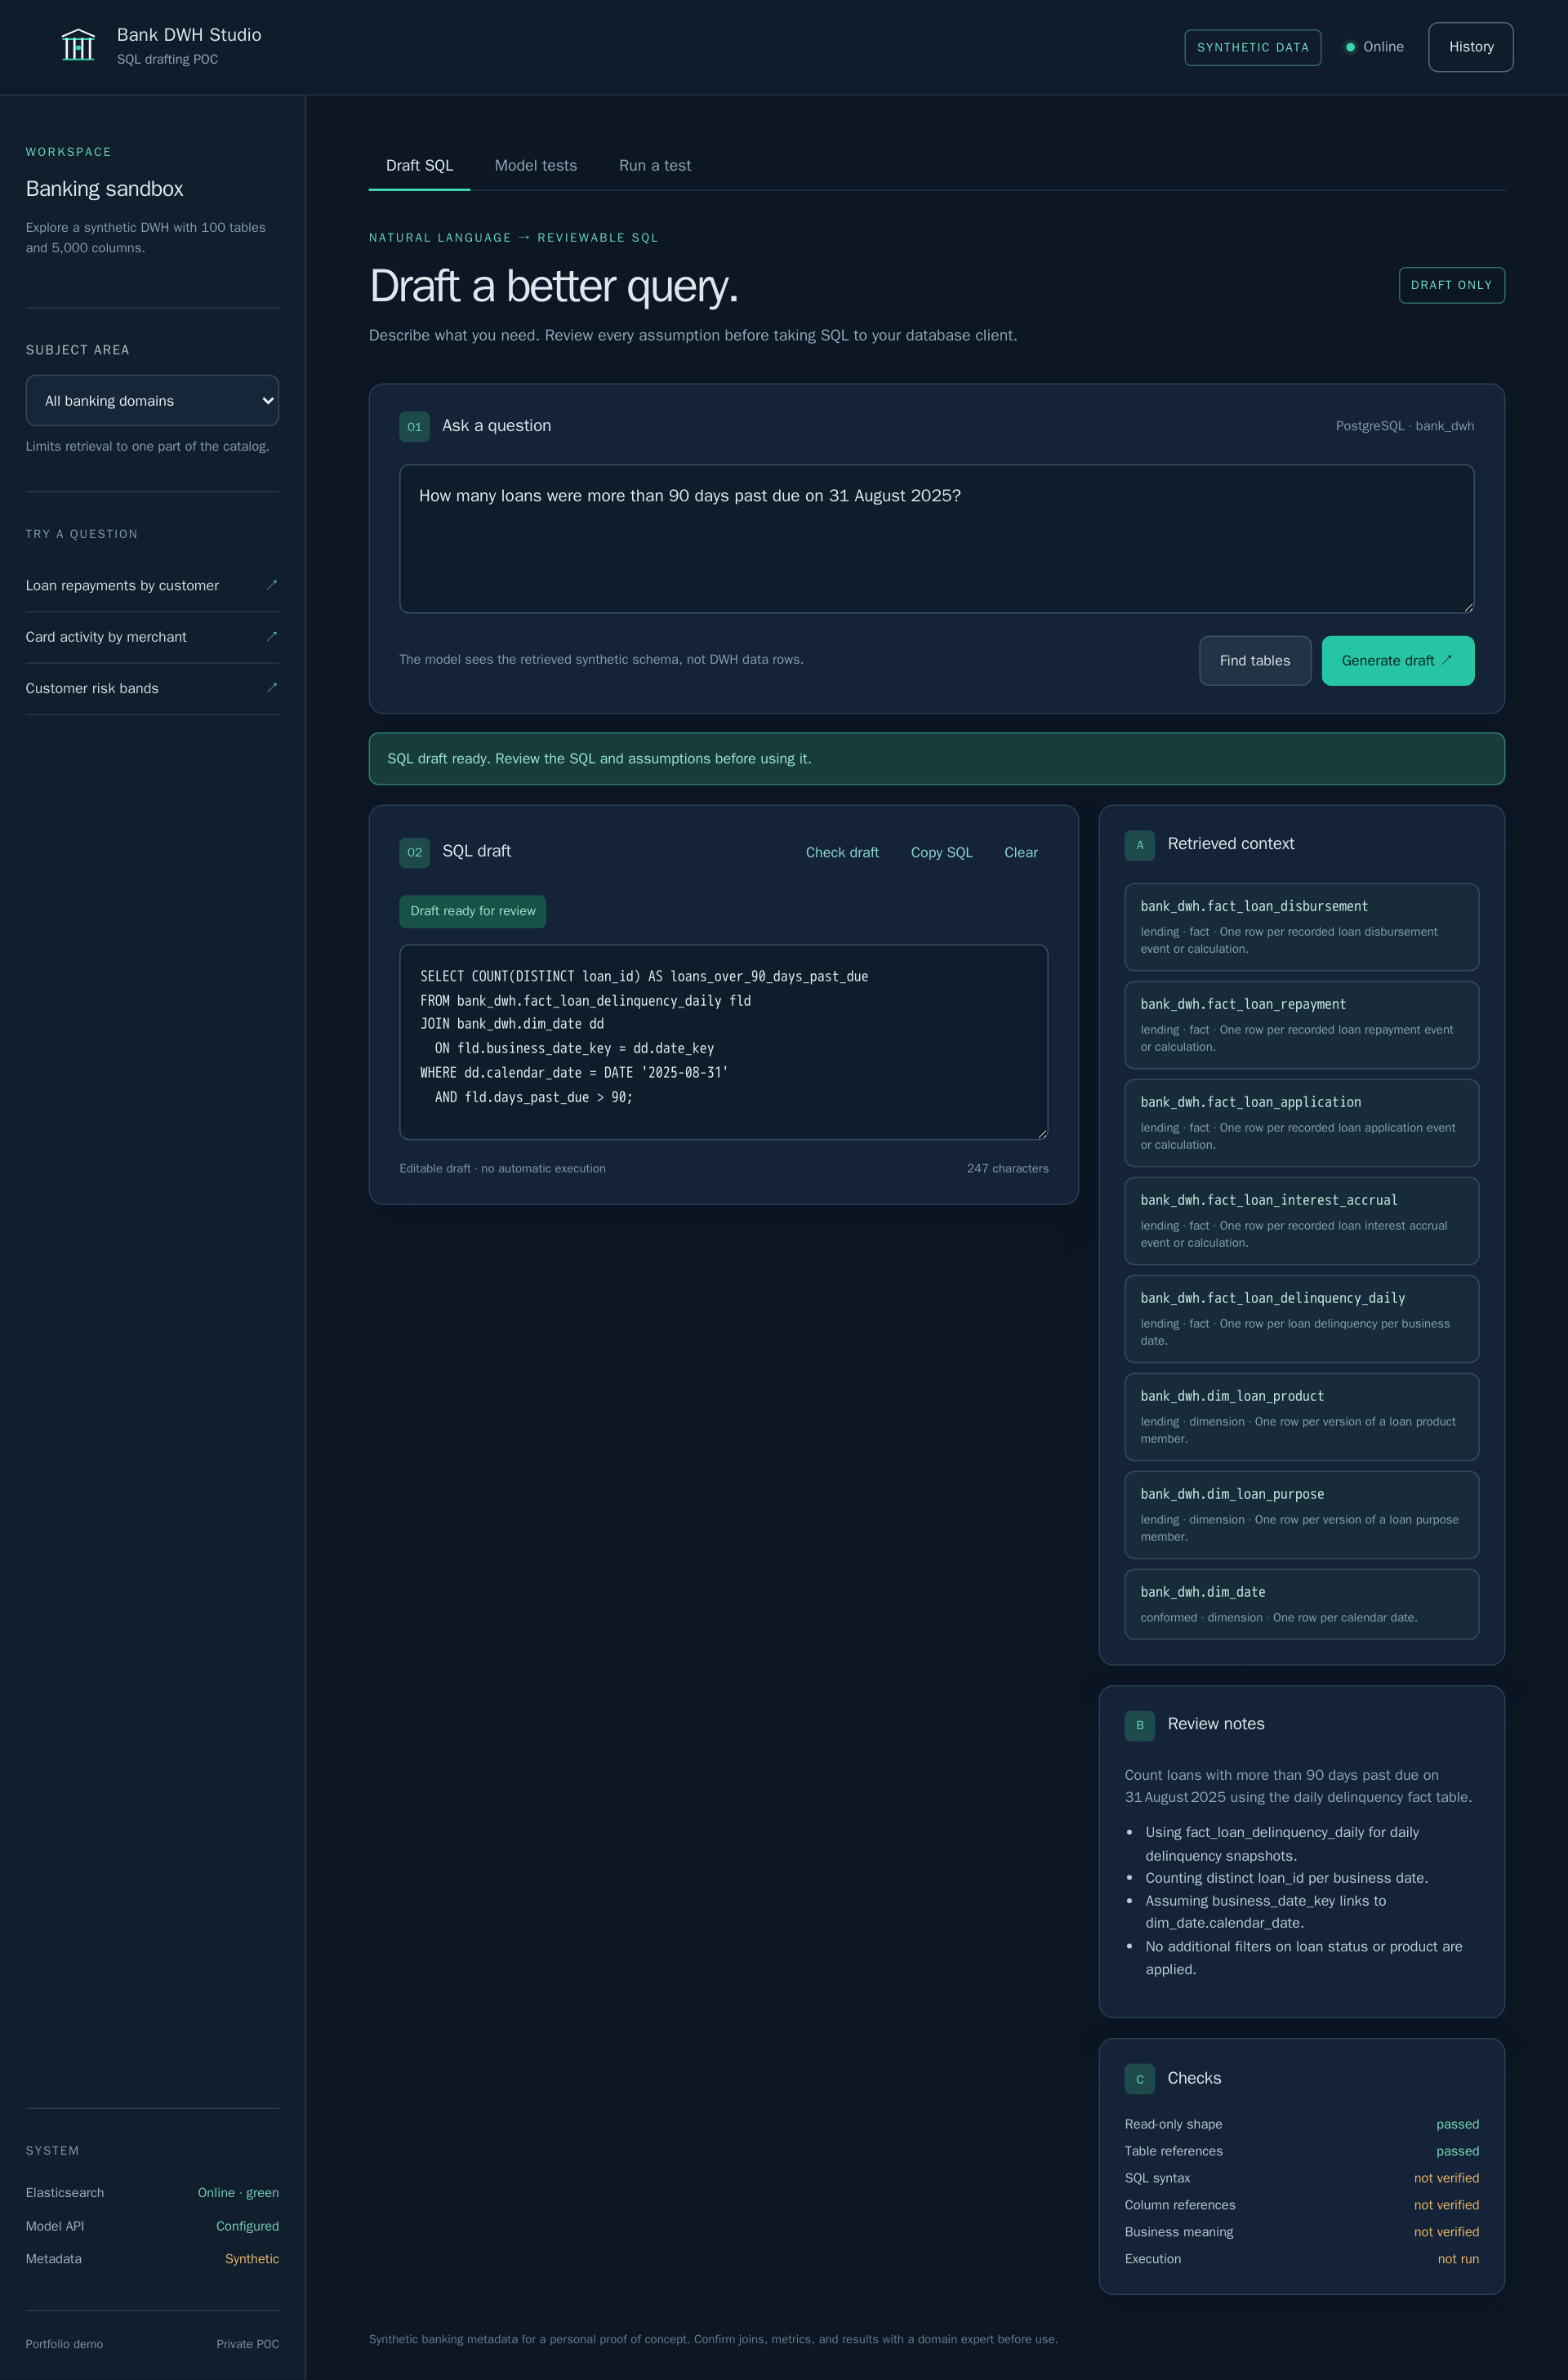
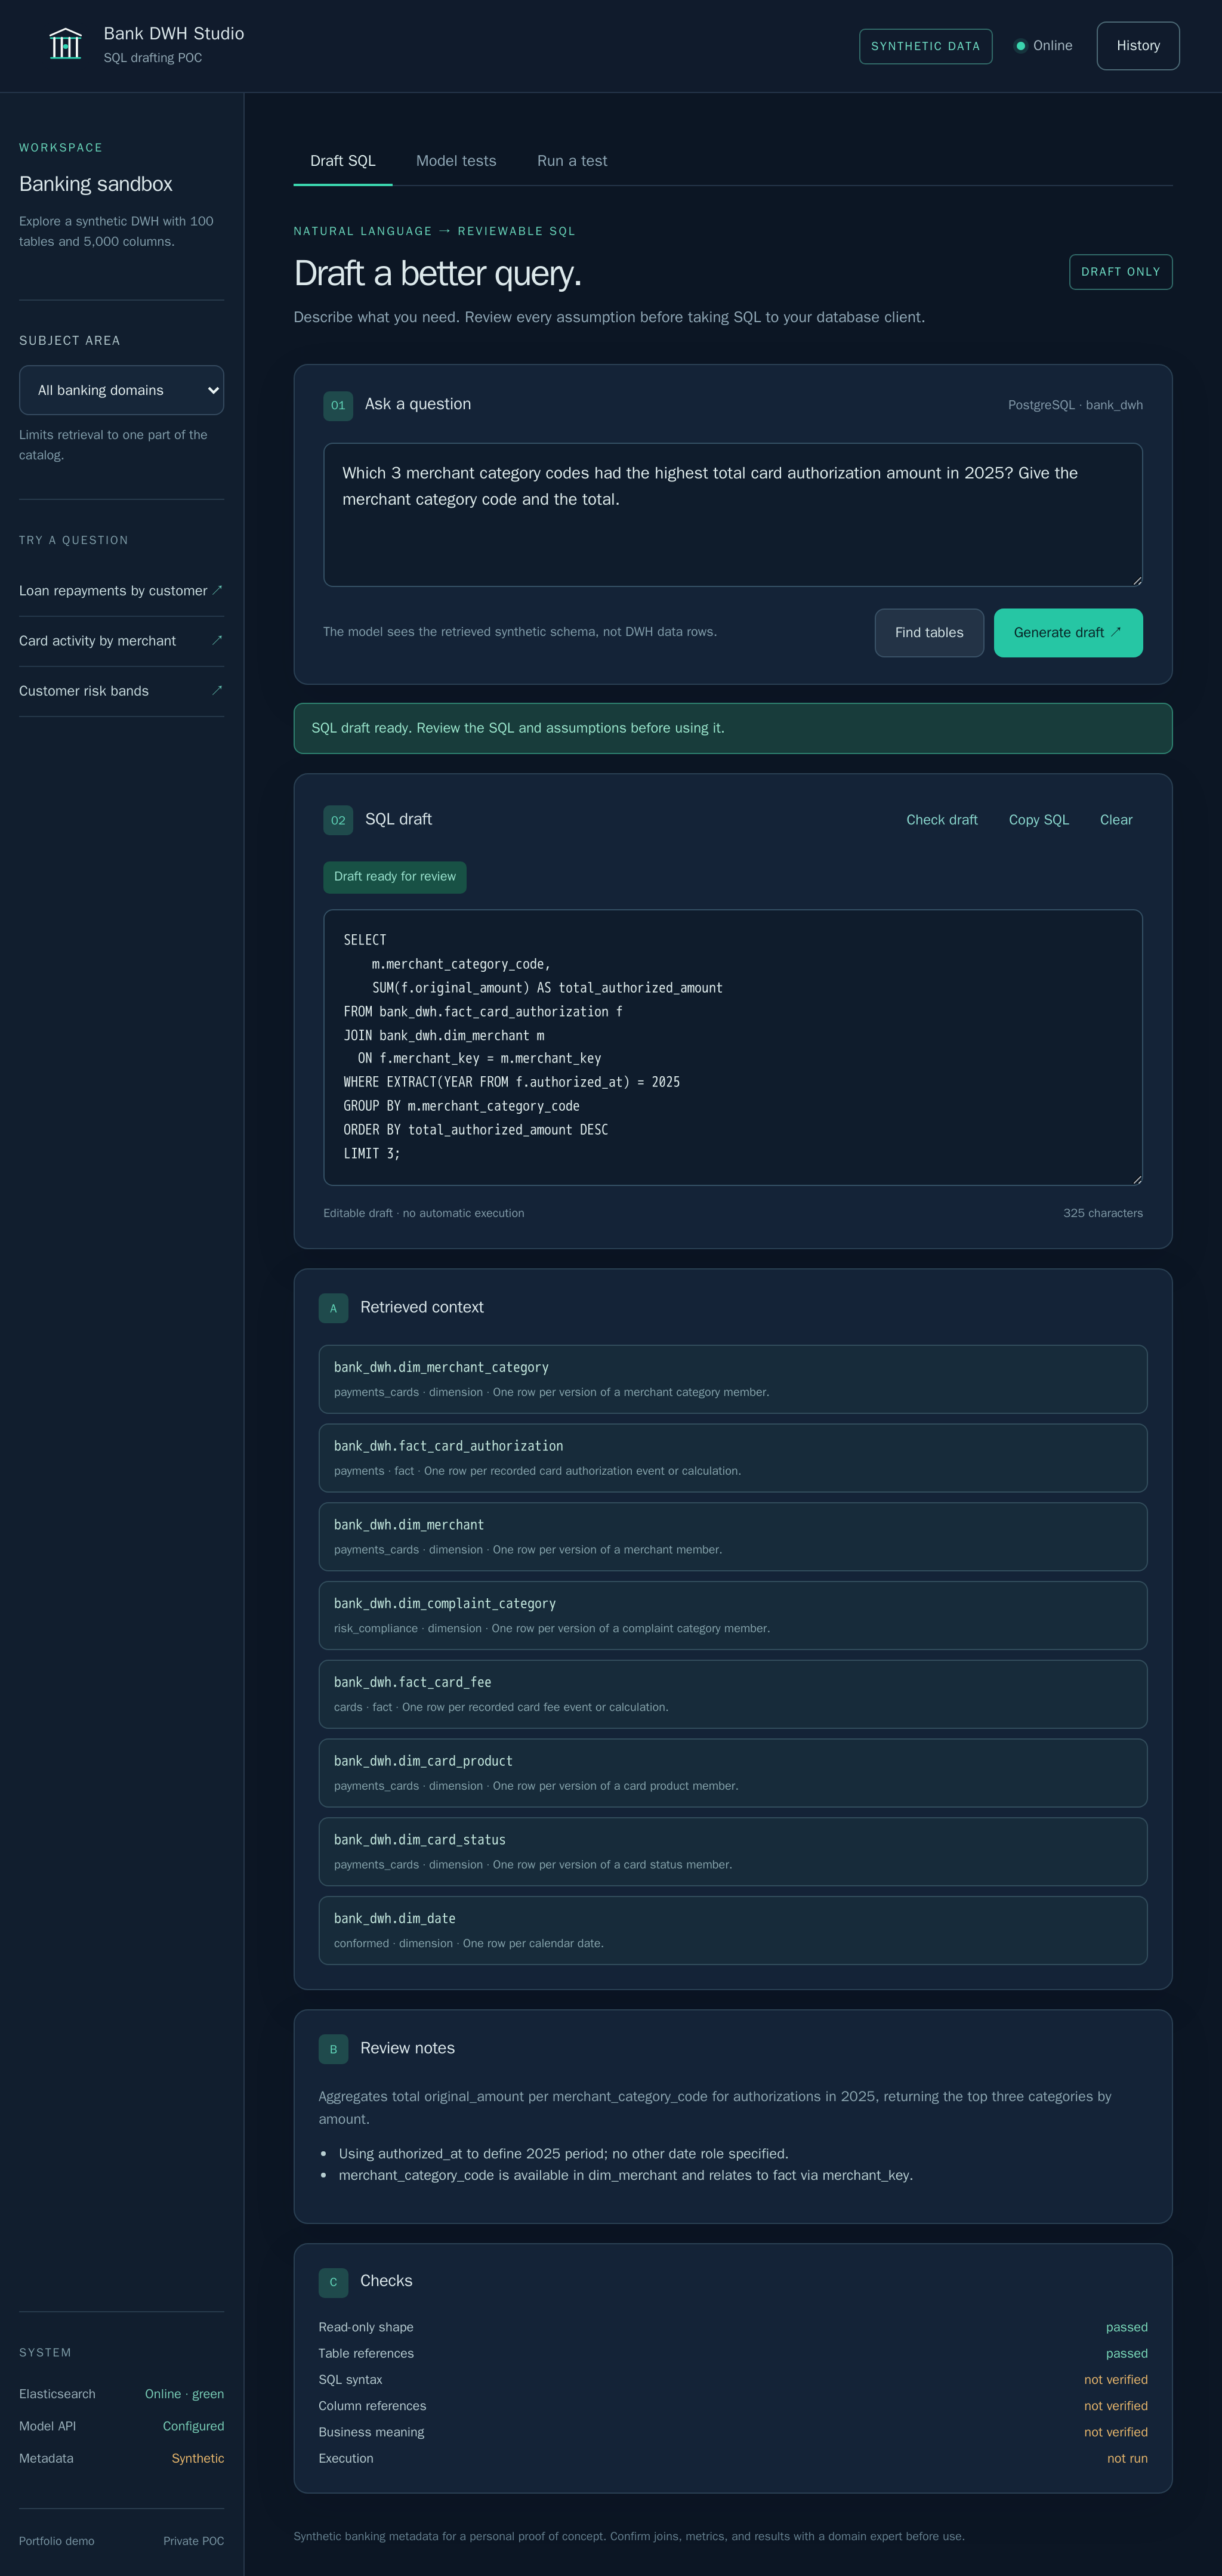
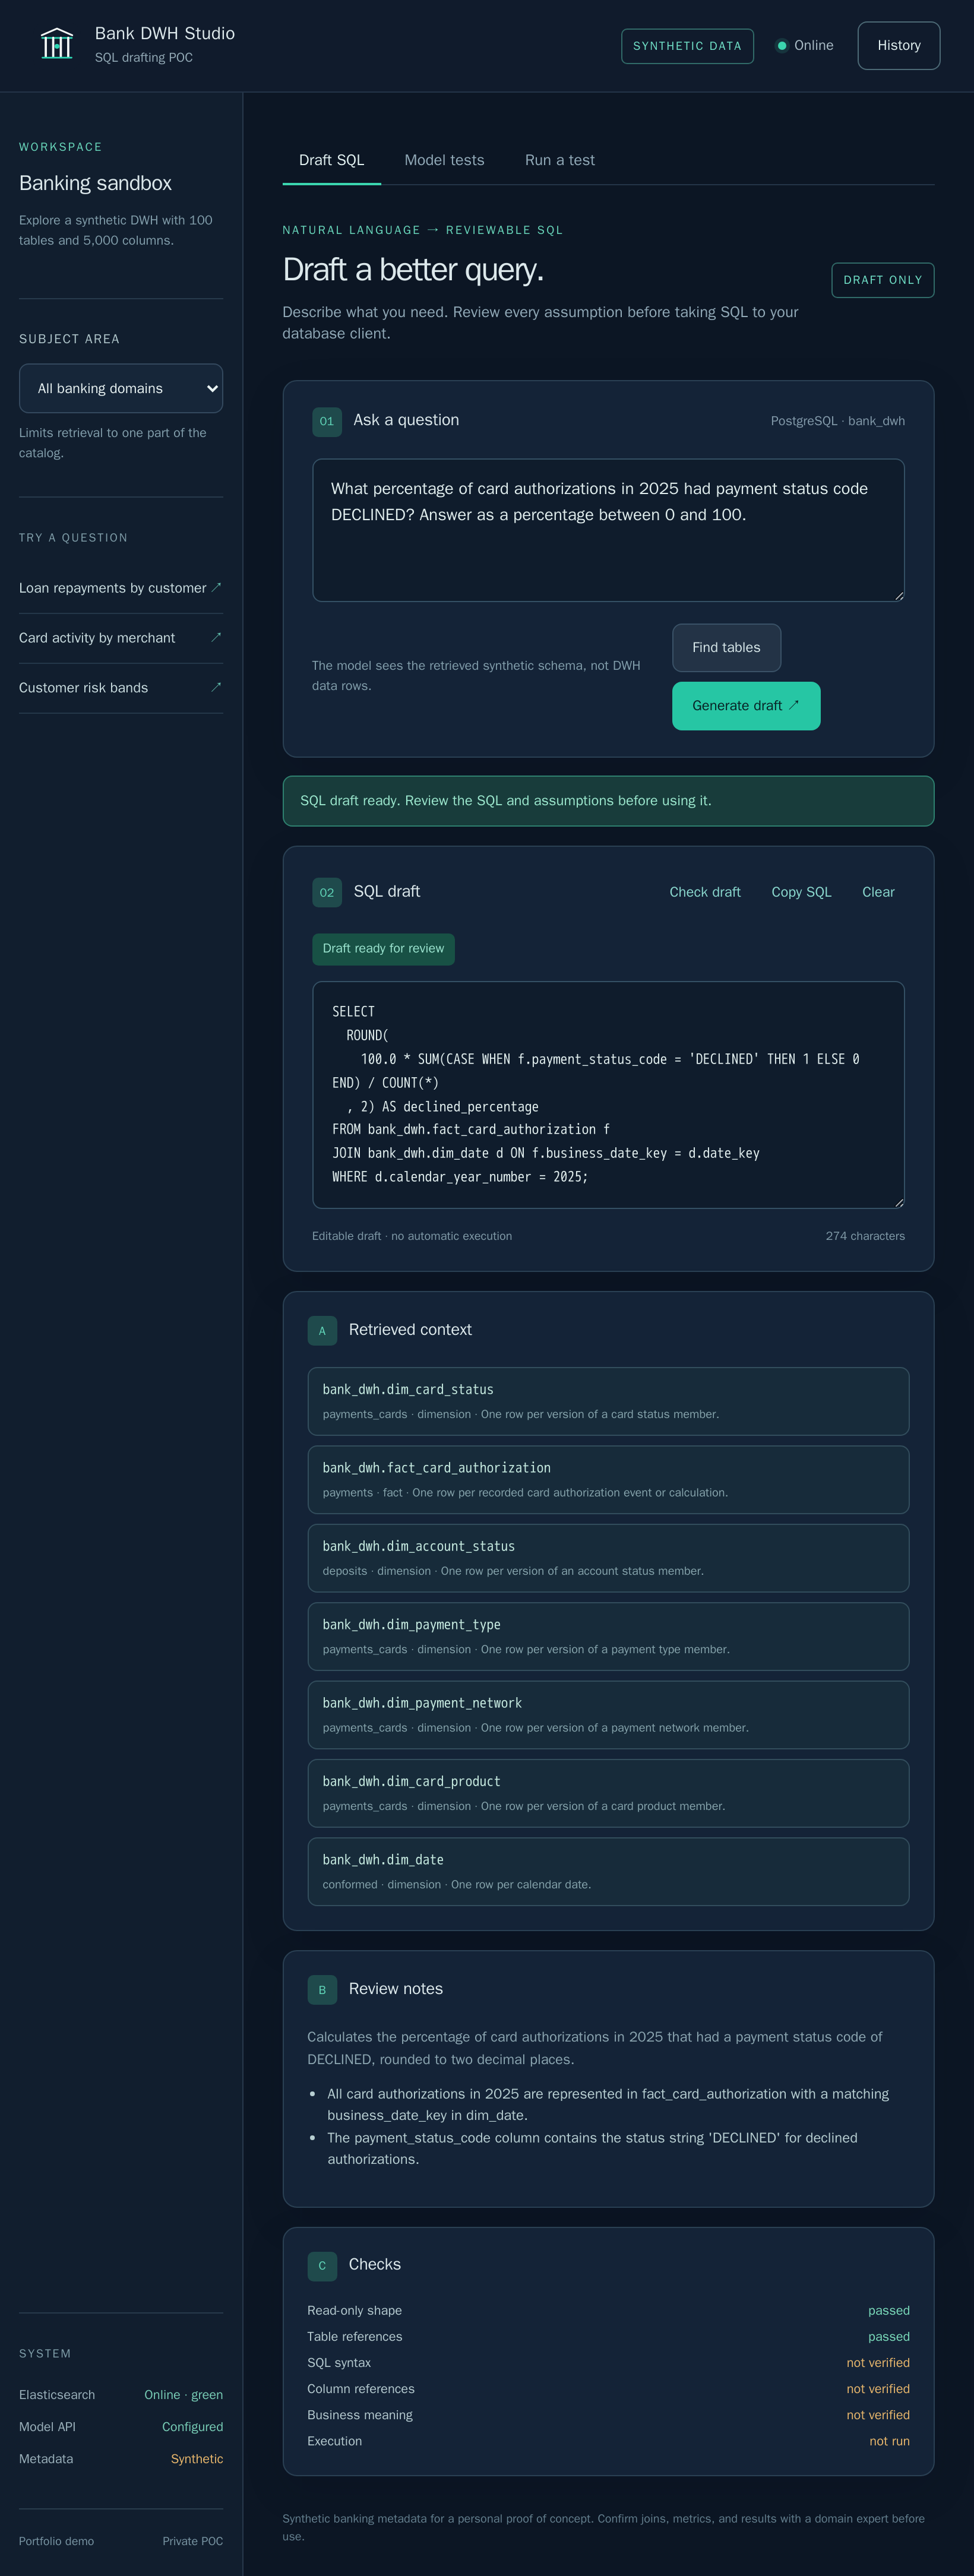
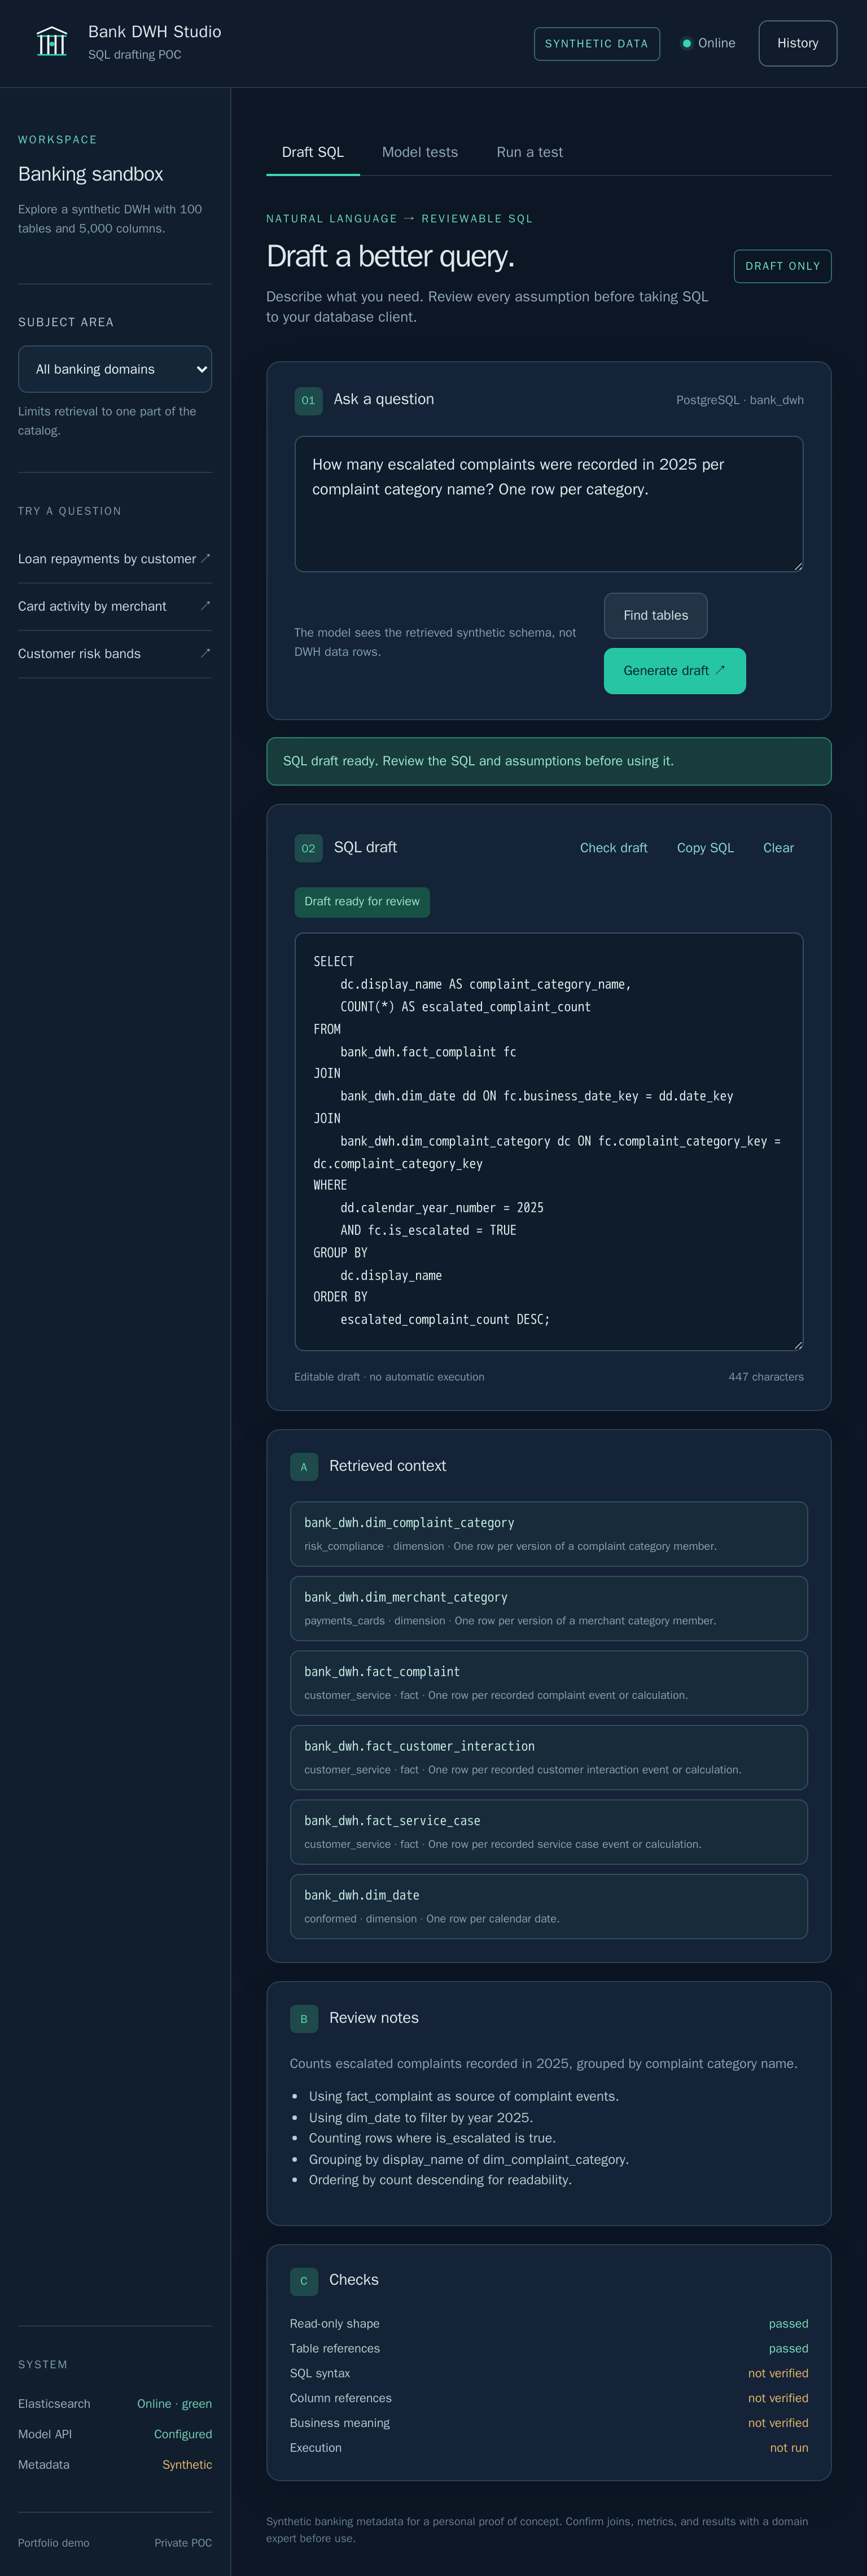
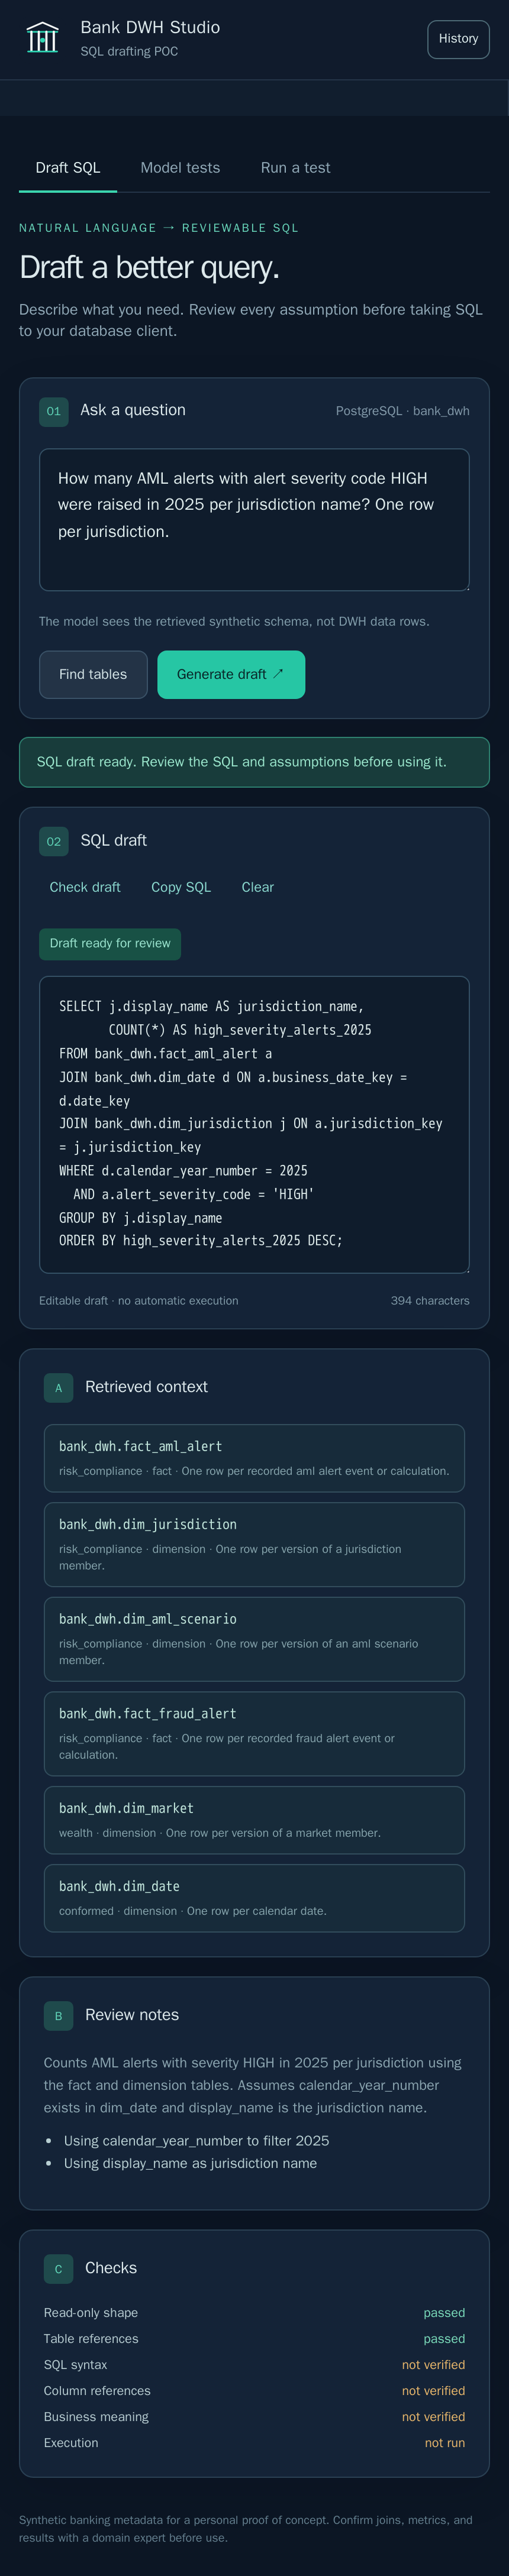
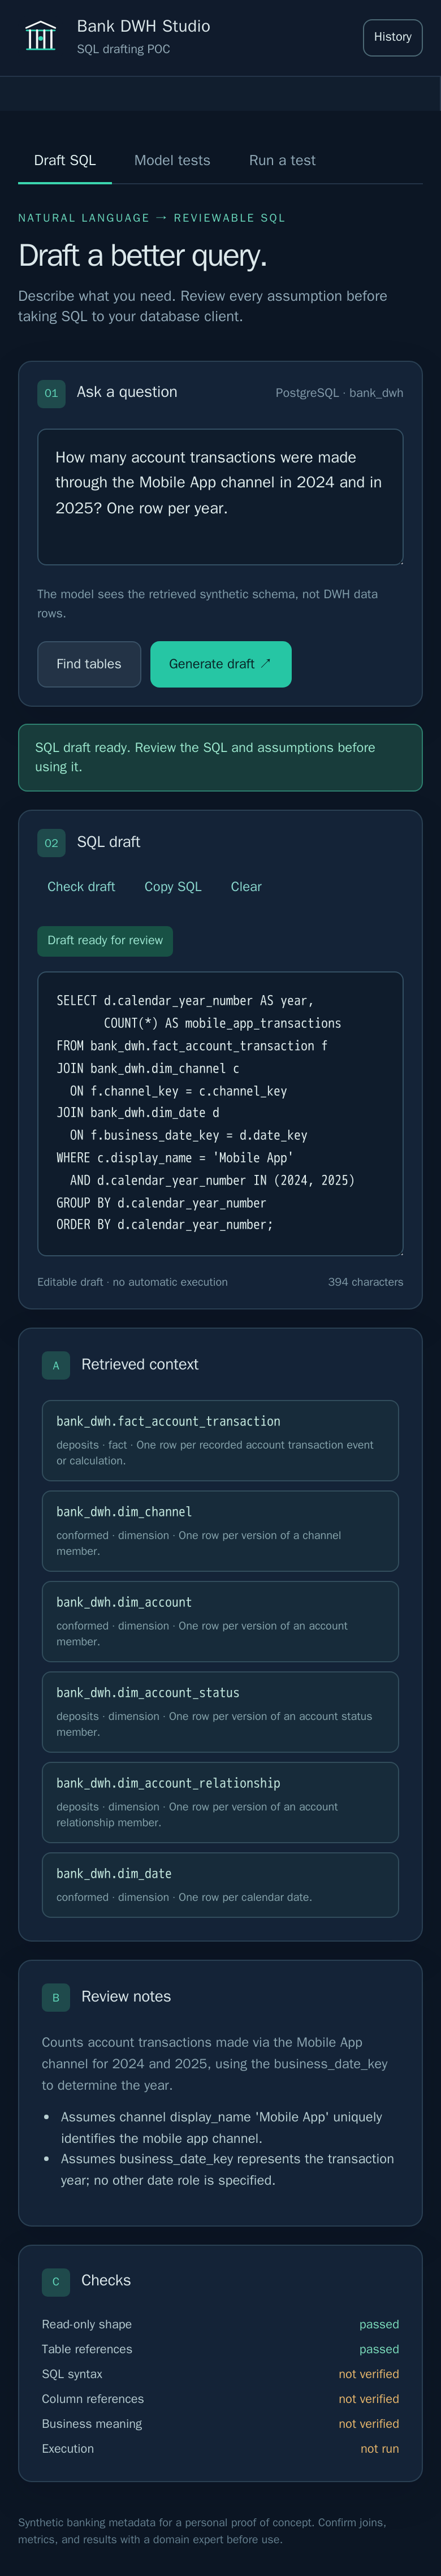
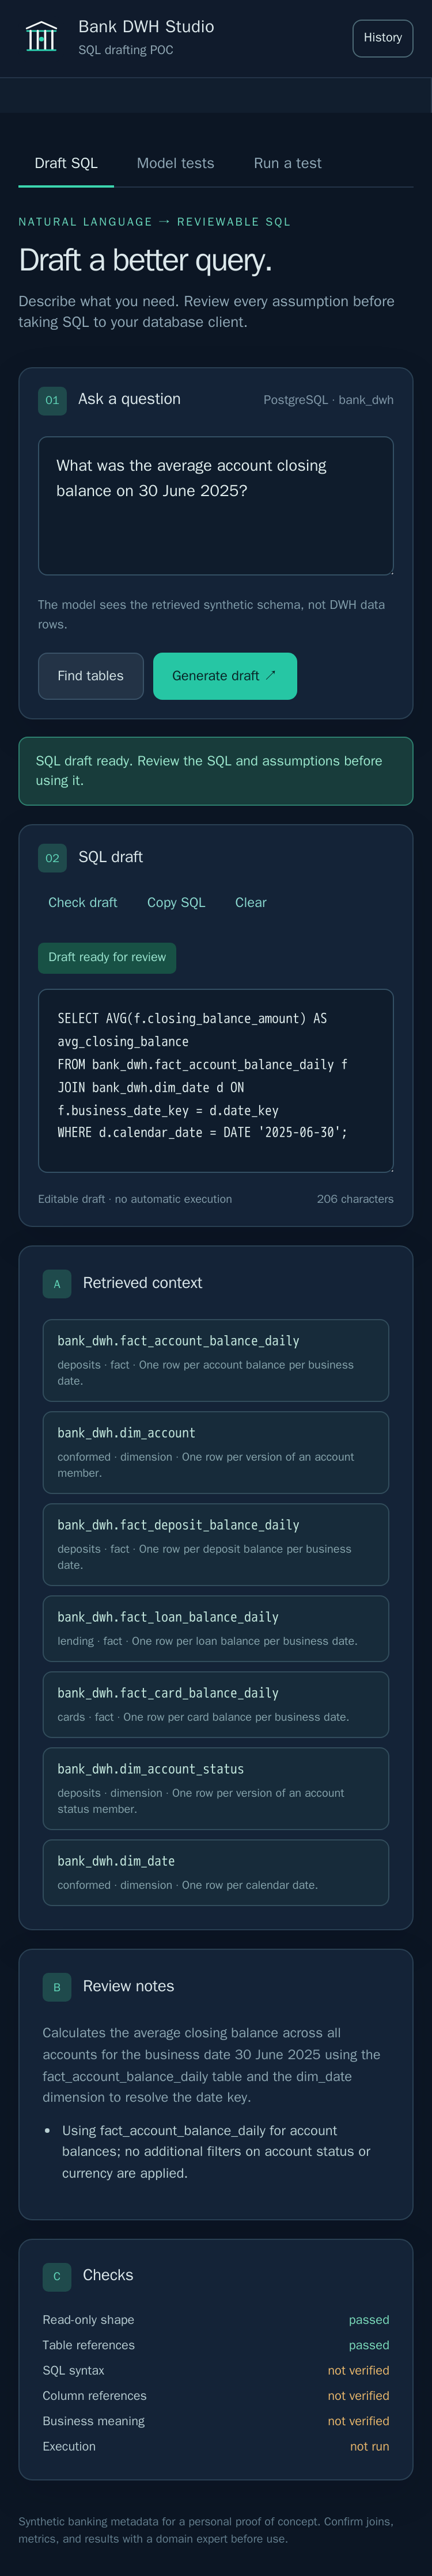
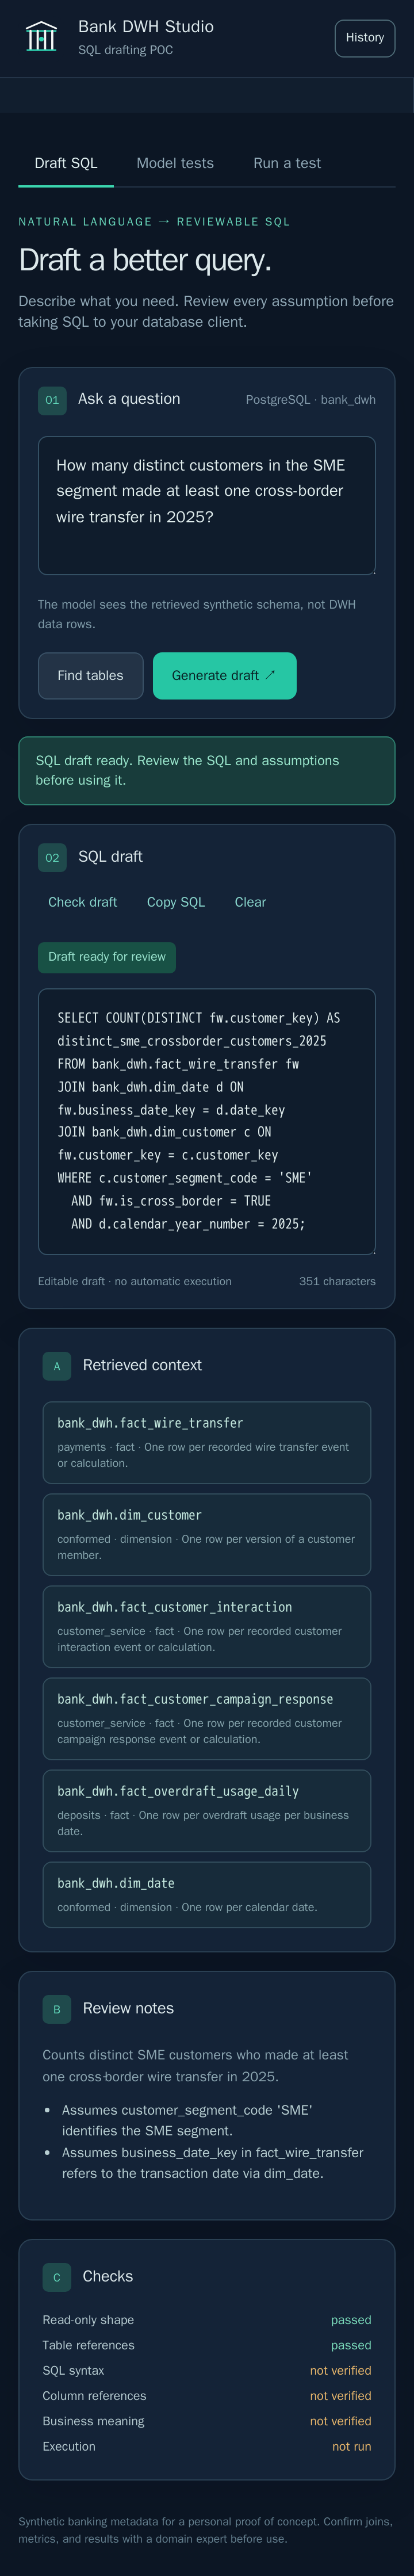
L'application rédige et teste des brouillons SQL, mais uniquement sur une copie synthétique de l'entrepôt et sous un utilisateur qui ne peut que lire ; elle ne se connecte jamais à un véritable entrepôt bancaire. Les utilisateurs relisent toujours le résultat, puis le modifient ou le copient et l'exécutent dans leur propre client de base de données. Le navigateur ne reçoit jamais la clé d'API du modèle.
Les contrôles automatisés vérifient la forme en lecture seule de l’instruction et les références aux tables connues. La syntaxe SQL, les références aux colonnes et le sens métier nécessitent toujours une revue humaine. Tous les noms, relations et indicateurs de l’entrepôt sont des données de test synthétiques, et non des définitions bancaires approuvées.
La preuve de concept déployée fait tourner un backend Node, Elasticsearch et l'entrepôt PostgreSQL en lecture seule dans des conteneurs sans root sur une instance Oracle Ampere A1, et rédige le SQL avec gpt-oss-20b via un fournisseur hébergé. Le dépôt documente aussi une architecture future plus large, clairement séparée du POC déployé, plus petit.
Une petite console pour gérer les invitations et les appareils des applications Web privées.
Une petite brique qui aide les applications Web à fonctionner hors connexion et à rester à jour.
Montrez comment les choses circulent. Créez et exportez des diagrammes dans votre navigateur.