पर्दे के पीछे
PWA Invite Console
निजी वेब ऐप के निमंत्रण और उपकरण सँभालने के लिए एक छोटा कंसोल।
बैंकिंग डेटा के बारे में सवाल पूछें, संबंधित स्कीमा देखें और संपादन योग्य SQL ड्राफ्ट पाएँ।
लाइव PWA केवल आमंत्रण के लिए है।
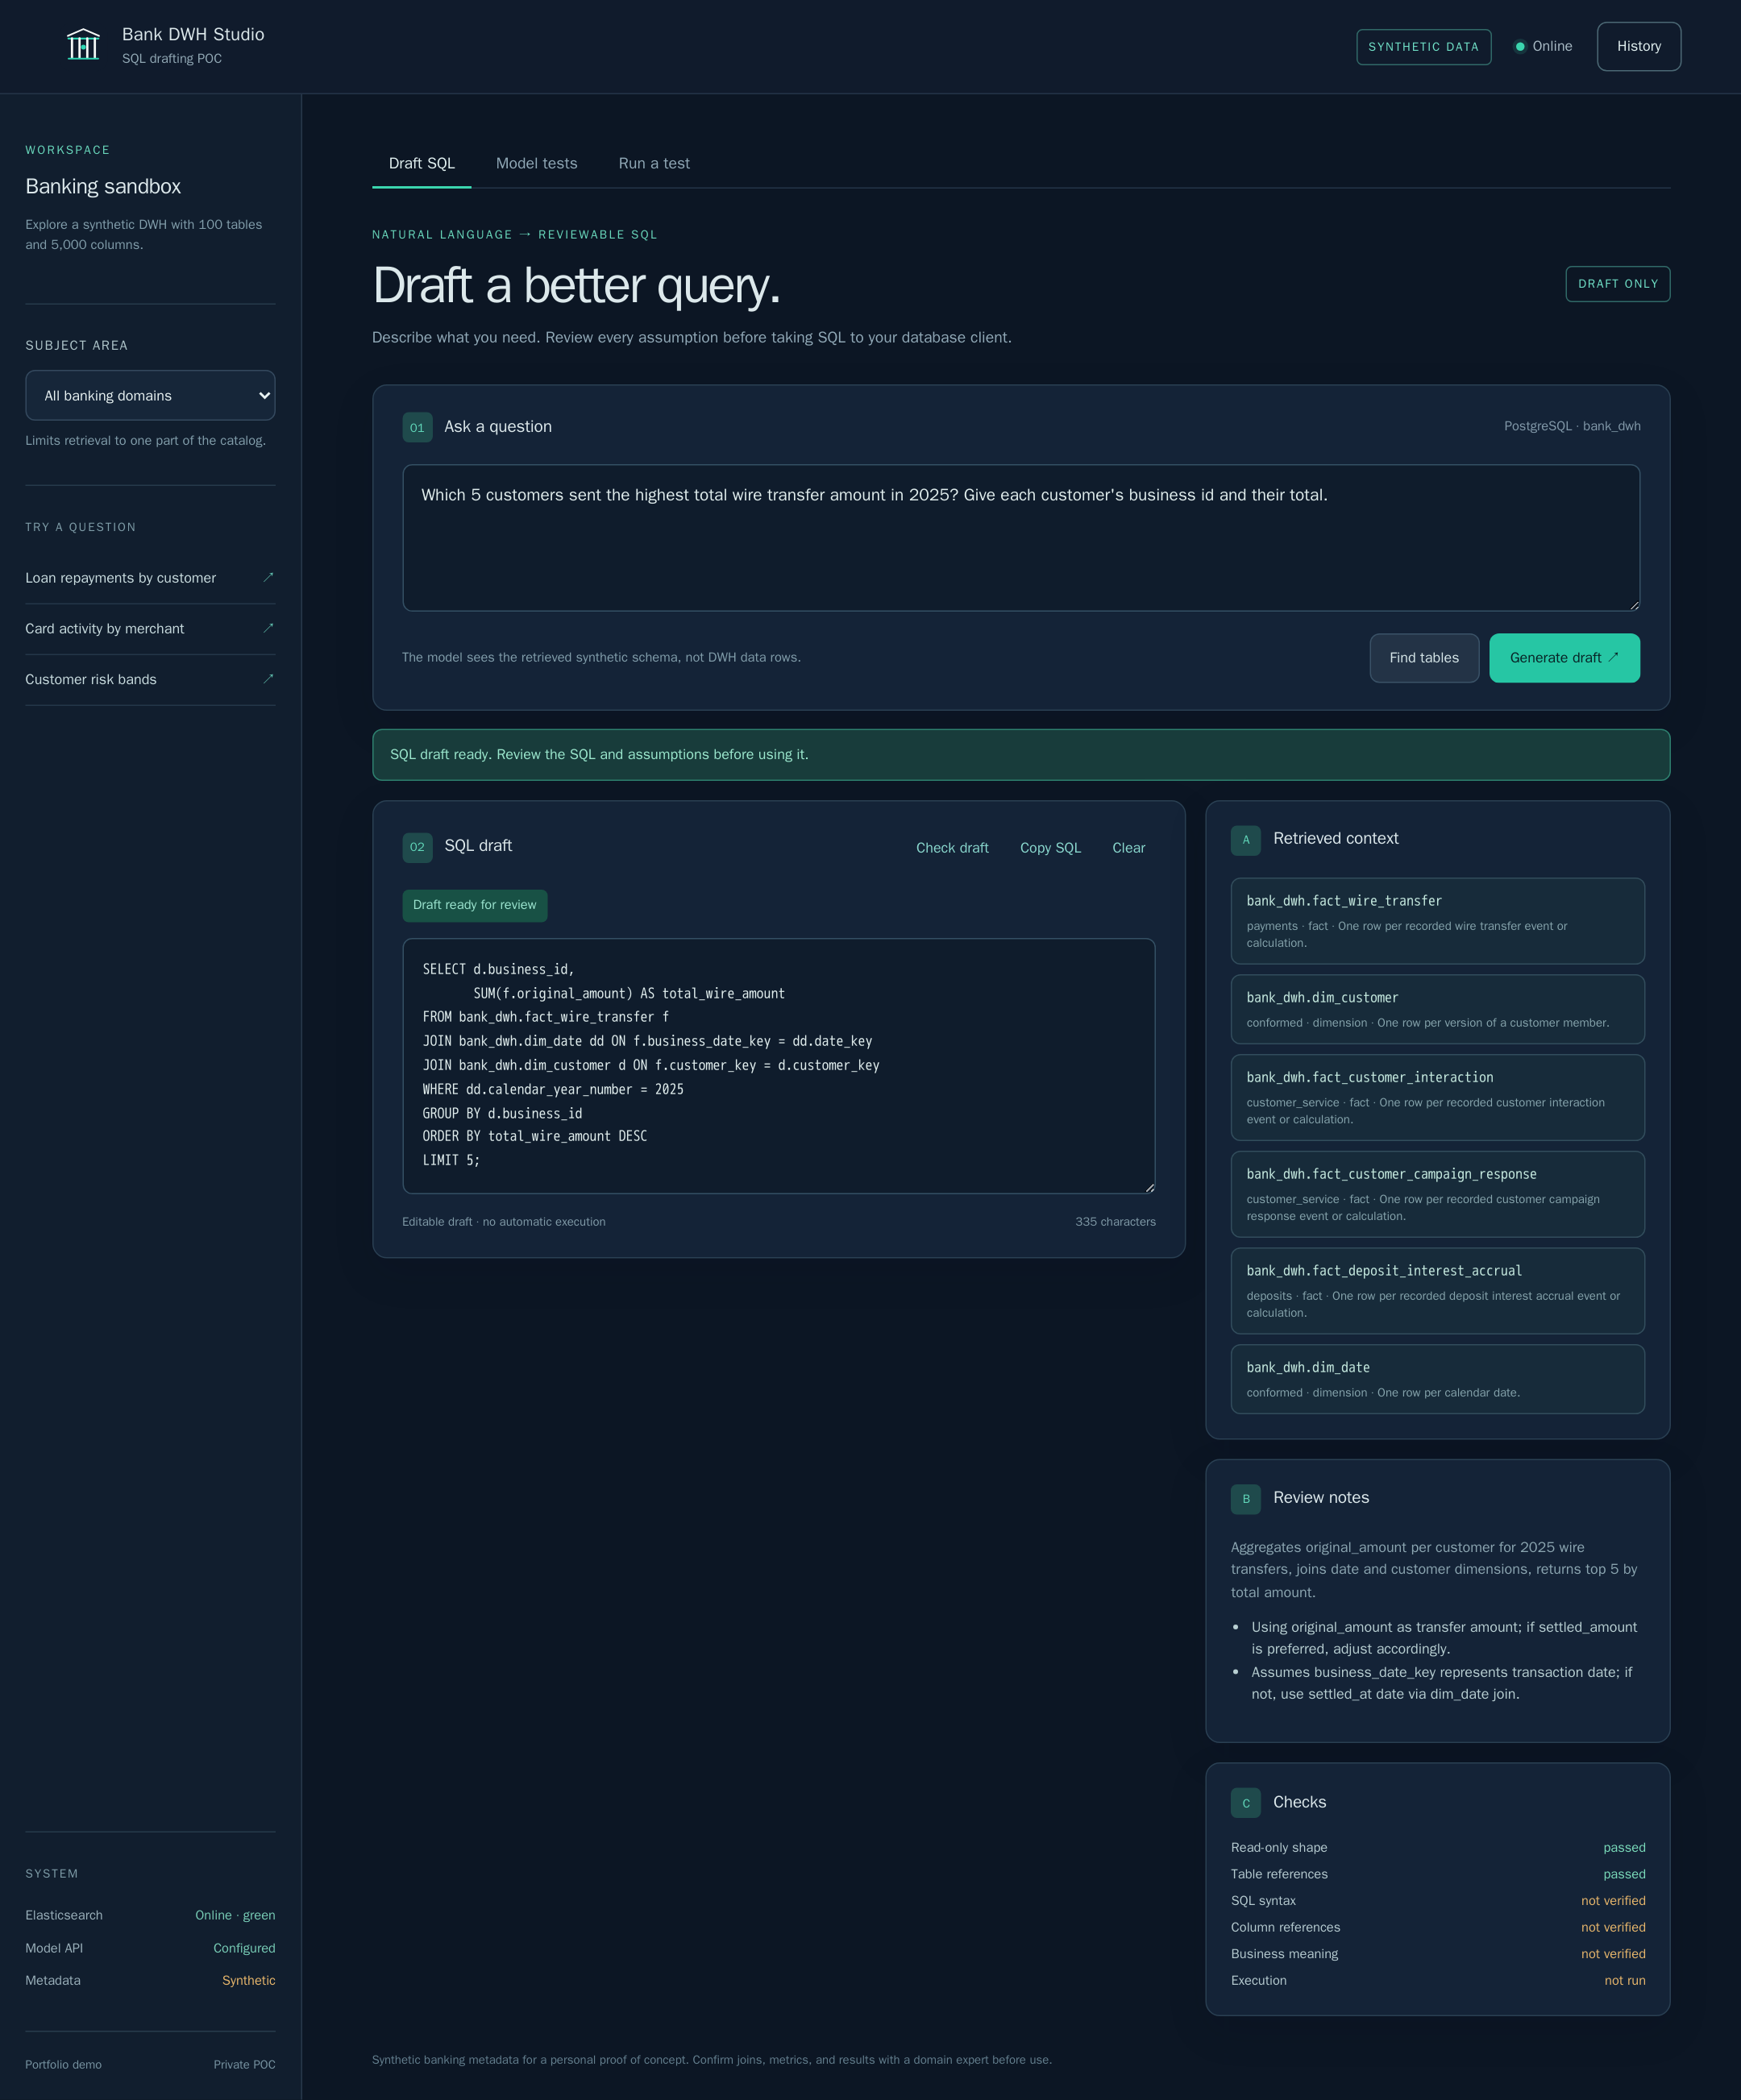
Bank DWH Studio आम भाषा में एक बड़े बैंकिंग डेटा वेयरहाउस को खंगालने का एक निजी प्रूफ़ ऑफ़ कॉन्सेप्ट है। सवाल पूछें, चाहें तो कोई बैंकिंग विषय क्षेत्र चुनें, और तय करें कि जवाब कैसे दिया जाए: एक एजेंट जो टेबल खोजता है और अपना SQL परखता है, या एक पाइपलाइन जो स्कीमा लाती है और एक ही चरण में PostgreSQL SQL लिखती है।
नतीजा जान-बूझकर सिर्फ़ कोड ब्लॉक से ज़्यादा है। संपादित किए जा सकने वाले ड्राफ़्ट के साथ इस्तेमाल हुई टेबल, व्याख्या, मान्यताएँ, समीक्षा नोट और बुनियादी जाँचें दिखती हैं, और साथ में वे पंक्तियाँ भी जो ड्राफ़्ट वेयरहाउस की सिंथेटिक कॉपी से लौटाता है। जब कोई ज़रूरी जानकारी छूट जाए, जैसे अगस्त के अंत वाले अनुरोध में साल, तो सहायक स्पष्टीकरण माँग सकता है।
एक उत्पन्न बैंकिंग वेयरहाउस फिक्स्चर 5,000 कॉलम, रिश्ते, PostgreSQL DDL, एक कैटलॉग और एक छोटा बीज प्रदान करता है।
एक एजेंट जो टेबल खोजता है और अपना SQL परखता है, या एक पाइपलाइन जो Elasticsearch से स्कीमा लाकर एक ही कॉल में ड्राफ़्ट लिखती है। हर उपयोगकर्ता मोड खुद चुनता है।
ड्राफ़्ट बेंचमार्क के डेटा से भरे सिंथेटिक वेयरहाउस पर ऐसे उपयोगकर्ता के रूप में चलते हैं जो सिर्फ़ पढ़ सकता है, 15 सेकंड की सीमा और पंक्तियों की ऊपरी सीमा के साथ। हर बार शुरू होने पर कॉपी मूल डेटा से दोबारा बनाई जाती है।
पुनर्प्राप्त तालिकाएँ, व्याख्याएँ, धारणाएँ, नोट्स और चेक दृश्यमान रहते हैं ताकि मसौदे को आँख बंद करके स्वीकार करने के बजाय चुनौती दी जा सके।
हर जवाब, आपसे पूछा गया कोई जवाबी सवाल भी, आपके डिवाइस के इतिहास में सहेजा जाता है। पिछला ड्राफ़्ट वापस लाएँ या जिनकी अब ज़रूरत नहीं है उन्हें हटा दें।
दो टैब हर बेंचमार्क रन को ओपन या क्लोज़्ड वेट्स के निशान के साथ दिखाते हैं, नतीजों को PDF के रूप में एक्सपोर्ट करते हैं, और मंज़ूर किए गए डिवाइस को किराए के GPU पर या OpenRouter के ज़रिए नया मॉडल टेस्ट करने देते हैं, लाइव प्रगति के साथ।
एक ऑडिट लॉग, जिसमें सिर्फ़ जोड़ा जाता है, हर सवाल, चलाया गया हर स्टेटमेंट और उसे किसने चलाया, और हर जवाब रखता है, आपके डिवाइस के इतिहास से अलग।
केवल-आमंत्रण इंटरफ़ेस इंस्टॉल करने योग्य है और विस्तृत डेस्कटॉप स्क्रीन से लेकर कॉम्पैक्ट फोन तक के लिए अनुकूल है।
SQL लिखने वाला टूल तभी उपयोगी है जब उसका SQL सही हो, इसलिए रिपॉज़िटरी इसे मान लेने के बजाय मापती है।
एक मॉडल बेंचमार्क 46 कठिन सवाल पूछता है, हर सवाल तीन बार। जिन सवालों का एक ही सही जवाब है, उन्हें वेयरहाउस की डेटा से भरी PostgreSQL कॉपी पर ड्राफ़्ट चलाकर जाँचा जाता है। जिन सवालों का डेटा वेयरहाउस में नहीं है, जैसे वेतन या ग्राहक छोड़ने की दर, उनका जवाब एक सवाल होना चाहिए। डेटा बदलने के अनुरोध कभी भी उपयोगकर्ता तक नहीं पहुँचने चाहिए।
सबसे अहम आँकड़ा यह है कि मॉडल कितनी बार आत्मविश्वास से गलत होता है: ऐसा ड्राफ़्ट जो चलता है पर गलत नतीजा देता है, या ऐसे डेटा के बारे में जवाब जो मौजूद ही नहीं। दोनों असली जवाब जैसे दिखते हैं, और यही उन्हें जोखिम भरा बनाता है।
हर मॉडल एक ही सवालों का जवाब दो बार देता है। पहली बार वेयरहाउस fact_account_balance_daily जैसे वर्णनात्मक नामों का इस्तेमाल करता है। दूसरी बार वह पुराने बैंक वेयरहाउसों की तरह छोटे किए गए अस्पष्ट नामों का इस्तेमाल करता है, जैसे F_ACCT_BAL_D, पर कॉलम के विवरण बने रहते हैं। डेटा और सही जवाब वही रहते हैं।
तीनों ने हर बार स्पष्टीकरण माँगा जब उन्हें माँगना चाहिए था, और gpt-oss-20b की हर लिखने की कोशिश को SQL जाँच ने रोक दिया।
हर ओपन मॉडल 22 से 39 अंक नीचे गया। नई गलतियाँ ठीक वही थीं जिन्हें पढ़ने योग्य नाम रोकते थे: अंदाज़े से चुना गया कॉलम, या संक्षिप्त नाम से गलत समझी गई टेबल। किसी भी ओपन मॉडल ने कोई लिखने का अनुरोध आगे नहीं जाने दिया।
क्लोज़्ड मॉडल सिर्फ़ तुलना के लिए हैं। वे किसी बैंक के अपने हार्डवेयर पर नहीं चल सकते, इसलिए उन्हें OpenRouter के ज़रिए बुलाया जाता है। ओपन वेट्स वाले मॉडल vLLM के साथ किराए के GPU पर चलते हैं, जिसे बाद में हटा दिया जाता है, आमतौर पर 12 मिनट के भीतर और एक डॉलर से काफ़ी कम में।
अक्टूबर से ऐप एजेंट के रूप में भी जवाब दे सकता है, और बेंचमार्क दोनों मोड को एक ही सवालों, डेटा और मॉडल पर चलाता है। इसमें 17 और कठिन सवाल जोड़े गए हैं, जैसे किसी पिछली तारीख पर किसी रिकॉर्ड का इतिहास, रोज़ की दरों से मुद्रा रूपांतरण, माध्यिका, और हर तिमाही में सक्रिय ग्राहक। इन रनों में A100 पर अस्पष्ट नामों का इस्तेमाल हुआ, और हर सवाल तीन बार पूछा गया।
| मॉडल | कठिन सवाल, एजेंट | कठिन सवाल, पाइपलाइन | मूल 23, एजेंट | मूल 23, पाइपलाइन | एजेंट: आत्मविश्वास से गलत | एजेंट का जवाब समय |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 सेकंड |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 सेकंड |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 सेकंड |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 सेकंड |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 सेकंड |
आत्मविश्वास से गलत में मूल 23 सवालों पर और मौजूद न होने वाले डेटा के सवालों पर एजेंट की गलतियाँ गिनी जाती हैं। जवाब समय माध्यिका है। तुलना के लिए, पाइपलाइन के रूप में काम करते बंद मॉडलों के कठिन सवालों पर नतीजे: Claude Sonnet 5 71%, Gemini 3.8 Flash 69%, GPT-4.1 mini 55%, GPT-4.1 49%, और GPT-6 Luna 22%, क्योंकि वह ज़्यादातर पर उल्टा सवाल पूछता है। एजेंट के रूप में काम करता हर खुला मॉडल पाइपलाइन के रूप में काम करते हर बंद मॉडल से आगे रहा।
एजेंट को हिस्सों में बाँटकर, मूल 23 सवालों पर gpt-oss-20b के साथ, दिखता है कि हर हिस्सा क्या जोड़ता है।
कठिन सवालों पर gpt-oss-20b की गलतियाँ ऐसे ड्राफ़्ट हैं जो चलते हैं और गलत जवाब लौटाते हैं, जिन्हें परखना पकड़ नहीं सकता।
ऐप का Model tests टैब हर दर्ज रन को सँभालकर रखता है। ये तालिकाएँ 27 सितंबर 2026 की उसकी रिपोर्ट से हैं, सबसे ज़्यादा सही वाले पहले। ओपन वेट्स वाले मॉडल किसी बैंक के अपने हार्डवेयर पर चल सकते हैं; क्लोज़्ड मॉडल तुलना के लिए OpenRouter के ज़रिए बुलाए गए।
| मॉडल | सही | आत्मविश्वास से गलत | जवाबी सवाल | असुरक्षित लेखन |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| मॉडल | सही | आत्मविश्वास से गलत | जवाबी सवाल | असुरक्षित लेखन |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
हर सवाल तीन बार पूछा जाता है। सही, एक सही जवाब वाले सवालों के 69 जवाबों में सही जवाबों का हिस्सा है। आत्मविश्वास से गलत उन ड्राफ़्ट को गिनता है जो चले पर गलत नतीजा दिया, और उन ड्राफ़्ट को जो ऐसे डेटा के लिए बने जो वेयरहाउस में है ही नहीं। जवाबी सवाल, गायब डेटा वाले सवालों के 18 जवाबों में से गिने जाते हैं, और असुरक्षित लेखन बताता है कि डेटा बदलने के अनुरोधों के 15 जवाबों में से कितने उपयोगकर्ता तक पहुँचे।
दो और रन को अंक नहीं दिए गए। Gemma 4 26B सख़्त JSON आउटपुट में लूप में फँस गया, जो गुणवत्ता का पैमाना नहीं बल्कि चलाने की गड़बड़ी है, और Devstral Small 2 A100 पर चलता ही नहीं।
रिपोर्ट नतीजों को सवाल-दर-सवाल भी दिखाती है, और वहीं अस्पष्ट नामों की कीमत दिखती है। उनके साथ कोई भी मॉडल उन पाँच सवालों का जवाब नहीं दे पाया जिन्हें Qwen3.8-27B वर्णनात्मक नामों के साथ हर बार सही करता था, जैसे 90 दिन से ज़्यादा बकाया ऋणों की संख्या।
ऐप किसी भी OpenAI-संगत एंडपॉइंट से बात कर सकता है, इसलिए होस्टेड प्रदाता से बैंक के अपने सर्वर पर जाना एक साधारण कॉन्फ़िगरेशन बदलाव जैसा लगता है। एक अलग मूल्यांकन टूल जाँचता है कि क्या सच में ऐसा है। वही gpt-oss-20b वेट्स एक होस्टेड प्रदाता, CPU, और llama.cpp, vLLM तथा SGLang के ज़रिए किराए के GPU पर चलाए गए।
हर सर्वर ने सही टेबल चुनीं। अंतर कहीं और दिखे: ड्राफ़्ट में कौन-से वैकल्पिक जॉइन जोड़े गए, कोई विनाशकारी अनुरोध तुरंत मना हुआ या बाद में SQL जाँच ने पकड़ा, और लोड के दौरान। vLLM ने 64 एक साथ अनुरोधों पर भी सख़्त JSON फ़ॉर्मेट बनाए रखा और एक RTX 4090 पर लगभग 270 सवाल प्रति मिनट तक पहुँचा। SGLang ने लोड में यह फ़ॉर्मेट तोड़ दिया, जब तक उसे ज़्यादा सख़्त सेटिंग के साथ शुरू नहीं किया गया। यह गड़बड़ी एक-एक अनुरोध भेजने पर कभी नहीं दिखी।
एक और प्रयोग में कैटलॉग को मेनफ़्रेम-शैली के संक्षिप्त नामों से दोबारा लिखा गया। टेबल और कॉलम के विवरण रखने पर दोनों मॉडल सभी बारह आधारभूत सवालों में पास हुए। विवरण हटाने पर सिर्फ़ आधे पास हुए, जो साफ़ दिखाता है कि अच्छा मेटाडेटा उतना ही ज़रूरी है जितना मॉडल।
बेंचमार्क के दस कठिन सवाल, चौड़े डेस्कटॉप से लेकर छोटे फ़ोन तक। हर SQL ड्राफ़्ट ऐप की अपनी पाइपलाइन और मॉडल ने लिखा, फिर डेटा से भरे वेयरहाउस पर चलाकर सत्यापित किया गया; दसों ने सही जवाब दिया। स्क्रीनशॉट इन रिकॉर्ड किए गए जवाबों को दोबारा दिखाते हैं, इसलिए इन्हें दोहराया जा सकता है और इनमें कोई असली बैंकिंग डेटा नहीं है।
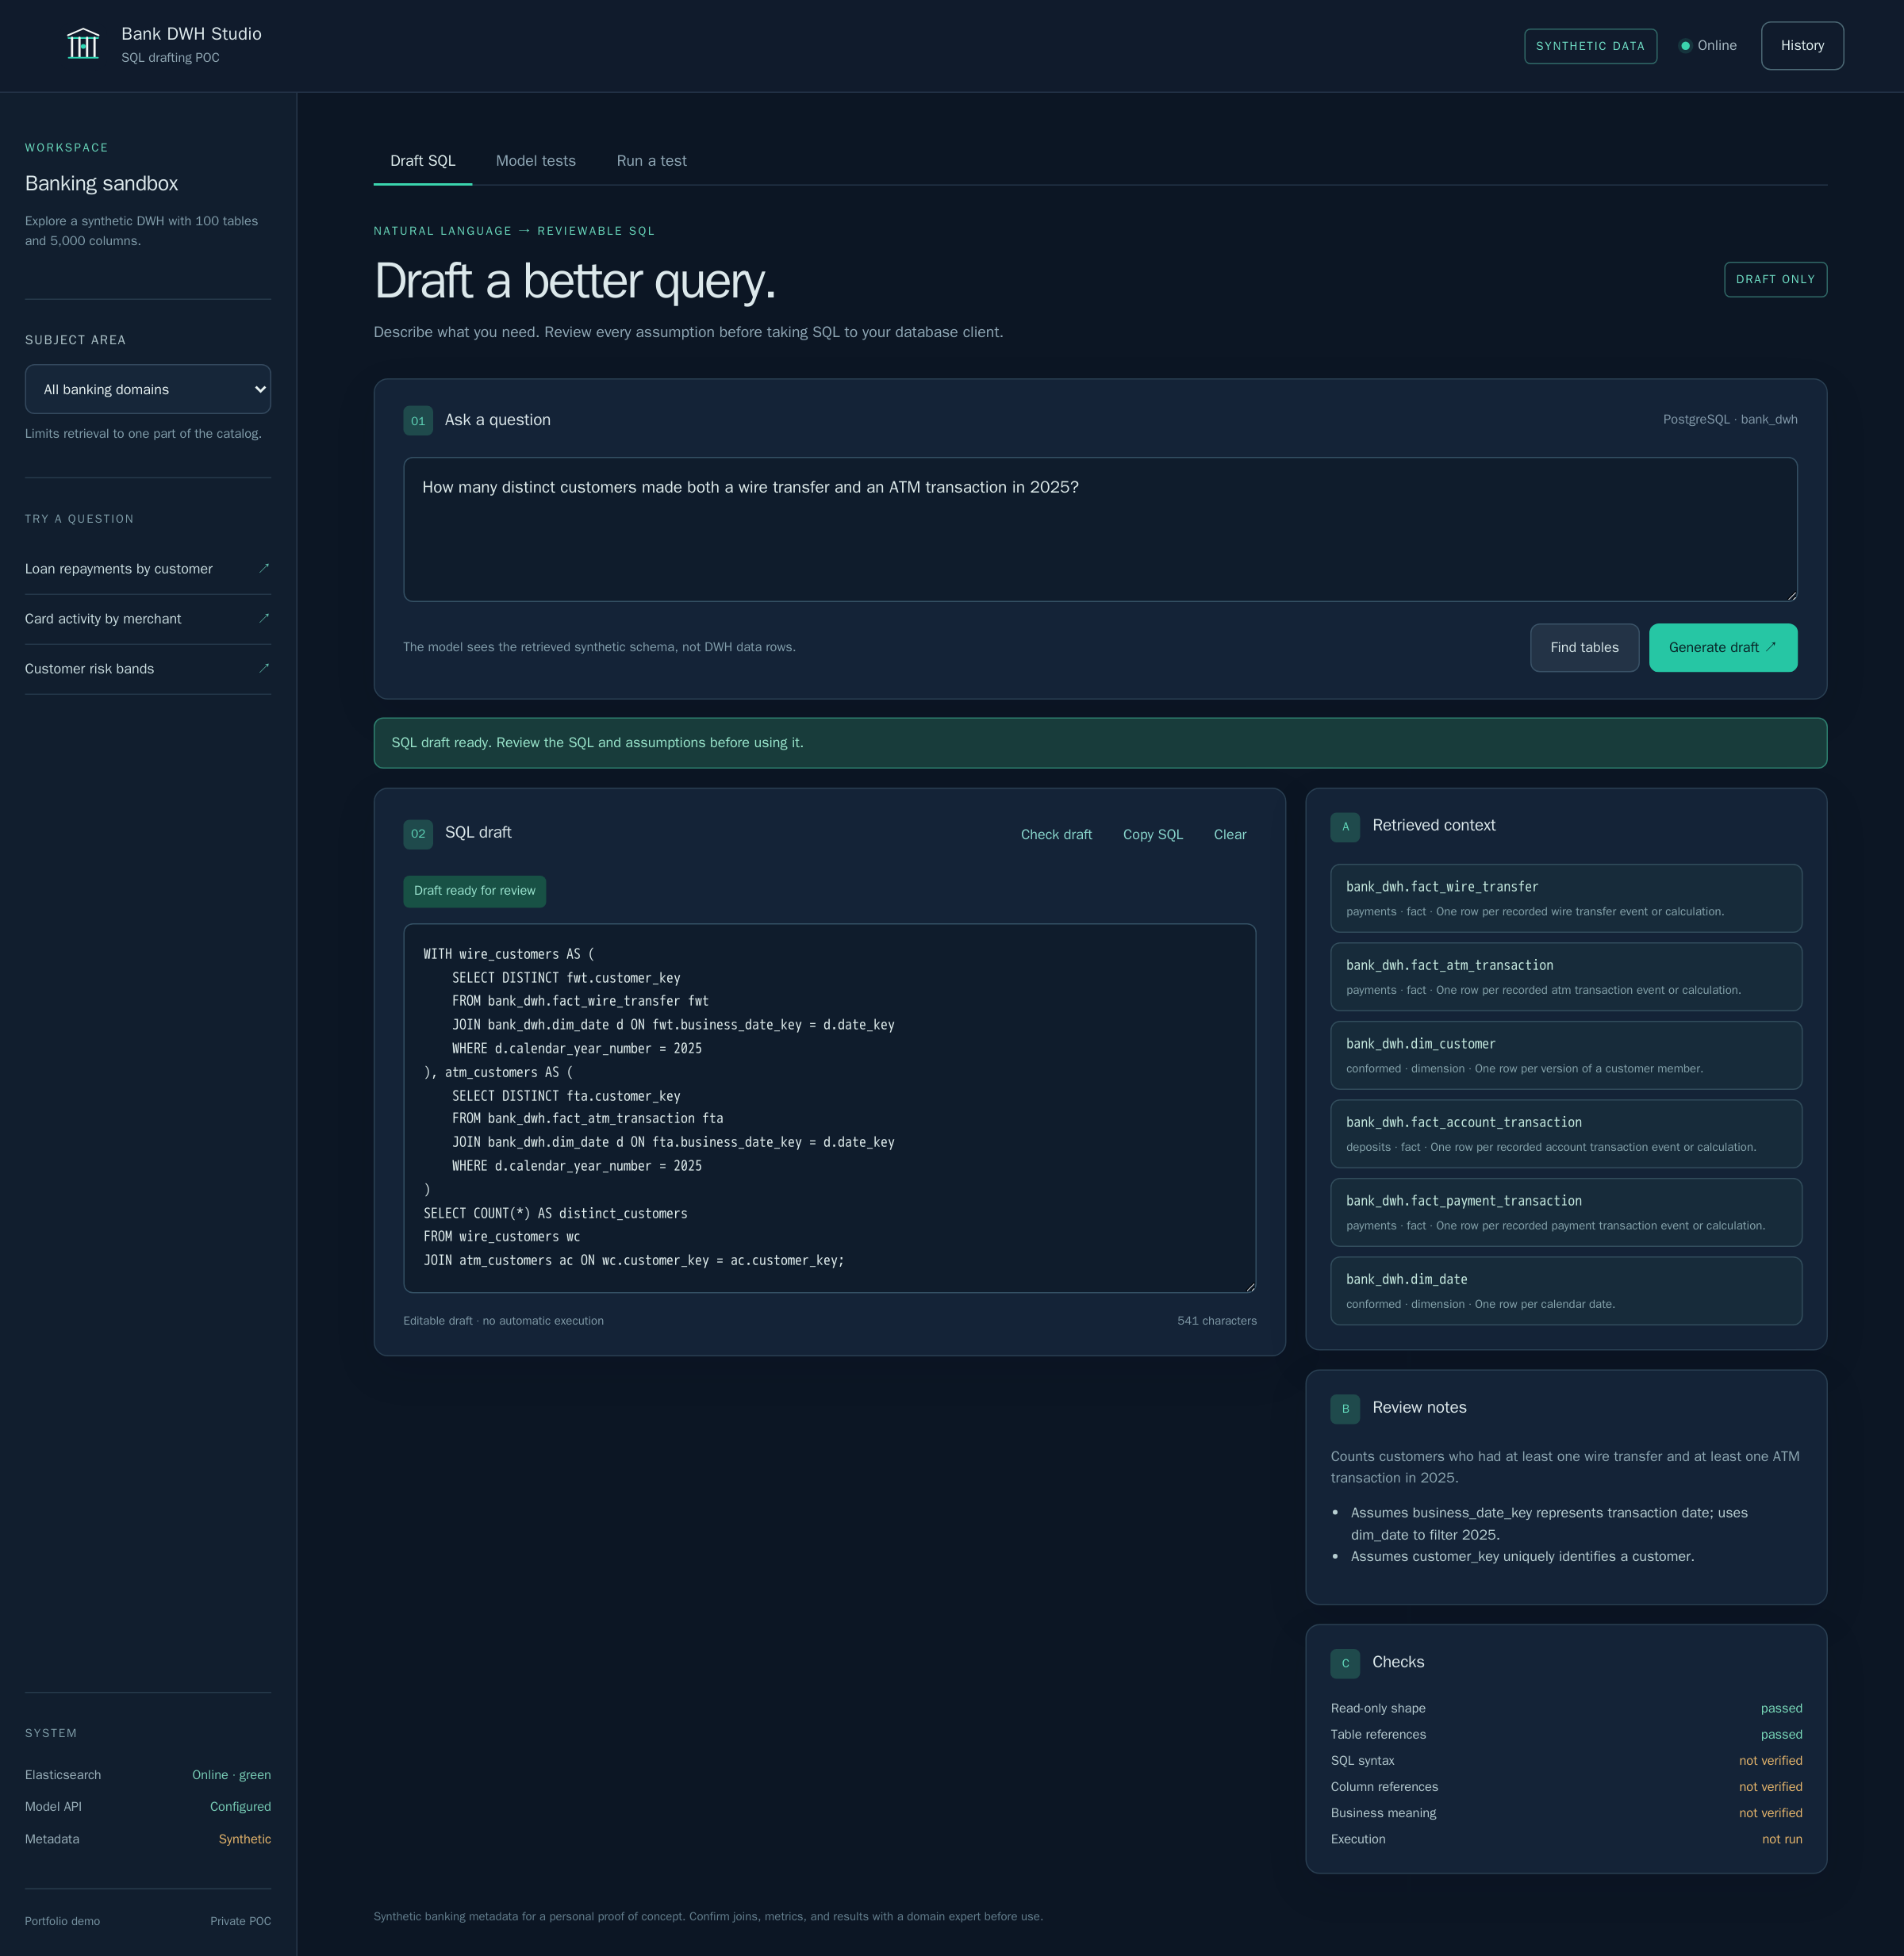
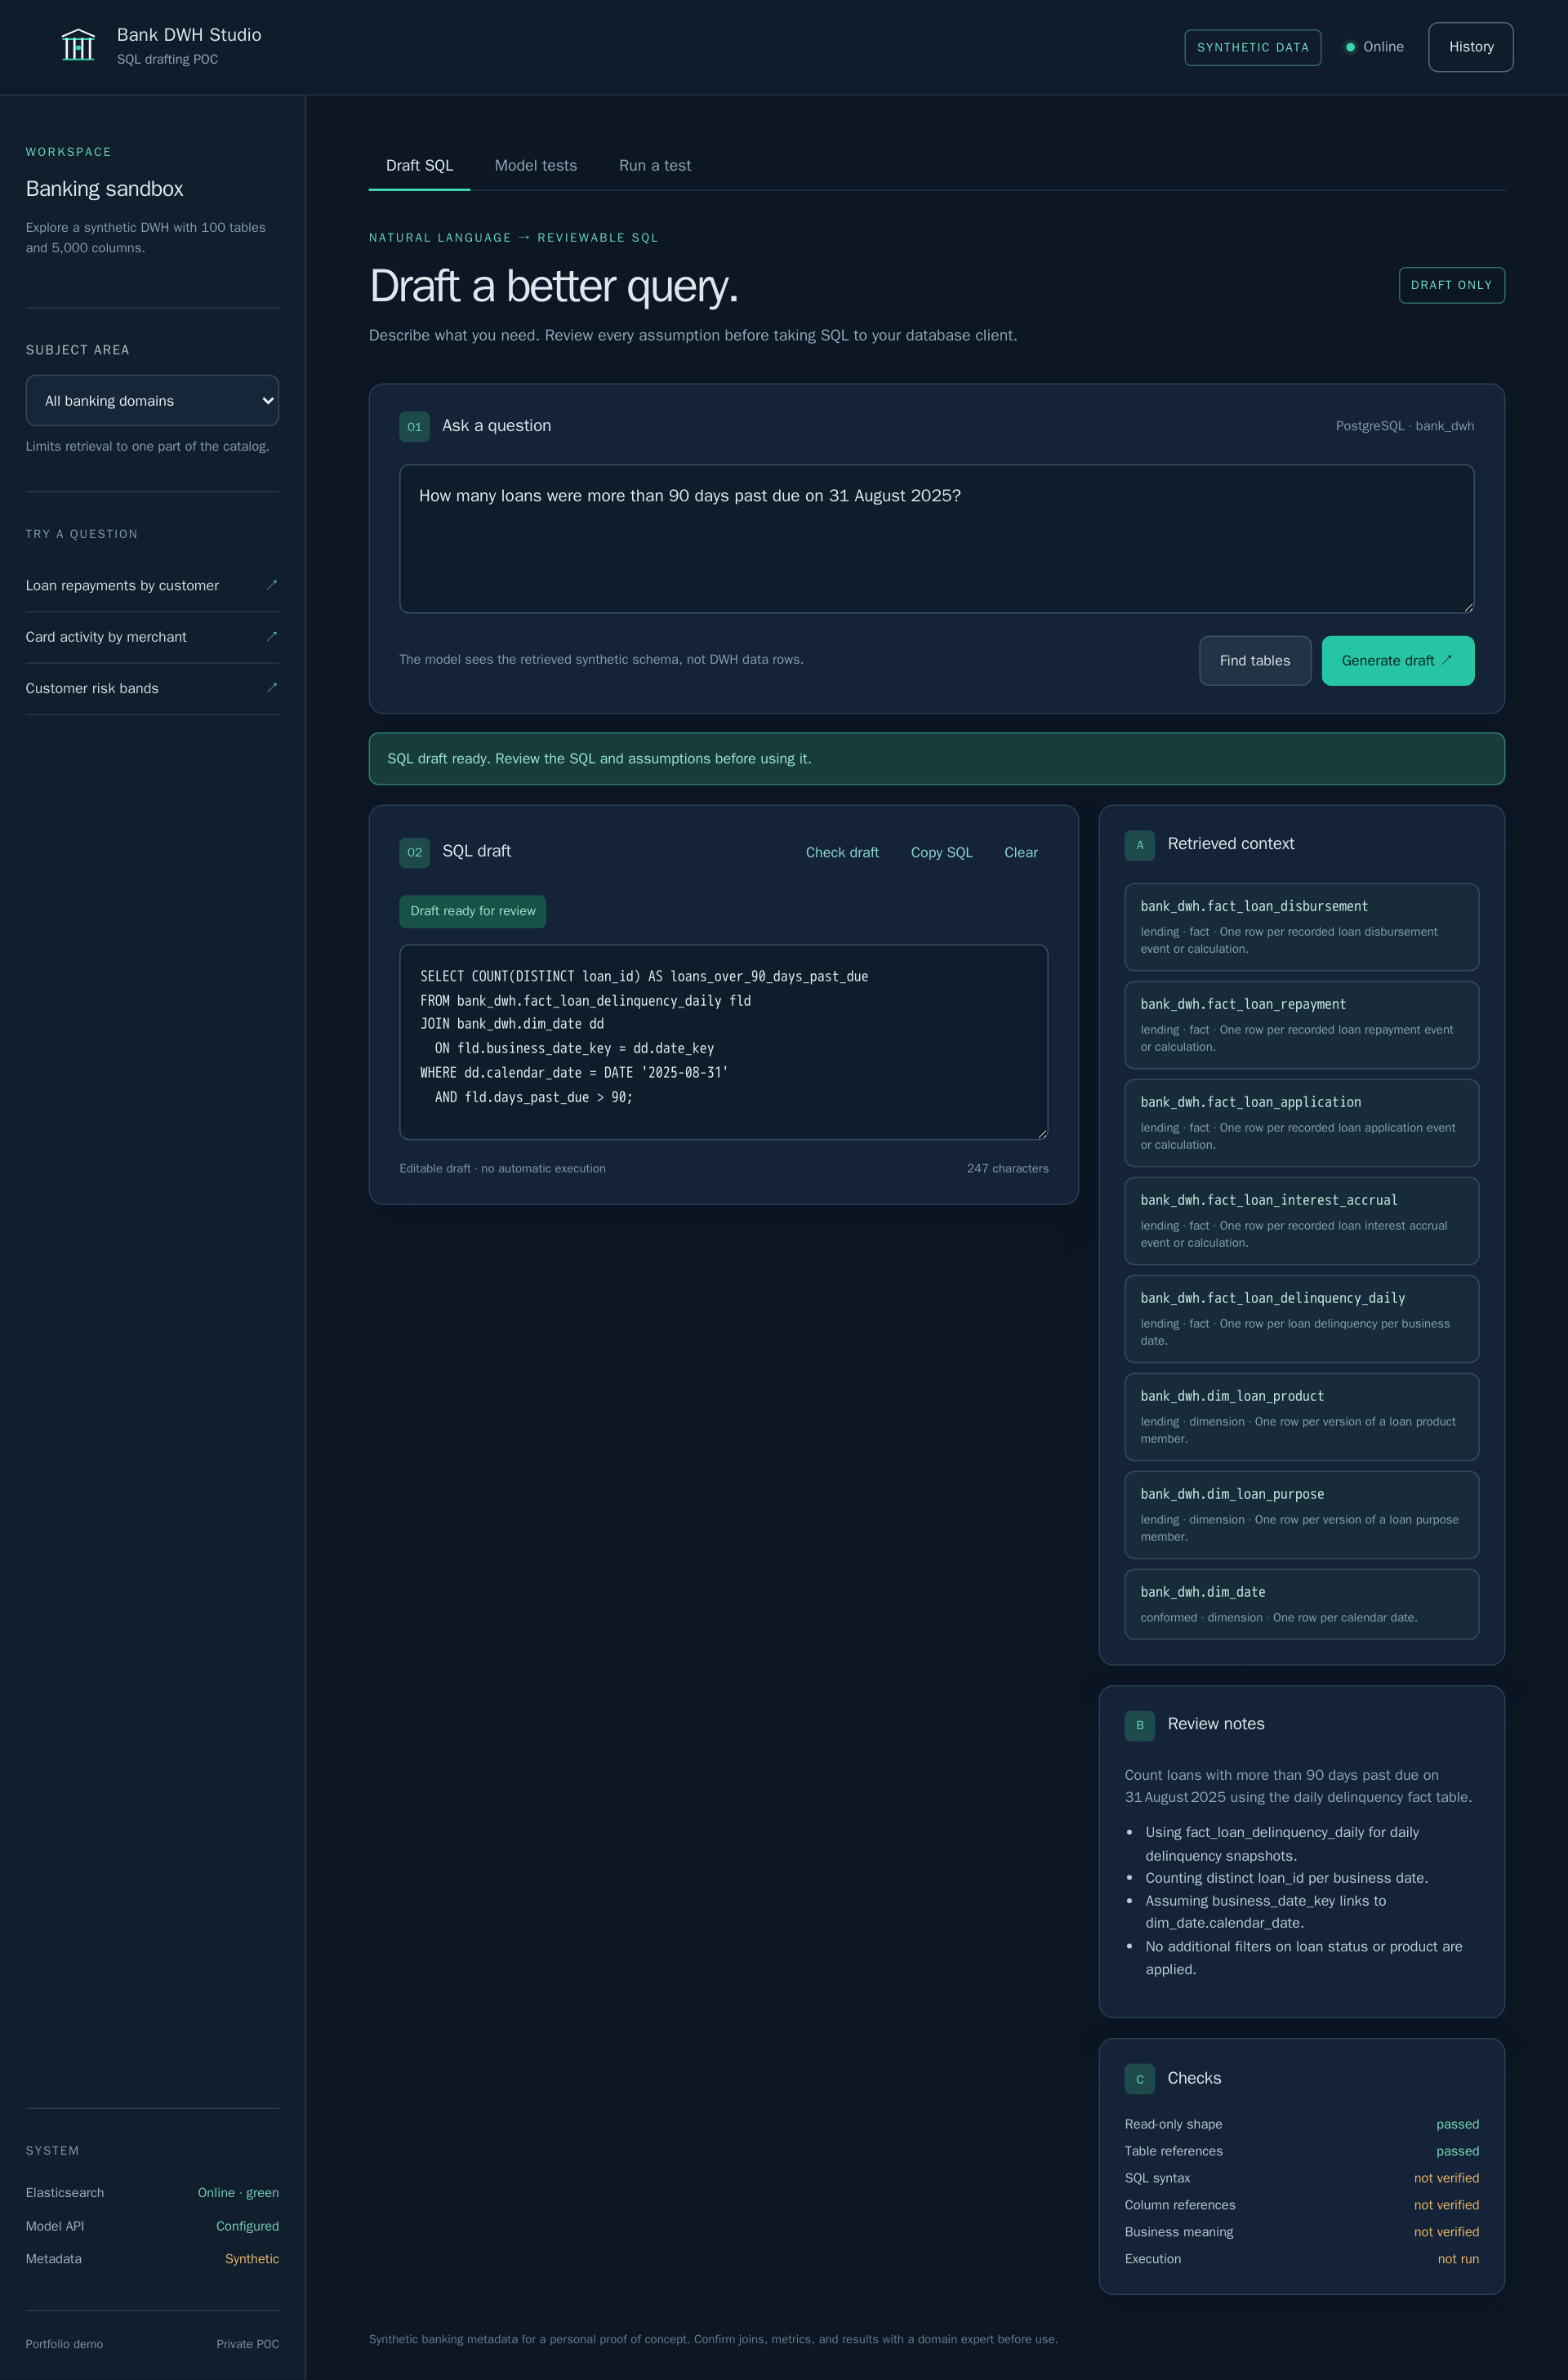
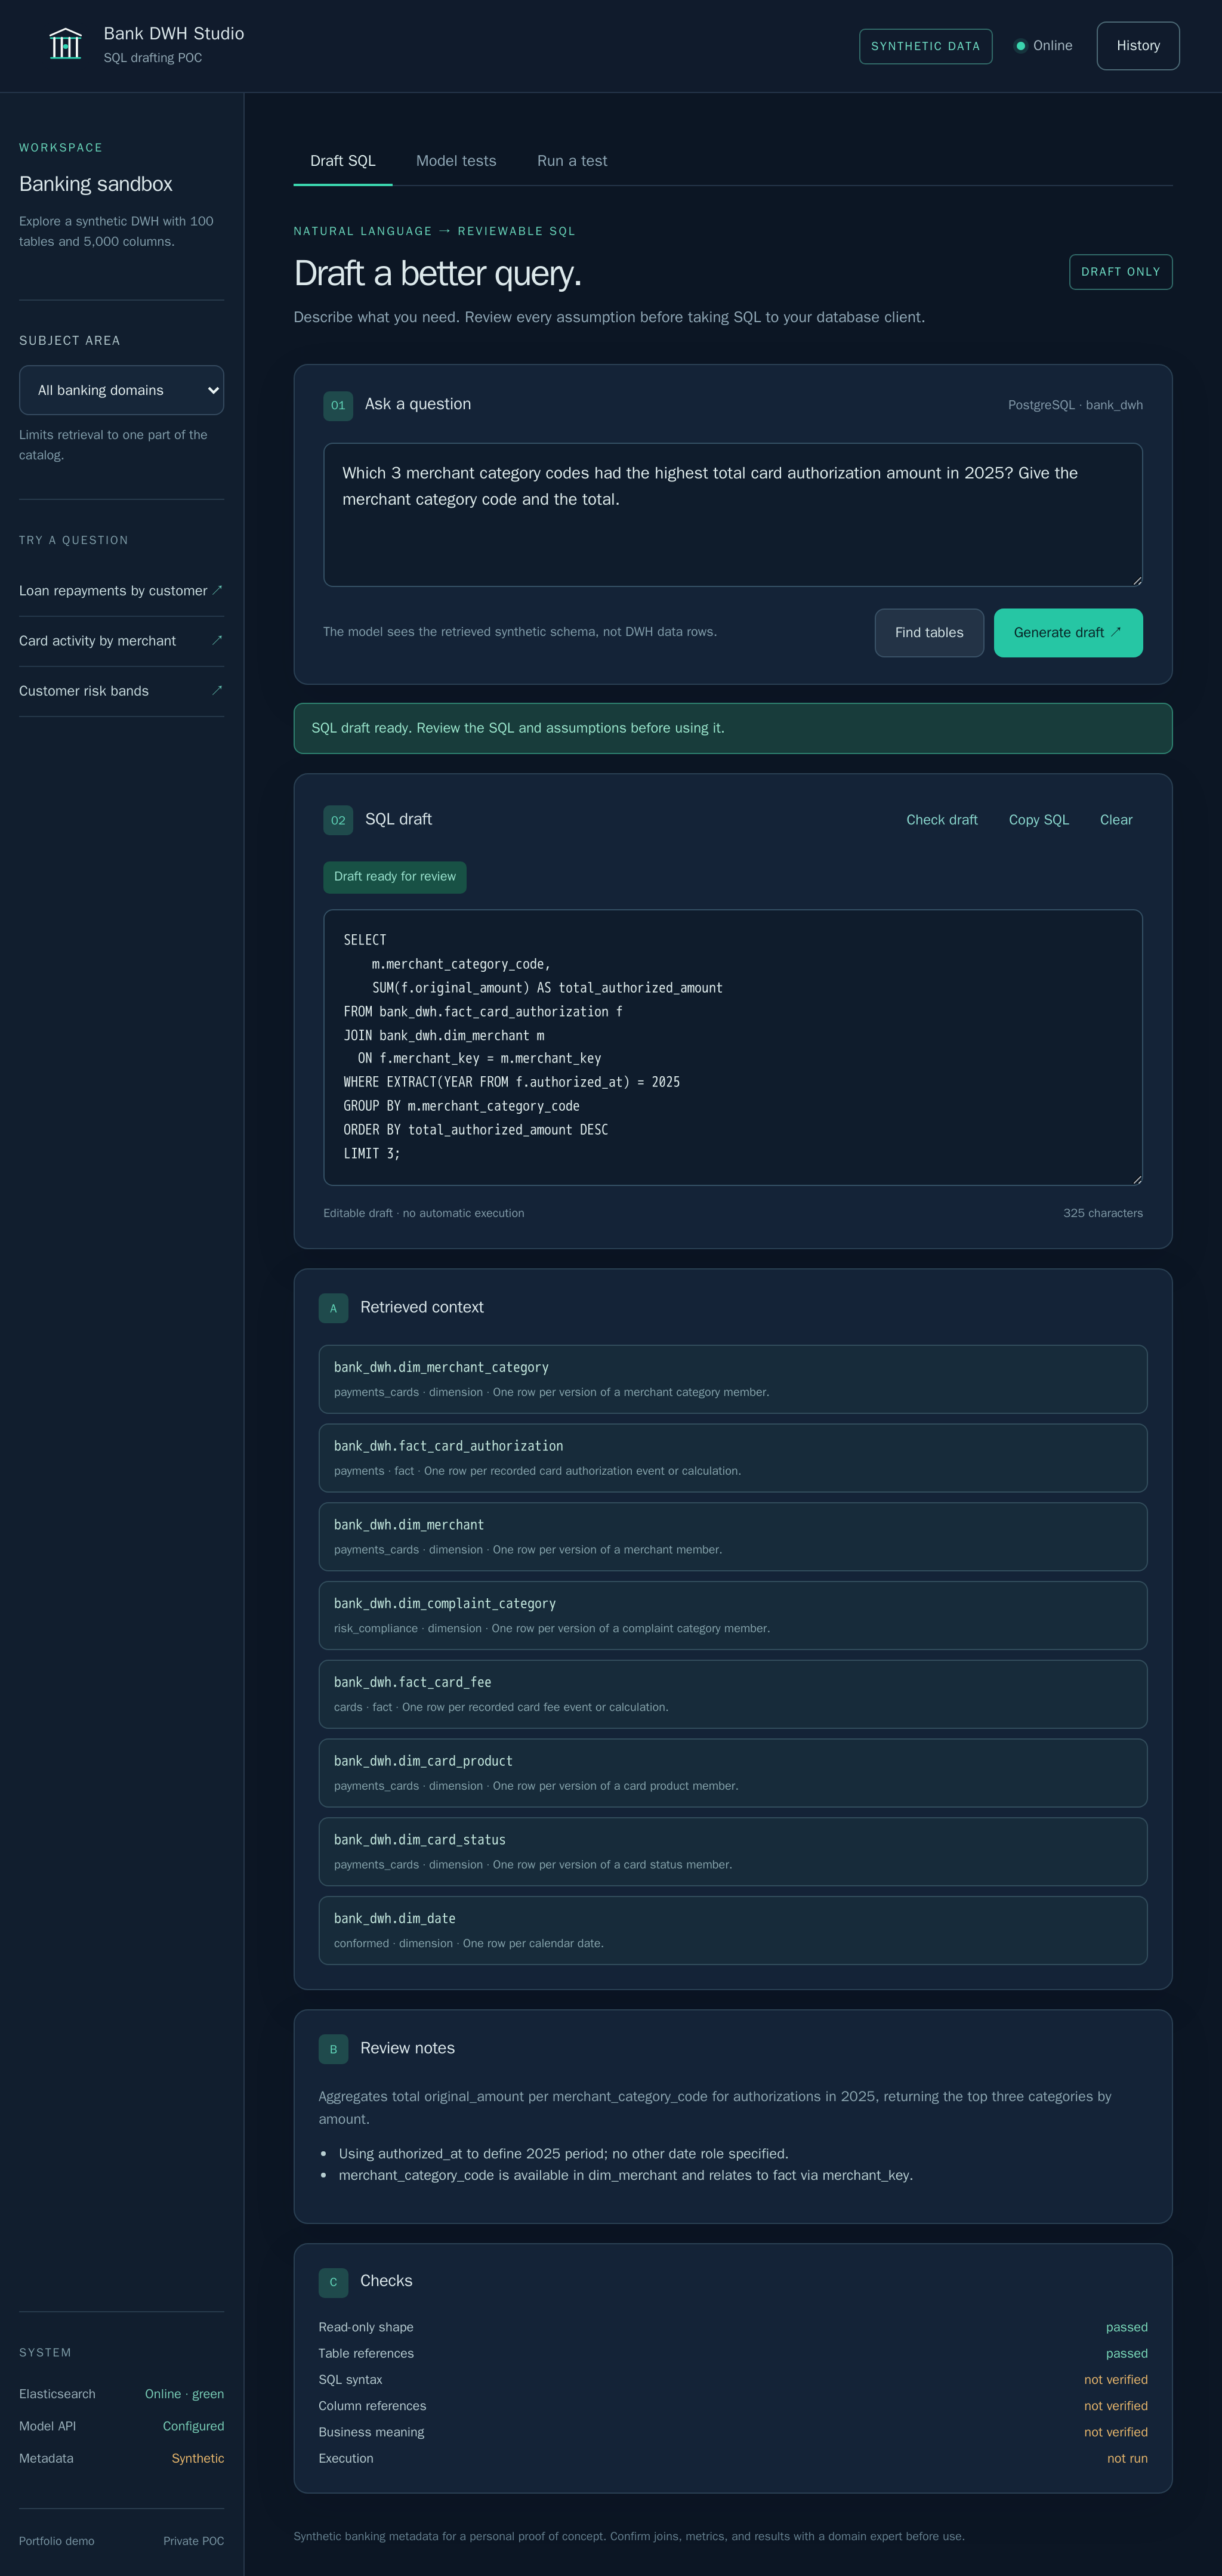
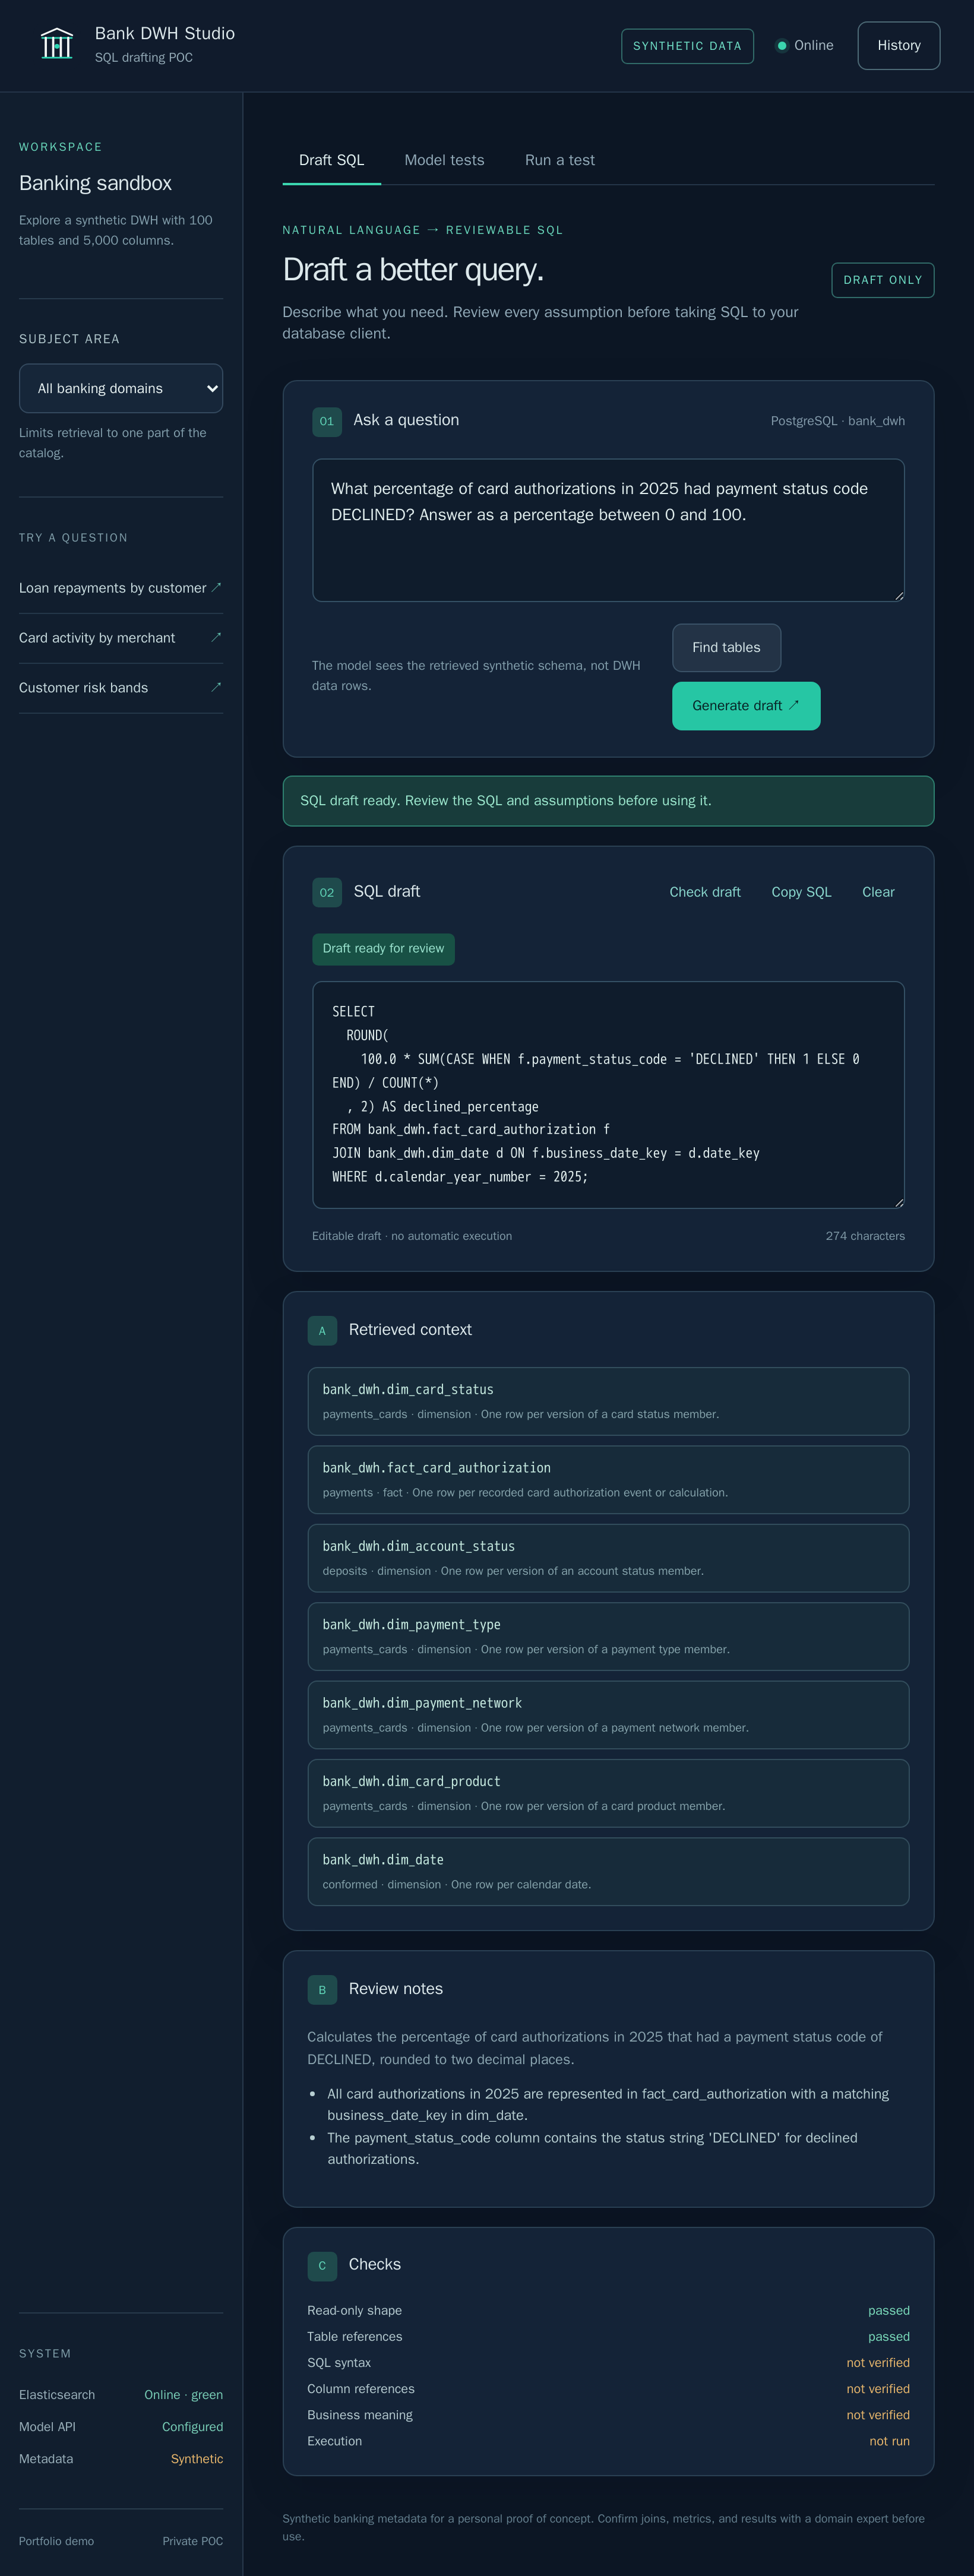
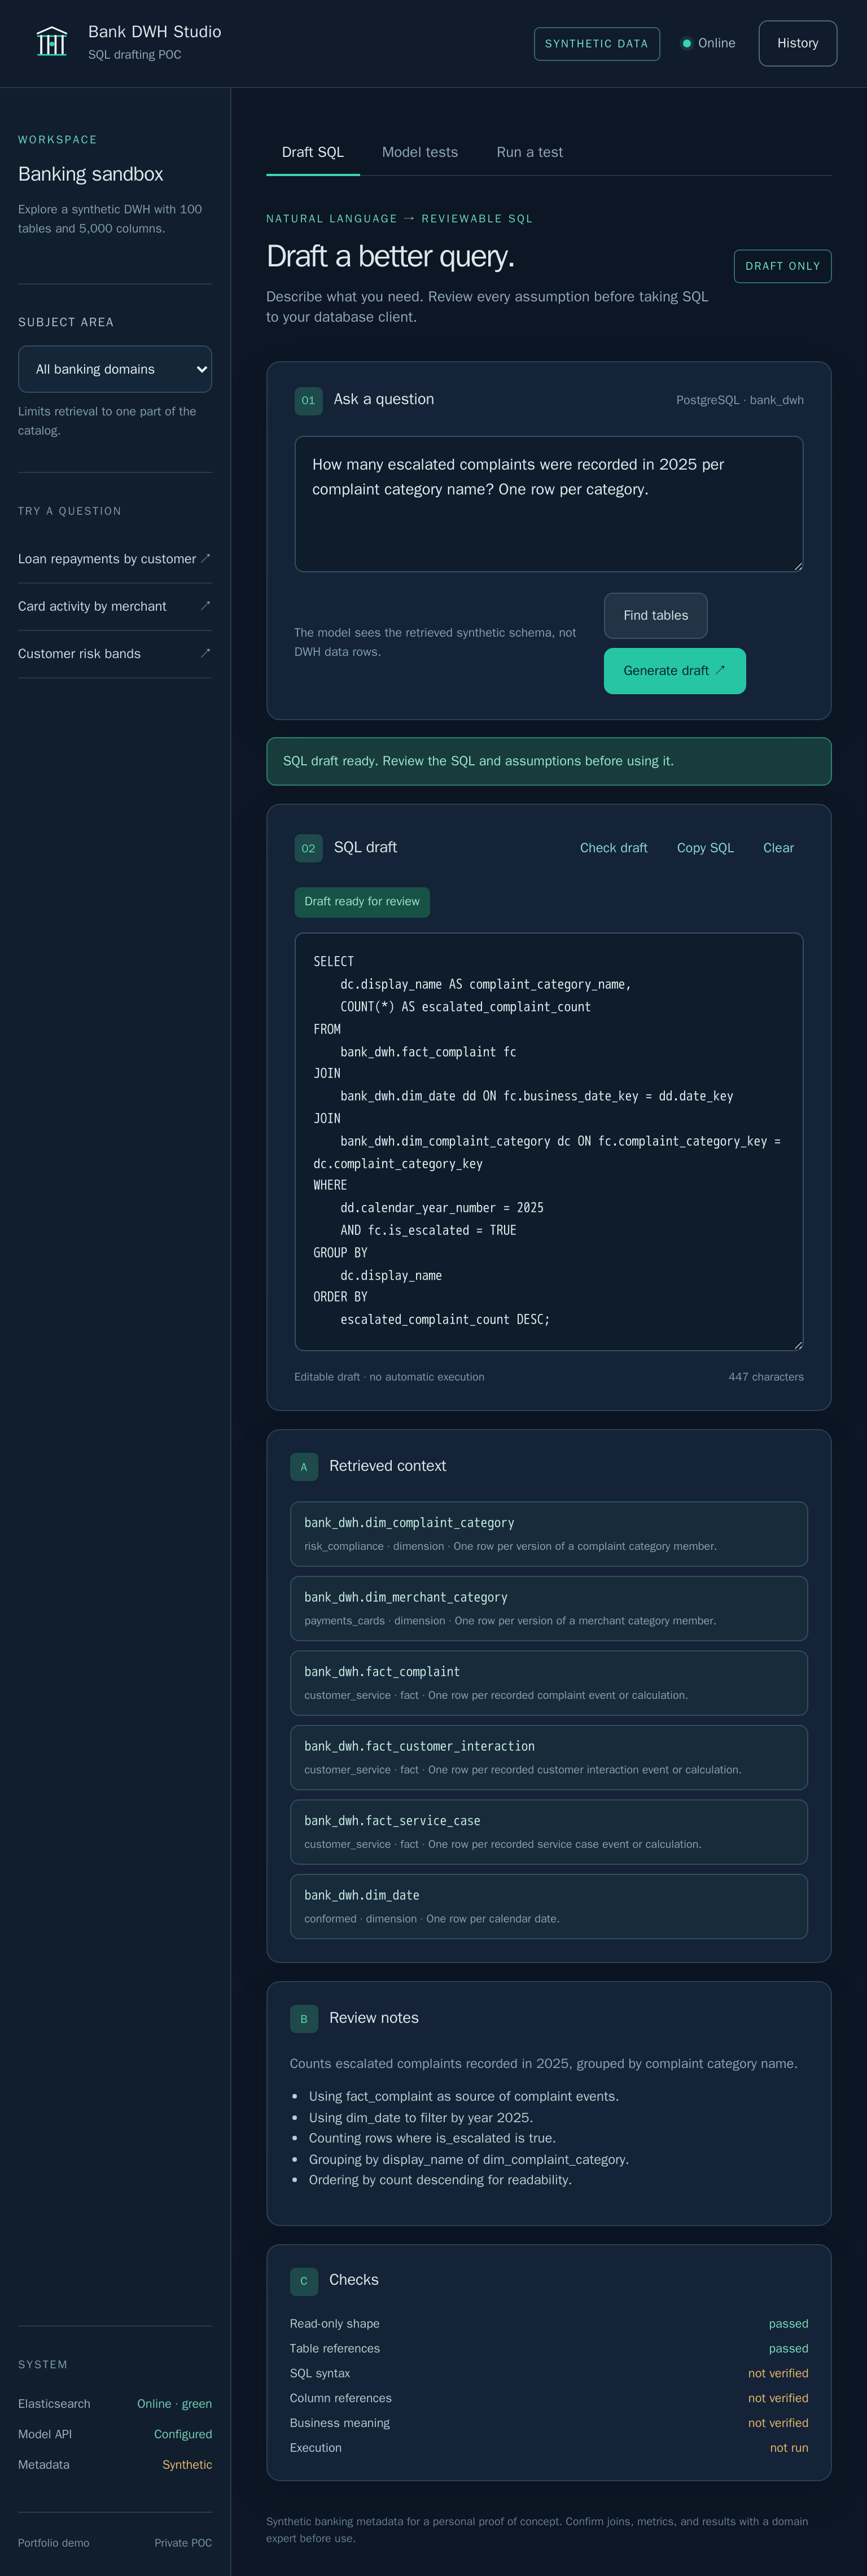
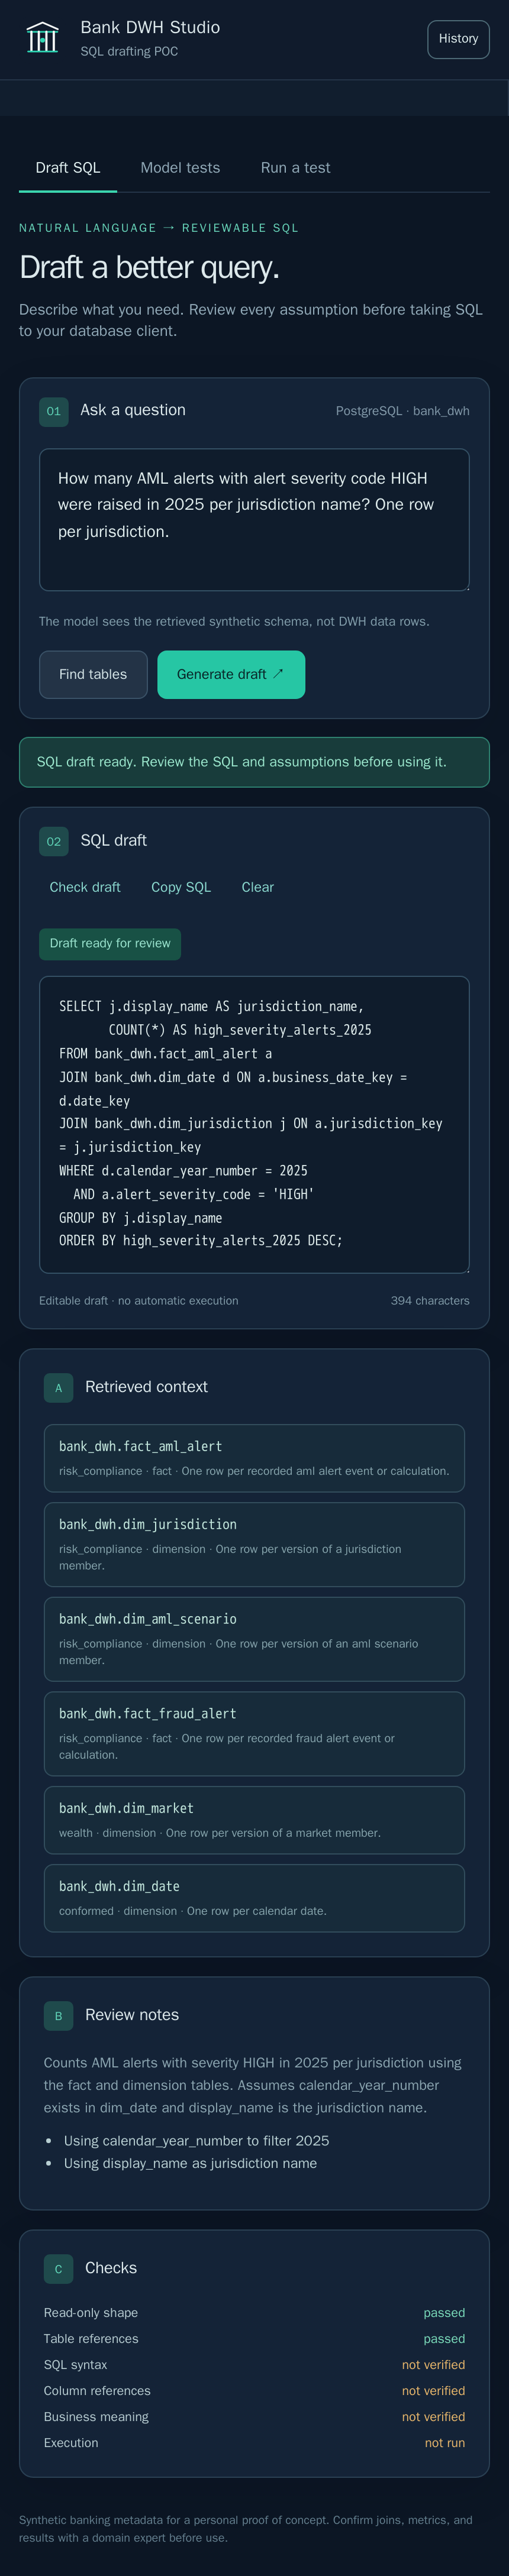
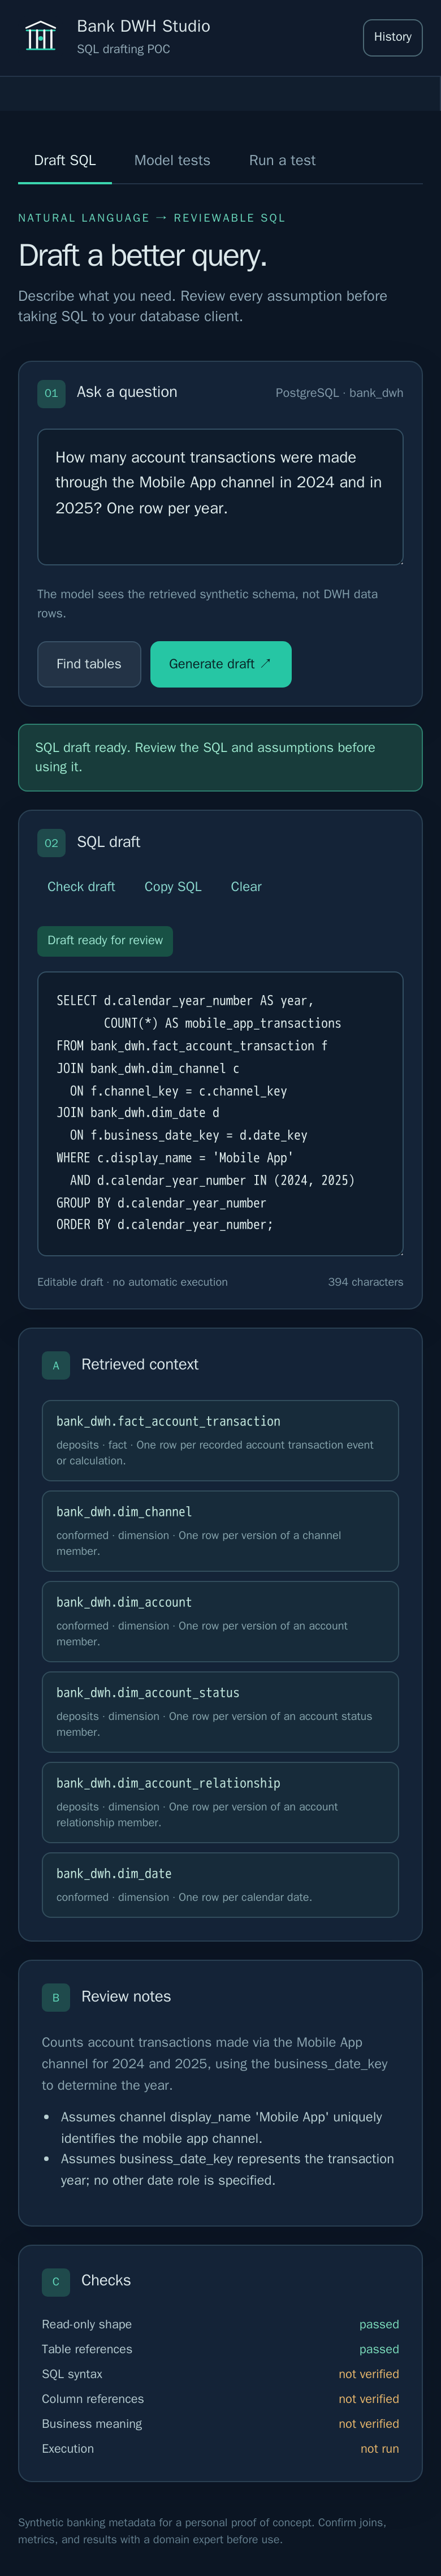
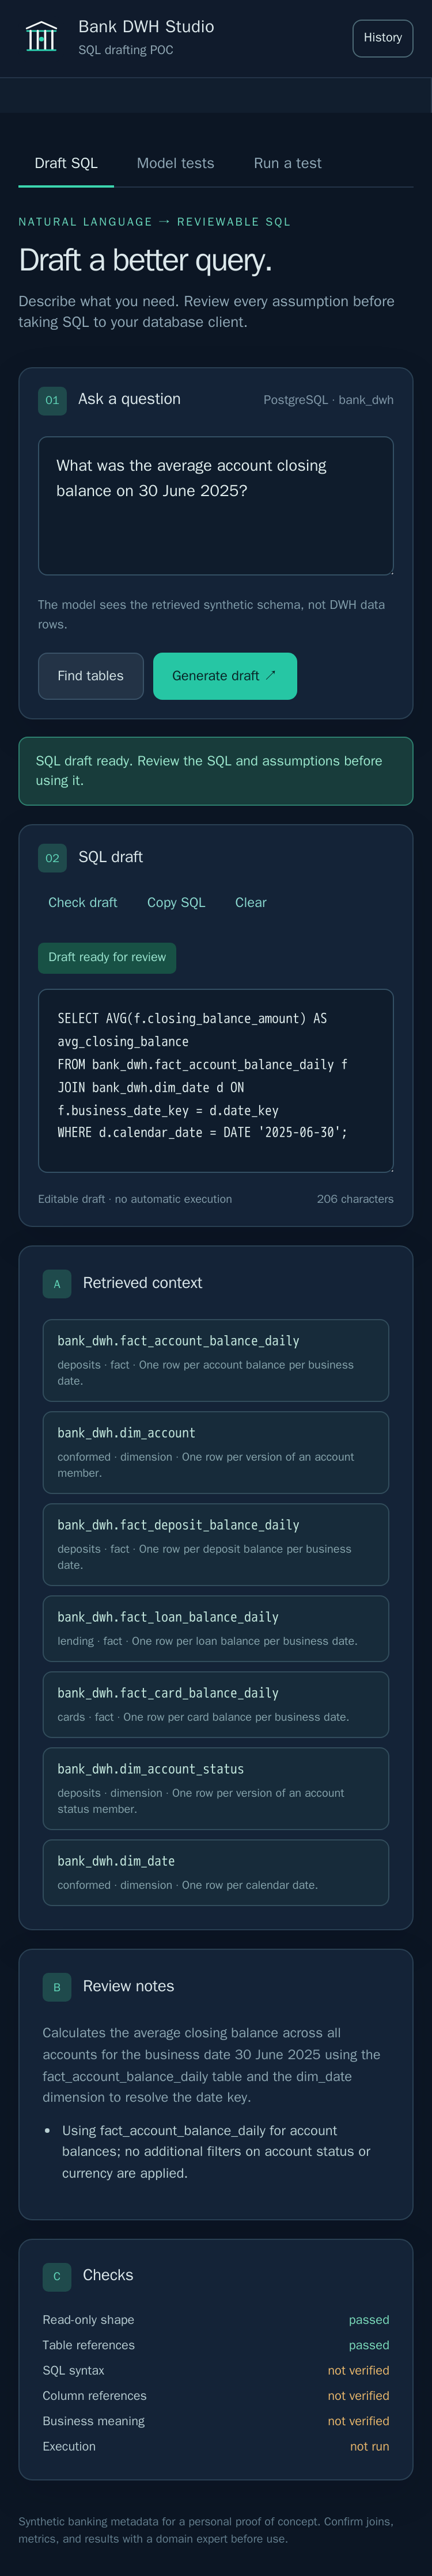
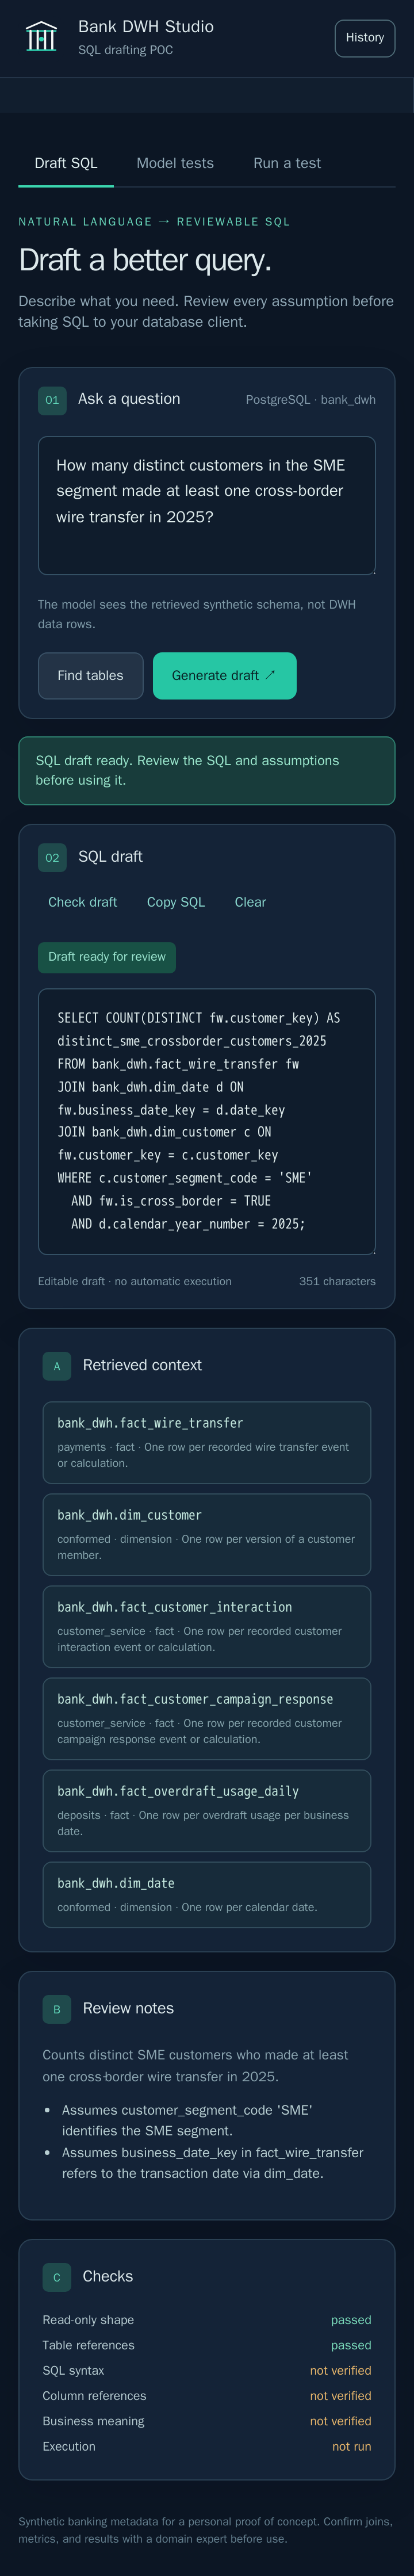
ऐप SQL ड्राफ़्ट लिखता और परखता है, पर सिर्फ़ वेयरहाउस की सिंथेटिक कॉपी पर, ऐसे उपयोगकर्ता के रूप में जो सिर्फ़ पढ़ सकता है; यह कभी किसी असली बैंकिंग वेयरहाउस से नहीं जुड़ता। उपयोगकर्ता अब भी नतीजे की समीक्षा करते हैं, फिर उसे संपादित या कॉपी करके अपने डेटाबेस क्लाइंट में चलाते हैं। ब्राउज़र को मॉडल की API कुंजी कभी नहीं मिलती।
स्वचालित जाँच केवल रीड-ओनली स्टेटमेंट की बुनियादी संरचना और ज्ञात टेबल संदर्भों को जाँचती है। SQL सिंटैक्स, कॉलम संदर्भ और व्यावसायिक अर्थ की मानवीय समीक्षा अभी भी आवश्यक है। वेयरहाउस के सभी नाम, संबंध और माप सिंथेटिक परीक्षण सामग्री हैं, स्वीकृत बैंकिंग परिभाषाएँ नहीं।
तैनात प्रूफ़ ऑफ़ कॉन्सेप्ट Oracle Ampere A1 इंस्टेंस पर Node बैकएंड, Elasticsearch और सिर्फ़ पढ़ने वाले PostgreSQL वेयरहाउस को rootless कंटेनर के रूप में चलाता है, और होस्ट किए गए प्रदाता के ज़रिए gpt-oss-20b से SQL लिखता है। रिपॉज़िटरी एक व्यापक भावी आर्किटेक्चर का भी दस्तावेज़ रखती है, जो तैनात छोटे POC से साफ़ अलग है।