舞台裏の道具
PWA Invite Console
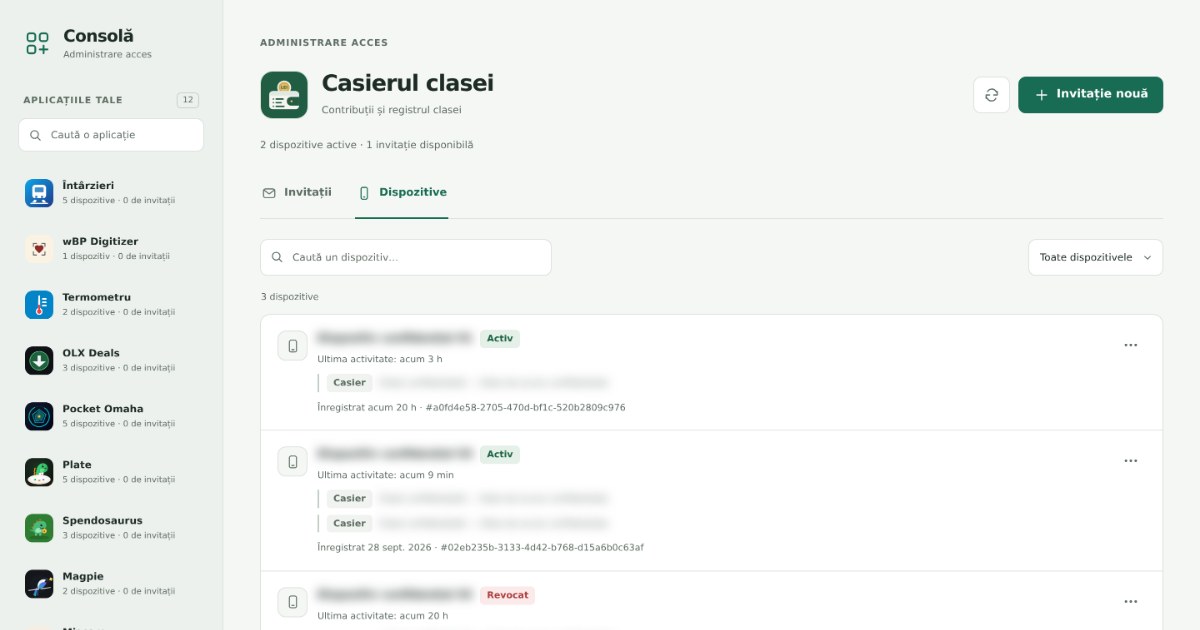
非公開のWebアプリへの招待や端末をまとめて管理する、小さなコンソール。
銀行データについて質問し、関連するスキーマを確認して、編集可能な SQL の草案を手に入れましょう。
ライブ PWA は招待制です。
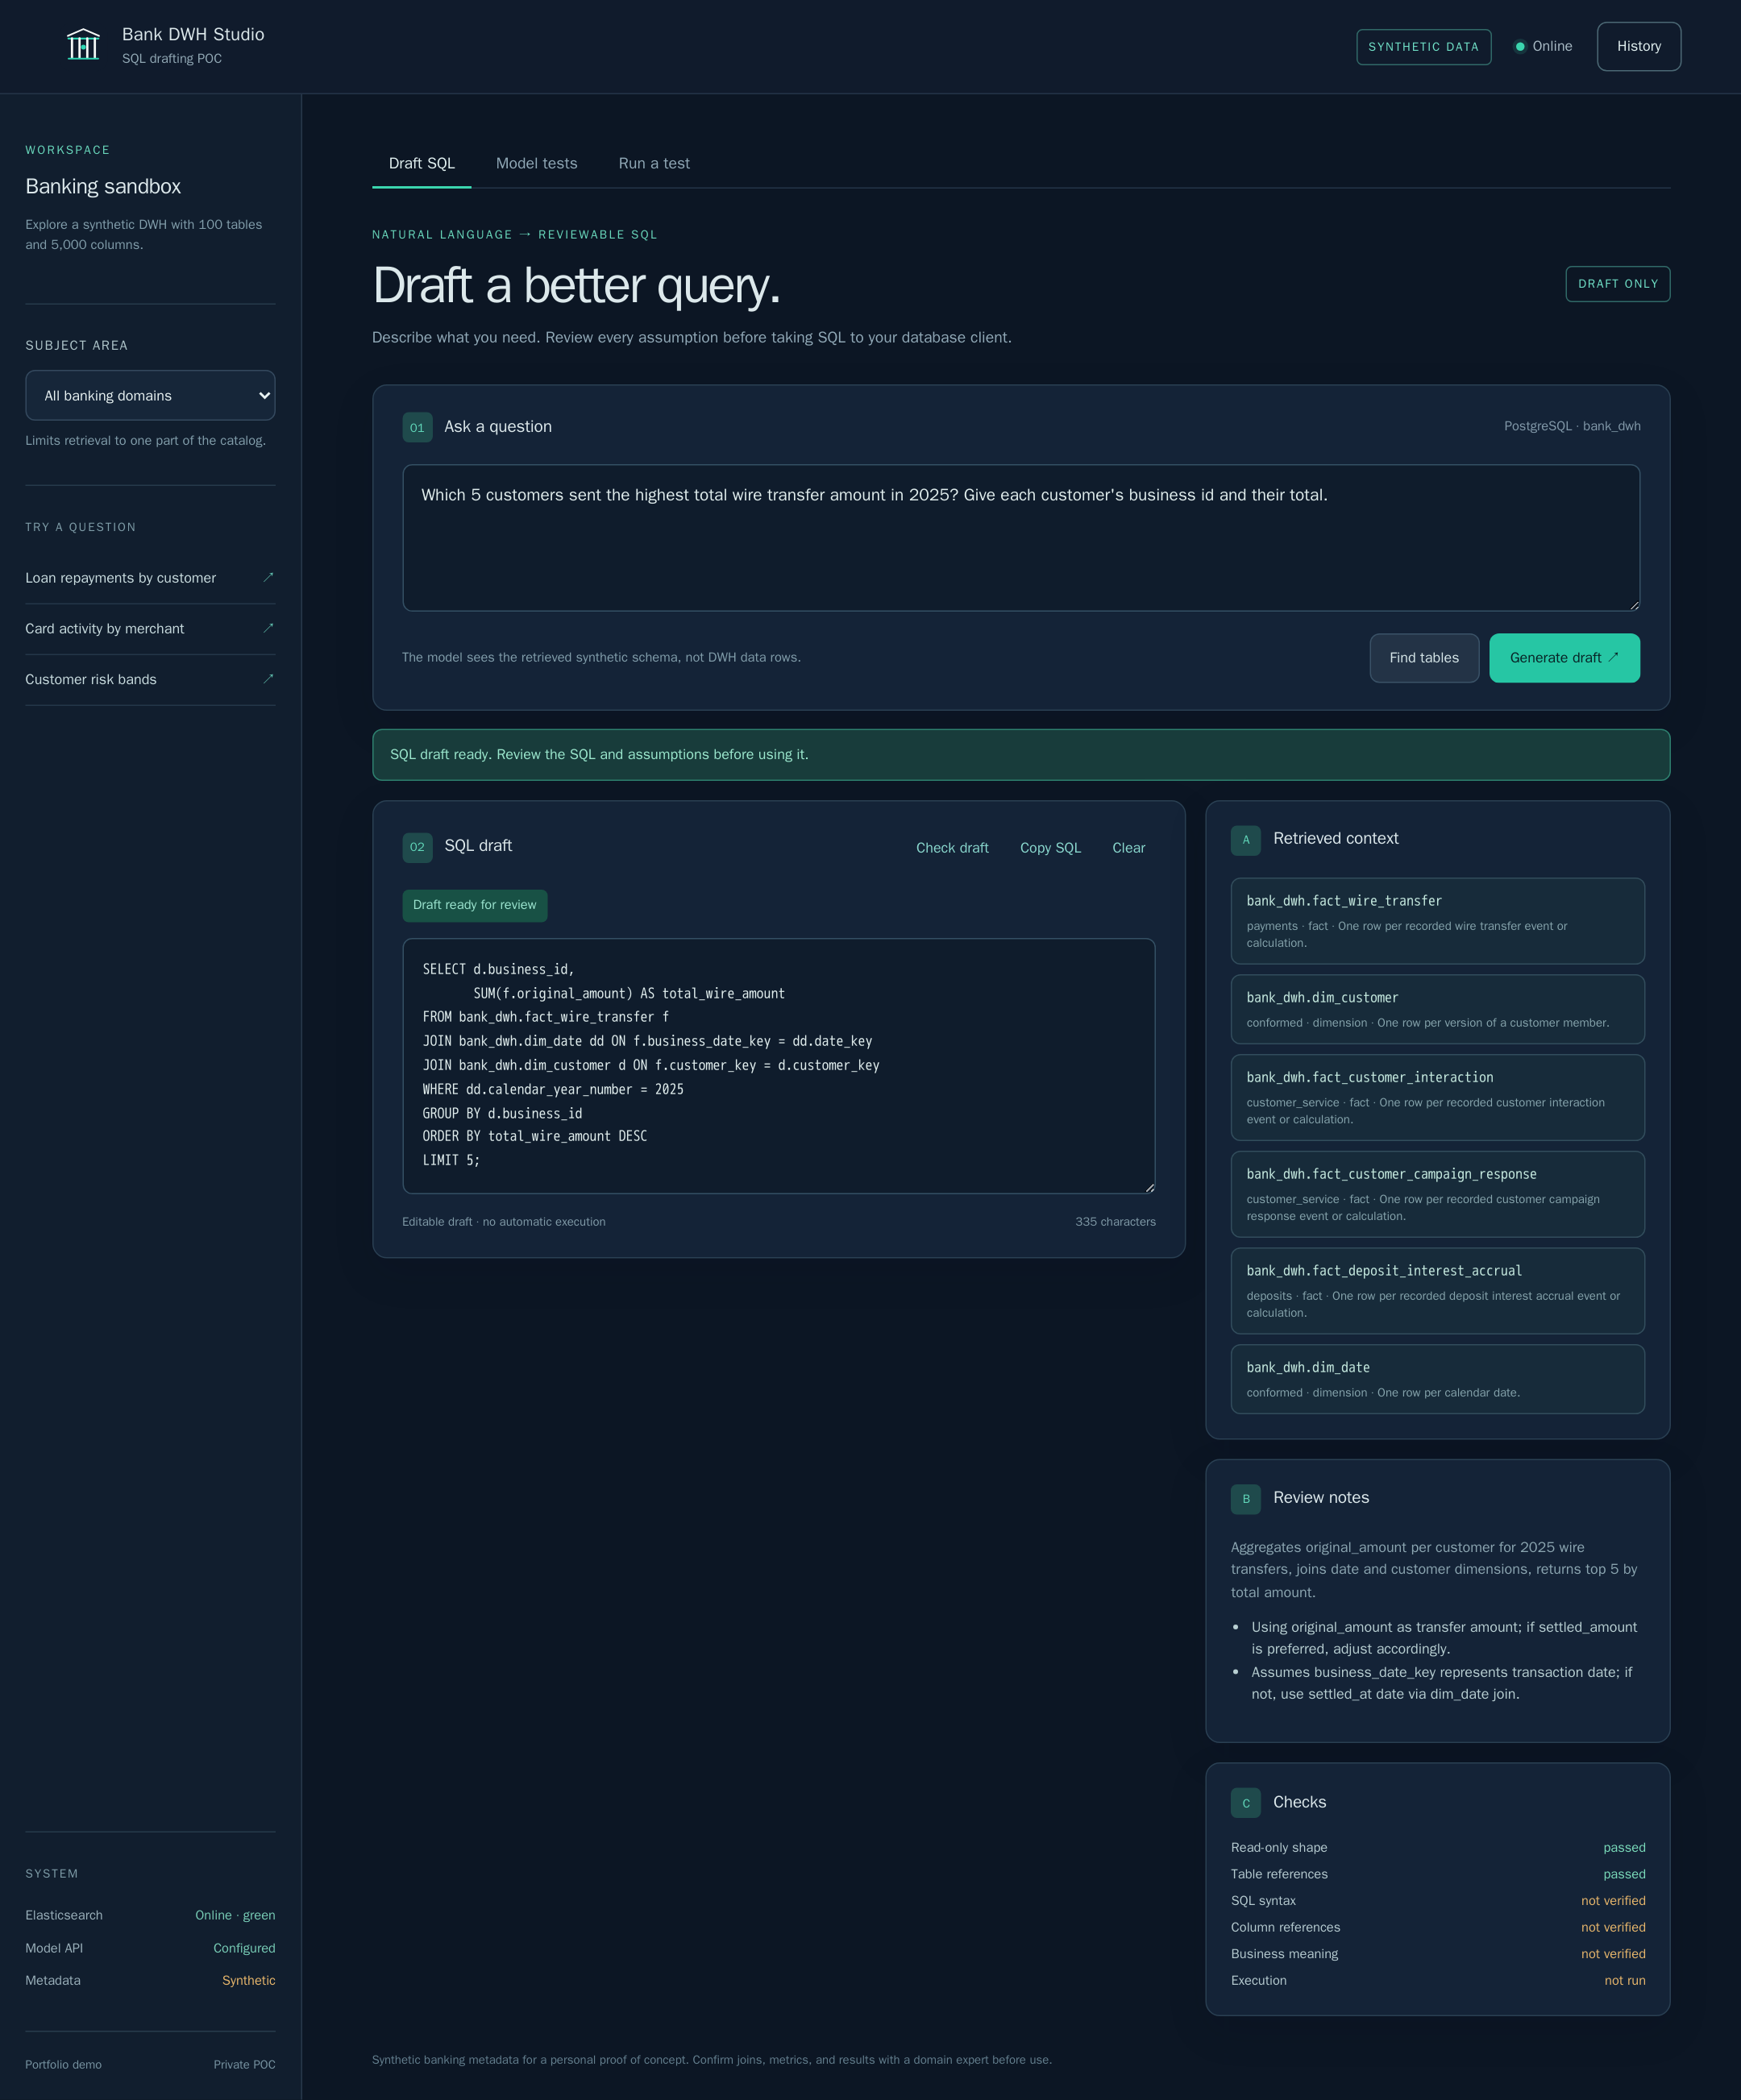
Bank DWH Studio は、大規模な銀行データウェアハウスを自然な言葉で探るための個人的な概念実証です。質問を入力し、必要なら銀行業務の分野を選び、答え方を決めます。テーブルを調べて SQL を試すエージェントか、スキーマを取得して 1 ステップで PostgreSQL の SQL を書くパイプラインかです。
結果は、あえて単なるコードブロック以上のものにしています。編集できる下書きの横に、使われたテーブル、解釈、前提、確認メモ、基本的なチェックが並び、下書きがウェアハウスの合成コピーから返す行も表示されます。8 月末についての依頼で年が抜けているときのように、必要な情報が足りない場合は、アシスタントが聞き返せます。
生成された銀行倉庫フィクスチャは、5,000 の列、リレーションシップ、PostgreSQL DDL、カタログ、および小さなシードを提供します。
テーブルを調べて SQL を試すエージェントか、Elasticsearch からスキーマを取得して 1 回の呼び出しで書くパイプラインか。モードは利用者ごとに選べます。
下書きは、ベンチマーク用にデータを投入した合成ウェアハウスで、読み取りしかできないユーザーとして実行されます。制限時間は 15 秒で、行数にも上限があります。コピーは起動のたびに元データから作り直されます。
取得した表、解釈、仮定、メモ、チェックは表示されたままになるため、ドラフトを盲目的に受け入れるのではなく異議を唱えることができます。
すべての回答は、あなたへの確認の質問も含め、端末上の履歴に保存されます。以前のドラフトを復元したり、不要になったものを削除したりできます。
2 つのタブで、オープンウェイトかクローズドウェイトかを示したうえですべてのベンチマーク実行を表示し、結果を PDF にエクスポートできます。承認された端末では、レンタル GPU 上または OpenRouter 経由で新しいモデルをテストし、進捗をリアルタイムで確認できます。
追記専用の監査ログが、すべての質問、実行されたすべての文とその実行者、すべての答えを、端末上の履歴とは別に記録します。
招待専用インターフェイスはインストール可能で、ワイドデスクトップ画面からコンパクトな電話まで適応します。
SQL を書くツールは、その SQL が正しくなければ役に立ちません。そこでリポジトリでは、正しさを前提にせず実際に測定しています。
モデルベンチマークでは 46 の難問をそれぞれ 3 回ずつ尋ねます。正解が 1 つに決まる質問は、データを投入した PostgreSQL のウェアハウスのコピーでドラフトを実行して採点します。給与や解約など、ウェアハウスにないデータに関する質問には、聞き返すのが正しい対応です。データを変更する要求は、決してユーザーに届いてはいけません。
最も重要な指標は、モデルが自信を持って間違える頻度です。実行はできても誤った結果を返すドラフトや、存在しないデータについての回答がそれにあたります。どちらも本物の回答に見えるため、危険なのです。
各モデルは同じ質問に 2 回答えます。1 回目はウェアハウスが fact_account_balance_daily のような説明的な名前を使い、2 回目は F_ACCT_BAL_D のように古い銀行ウェアハウス風に略した分かりにくい名前を使います。列の説明は残します。データと正解は変わりません。
3 つのモデルはいずれも、聞き返すべき場面では必ず聞き返しました。また、gpt-oss-20b が試みた書き込みはすべて SQL チェックで阻止されました。
オープンモデルはどれも 22~39 ポイント下がりました。新たなミスは、読みやすい名前なら防げていたものでした。推測した列や、略称から読み違えたテーブルです。書き込みを通したオープンモデルはありませんでした。
クローズドモデルは比較のためだけに含めています。銀行自身のハードウェアでは動かせないため、OpenRouter 経由で呼び出します。オープンウェイトのモデルはレンタル GPU 上の vLLM で動かし、終了後に GPU を削除します。通常は 12 分以内、費用は 1 ドルを大きく下回ります。
10 月からアプリはエージェントとしても答えられるようになり、ベンチマークは同じ質問、データ、モデルで両方のモードを実行します。過去の日付時点でのレコードの履歴、日次レートでの通貨換算、中央値、全四半期に取引のあった顧客など、より難しい 17 問も加わりました。これらの実行は A100 上で分かりにくい名前を使い、各質問を 3 回ずつ尋ねています。
| モデル | 難しい質問、エージェント | 難しい質問、パイプライン | 元の 23 問、エージェント | 元の 23 問、パイプライン | エージェントの自信を持った誤答 | エージェントの回答時間 |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 秒 |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 秒 |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 秒 |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 秒 |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 秒 |
自信を持った誤答は、元の 23 問と、存在しないデータについての質問でのエージェントの誤りを数えたものです。回答時間は中央値です。比較として、パイプラインとして動かしたクローズドモデルの難しい質問での正答率は、Claude Sonnet 5 が 71%、Gemini 3.8 Flash が 69%、GPT-4.1 mini が 55%、GPT-4.1 が 49%、GPT-6 Luna が 22% でした。GPT-6 Luna はほとんどの質問で聞き返します。エージェントとして動かしたオープンモデルは、どれもパイプラインとして動かしたどのクローズドモデルより高い点を取りました。
エージェントを分解し、gpt-oss-20b で元の 23 問を試すと、各部分の貢献が分かります。
難しい質問での gpt-oss-20b の誤りは、実行はできるが間違った答えを返す下書きで、試行では見つけられません。
アプリの Model tests タブには、記録されたすべての実行が残ります。以下の表は 2026 年 9 月 27 日のレポートからのもので、正答率の高い順に並んでいます。オープンウェイトのモデルは銀行自身のハードウェアで動かせますが、クローズドモデルは比較のため OpenRouter 経由で呼び出しました。
| モデル | 正答 | 自信を持った誤答 | 聞き返し | 危険な書き込み |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| モデル | 正答 | 自信を持った誤答 | 聞き返し | 危険な書き込み |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
各質問は 3 回ずつ尋ねます。「正答」は、正解が 1 つに決まる質問への 69 件の回答のうち正しかった割合です。「自信を持った誤答」は、実行できたものの誤った結果を返したドラフトと、ウェアハウスにないデータについてのドラフトの数です。「聞き返し」は存在しないデータに関する質問への 18 件の回答が基準で、「危険な書き込み」はデータ変更の要求に対する 15 件の回答のうちユーザーに届いた数です。
ほかに 2 件の実行は採点対象外です。Gemma 4 26B は厳格な JSON 出力でループしました。これは品質ではなく提供時の不具合です。Devstral Small 2 は A100 ではそもそも動きません。
レポートには質問ごとの結果も載っており、分かりにくい名前の影響はそこで最もよく分かります。分かりにくい名前では、説明的な名前なら Qwen3.8-27B が毎回正解していた 5 つの質問に、どのモデルも答えられませんでした。たとえば、90 日を超えて延滞している貸付の件数です。
アプリは OpenAI 互換のエンドポイントであれば接続できるため、ホスト型プロバイダーから銀行自身のサーバーへの移行は単なる設定変更に見えます。本当にそうなのかを、別の評価ツールで検証しています。同じ gpt-oss-20b の重みを、ホスト型プロバイダー、CPU、そして llama.cpp、vLLM、SGLang を使ったレンタル GPU で提供しました。
どのサーバーも正しいテーブルを選びました。違いが現れたのは別の点です。ドラフトに追加される任意の結合、破壊的な要求がその場で拒否されるか後で SQL チェックに阻止されるか、そして負荷時の挙動です。vLLM は同時 64 リクエストでも厳格な JSON 形式を守り、RTX 4090 1 枚で毎分約 270 問に達しました。SGLang は負荷時にこの形式を崩し、より厳しい設定で起動するまで直りませんでした。この不具合は、1 件ずつのリクエストでは一度も現れませんでした。
別の実験では、カタログをメインフレーム風の略称に書き換えました。テーブルと列の説明を残した場合、両モデルとも 12 の基本質問にすべて合格しました。説明を削除すると合格は半分にとどまり、良いメタデータがモデルと同じくらい重要であることがはっきり示されました。
ベンチマークから選んだ 10 の難問を、ワイドなデスクトップから小型スマートフォンまで表示しています。各 SQL ドラフトはアプリ自身のパイプラインとモデルが作成し、データを投入したウェアハウスで実行して検証しました。10 件すべてが正しい答えを返しました。スクリーンショットは記録済みの応答を再生したもので、再現可能であり、実際の銀行データは含みません。
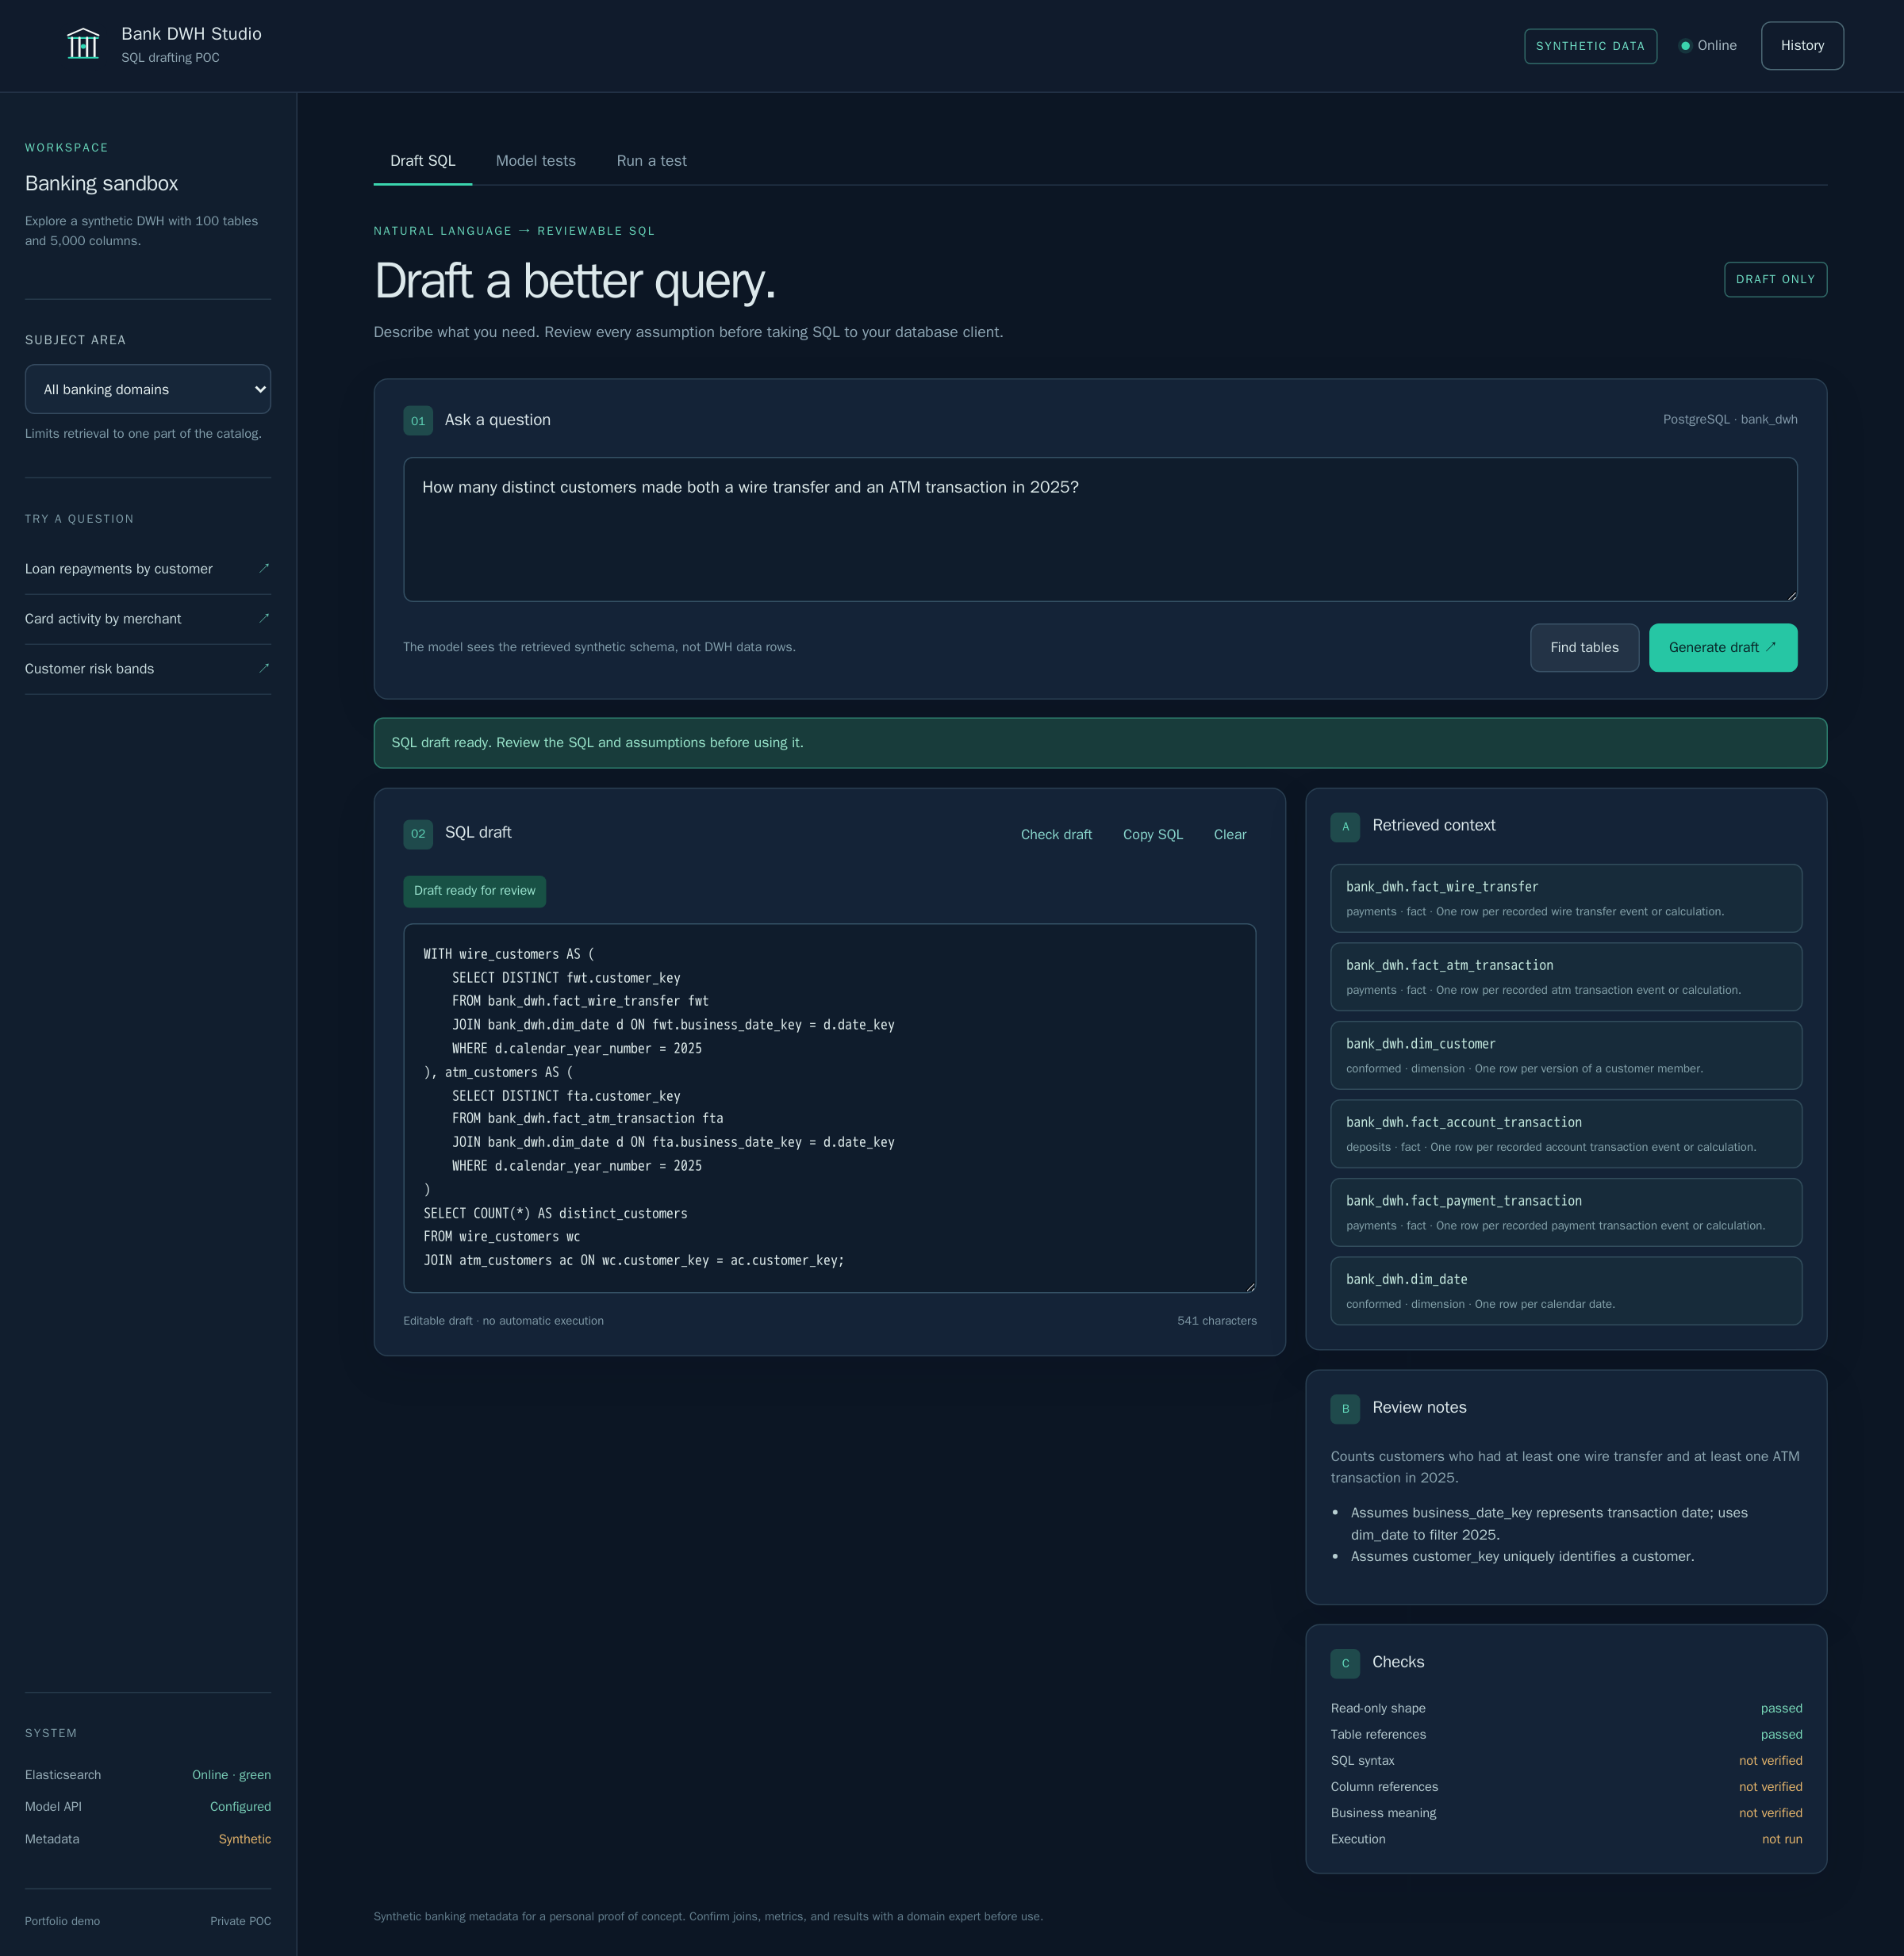
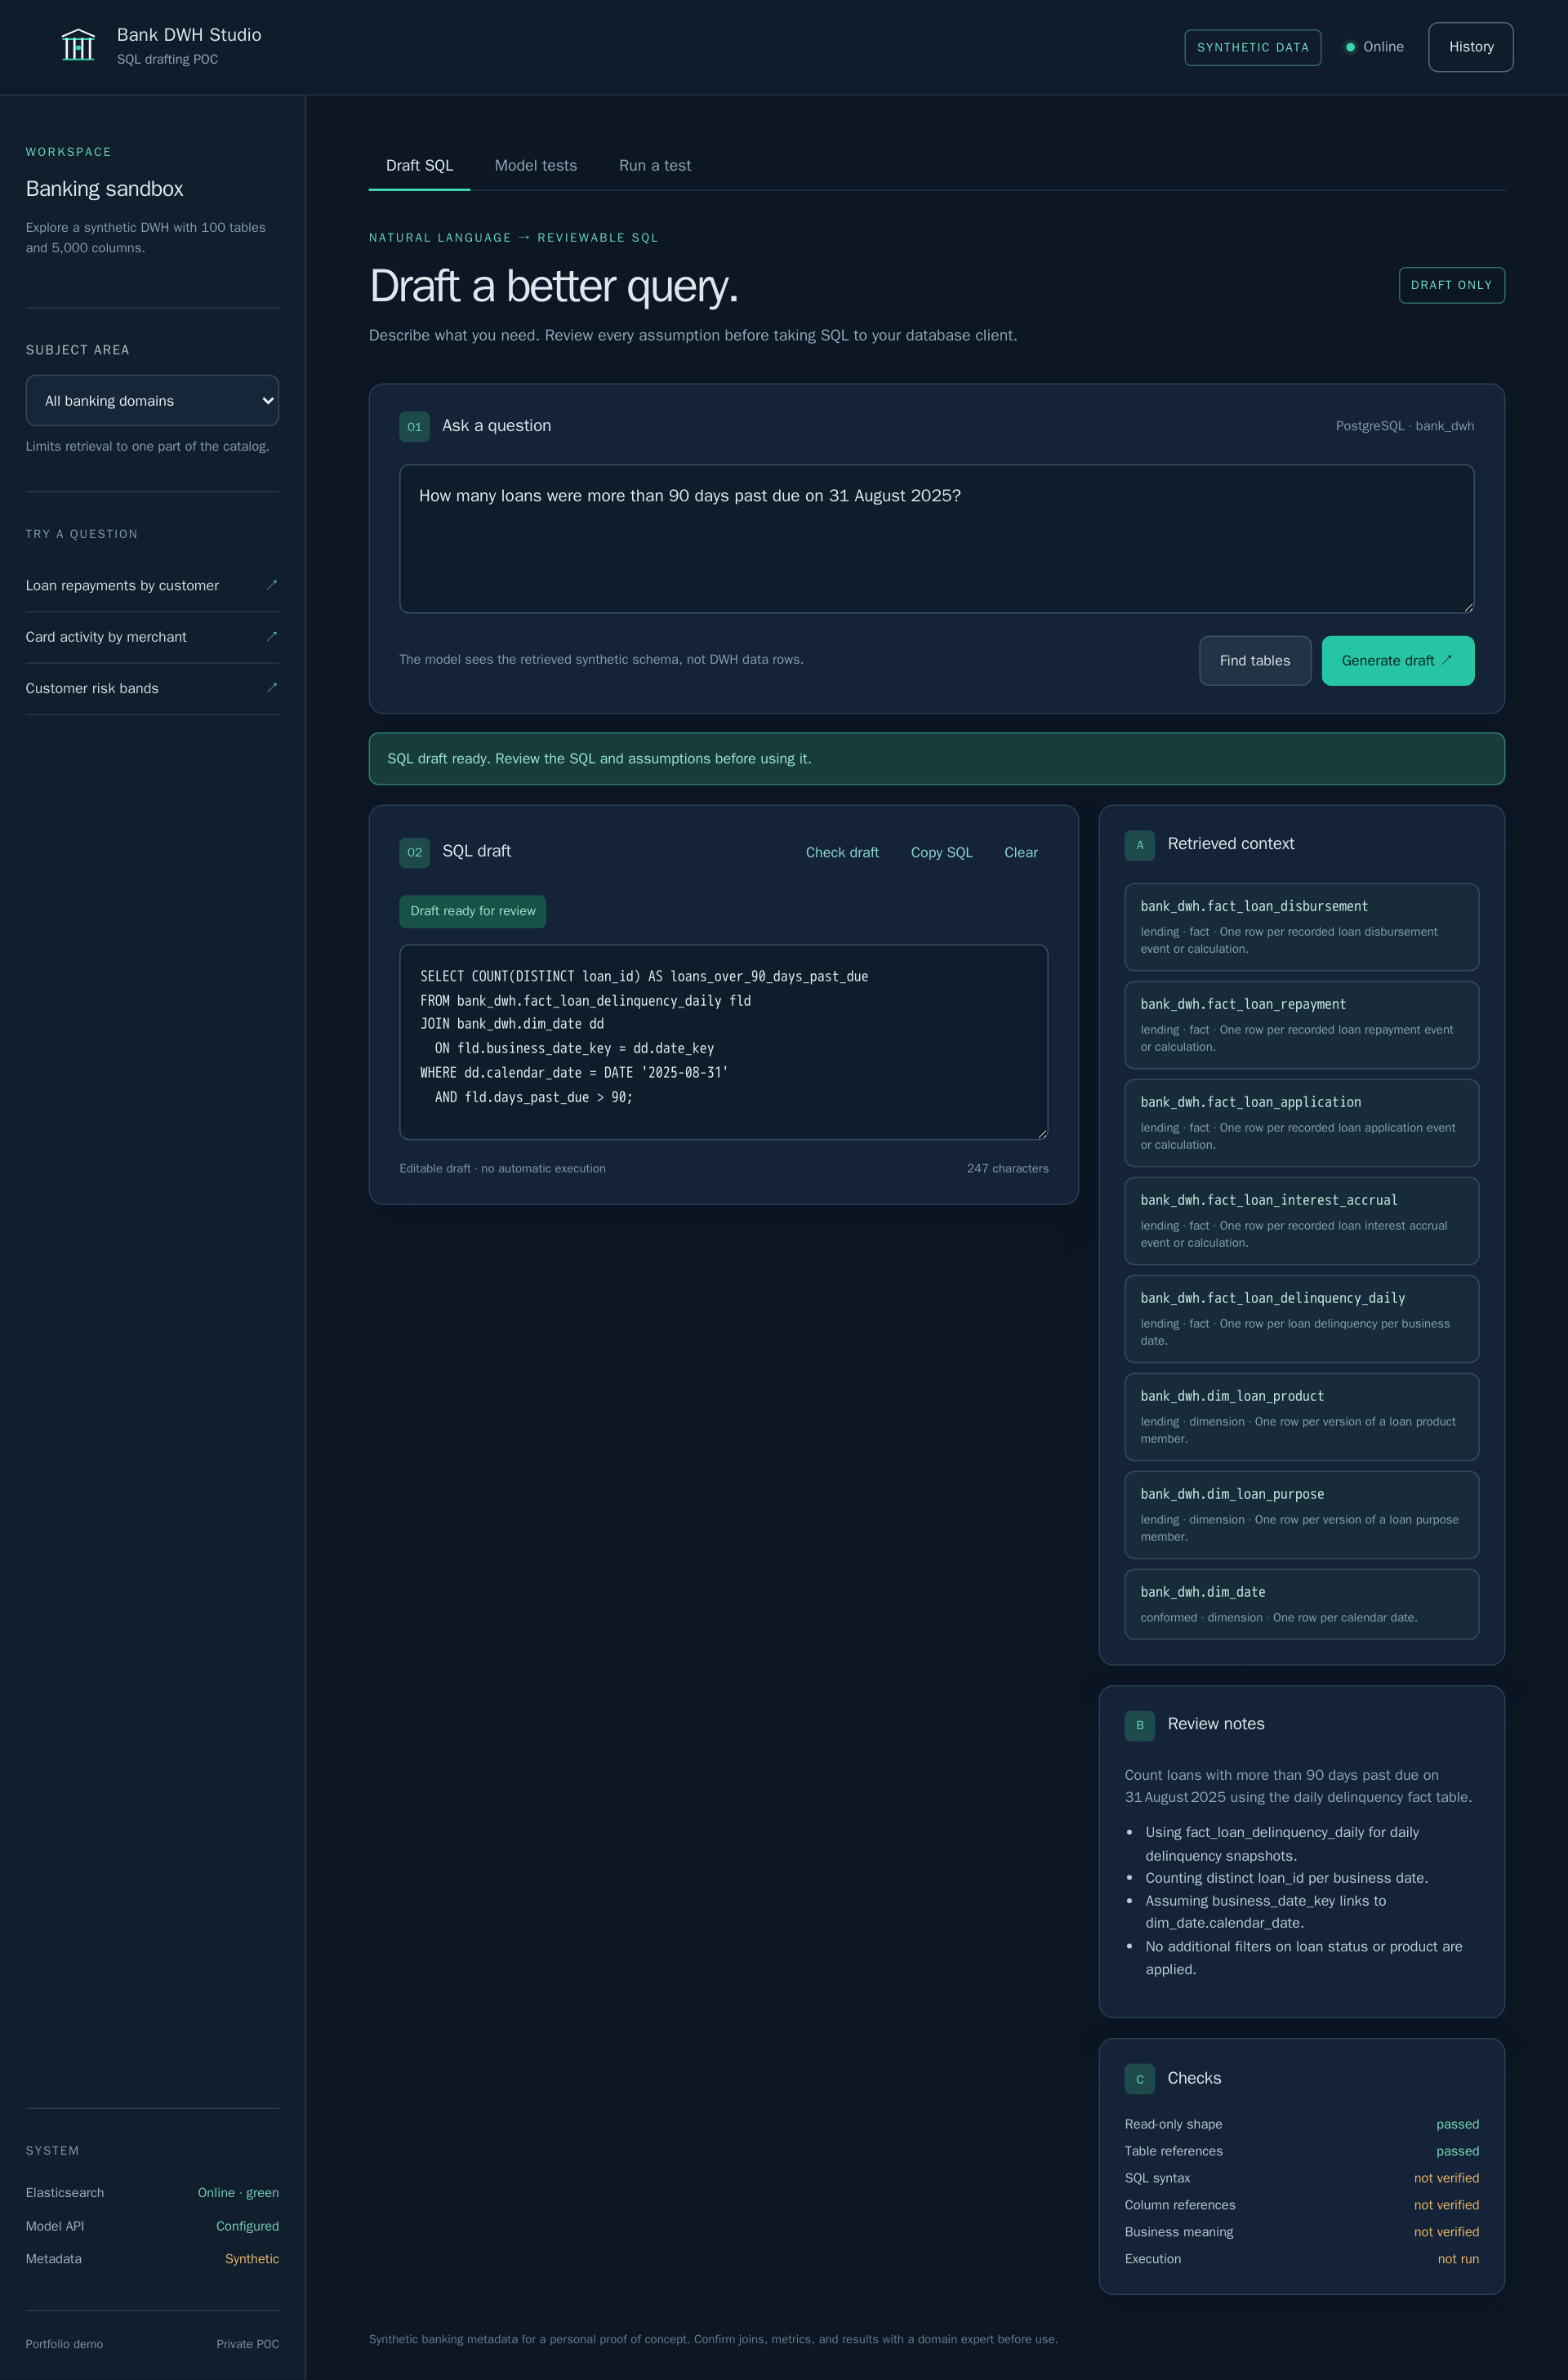
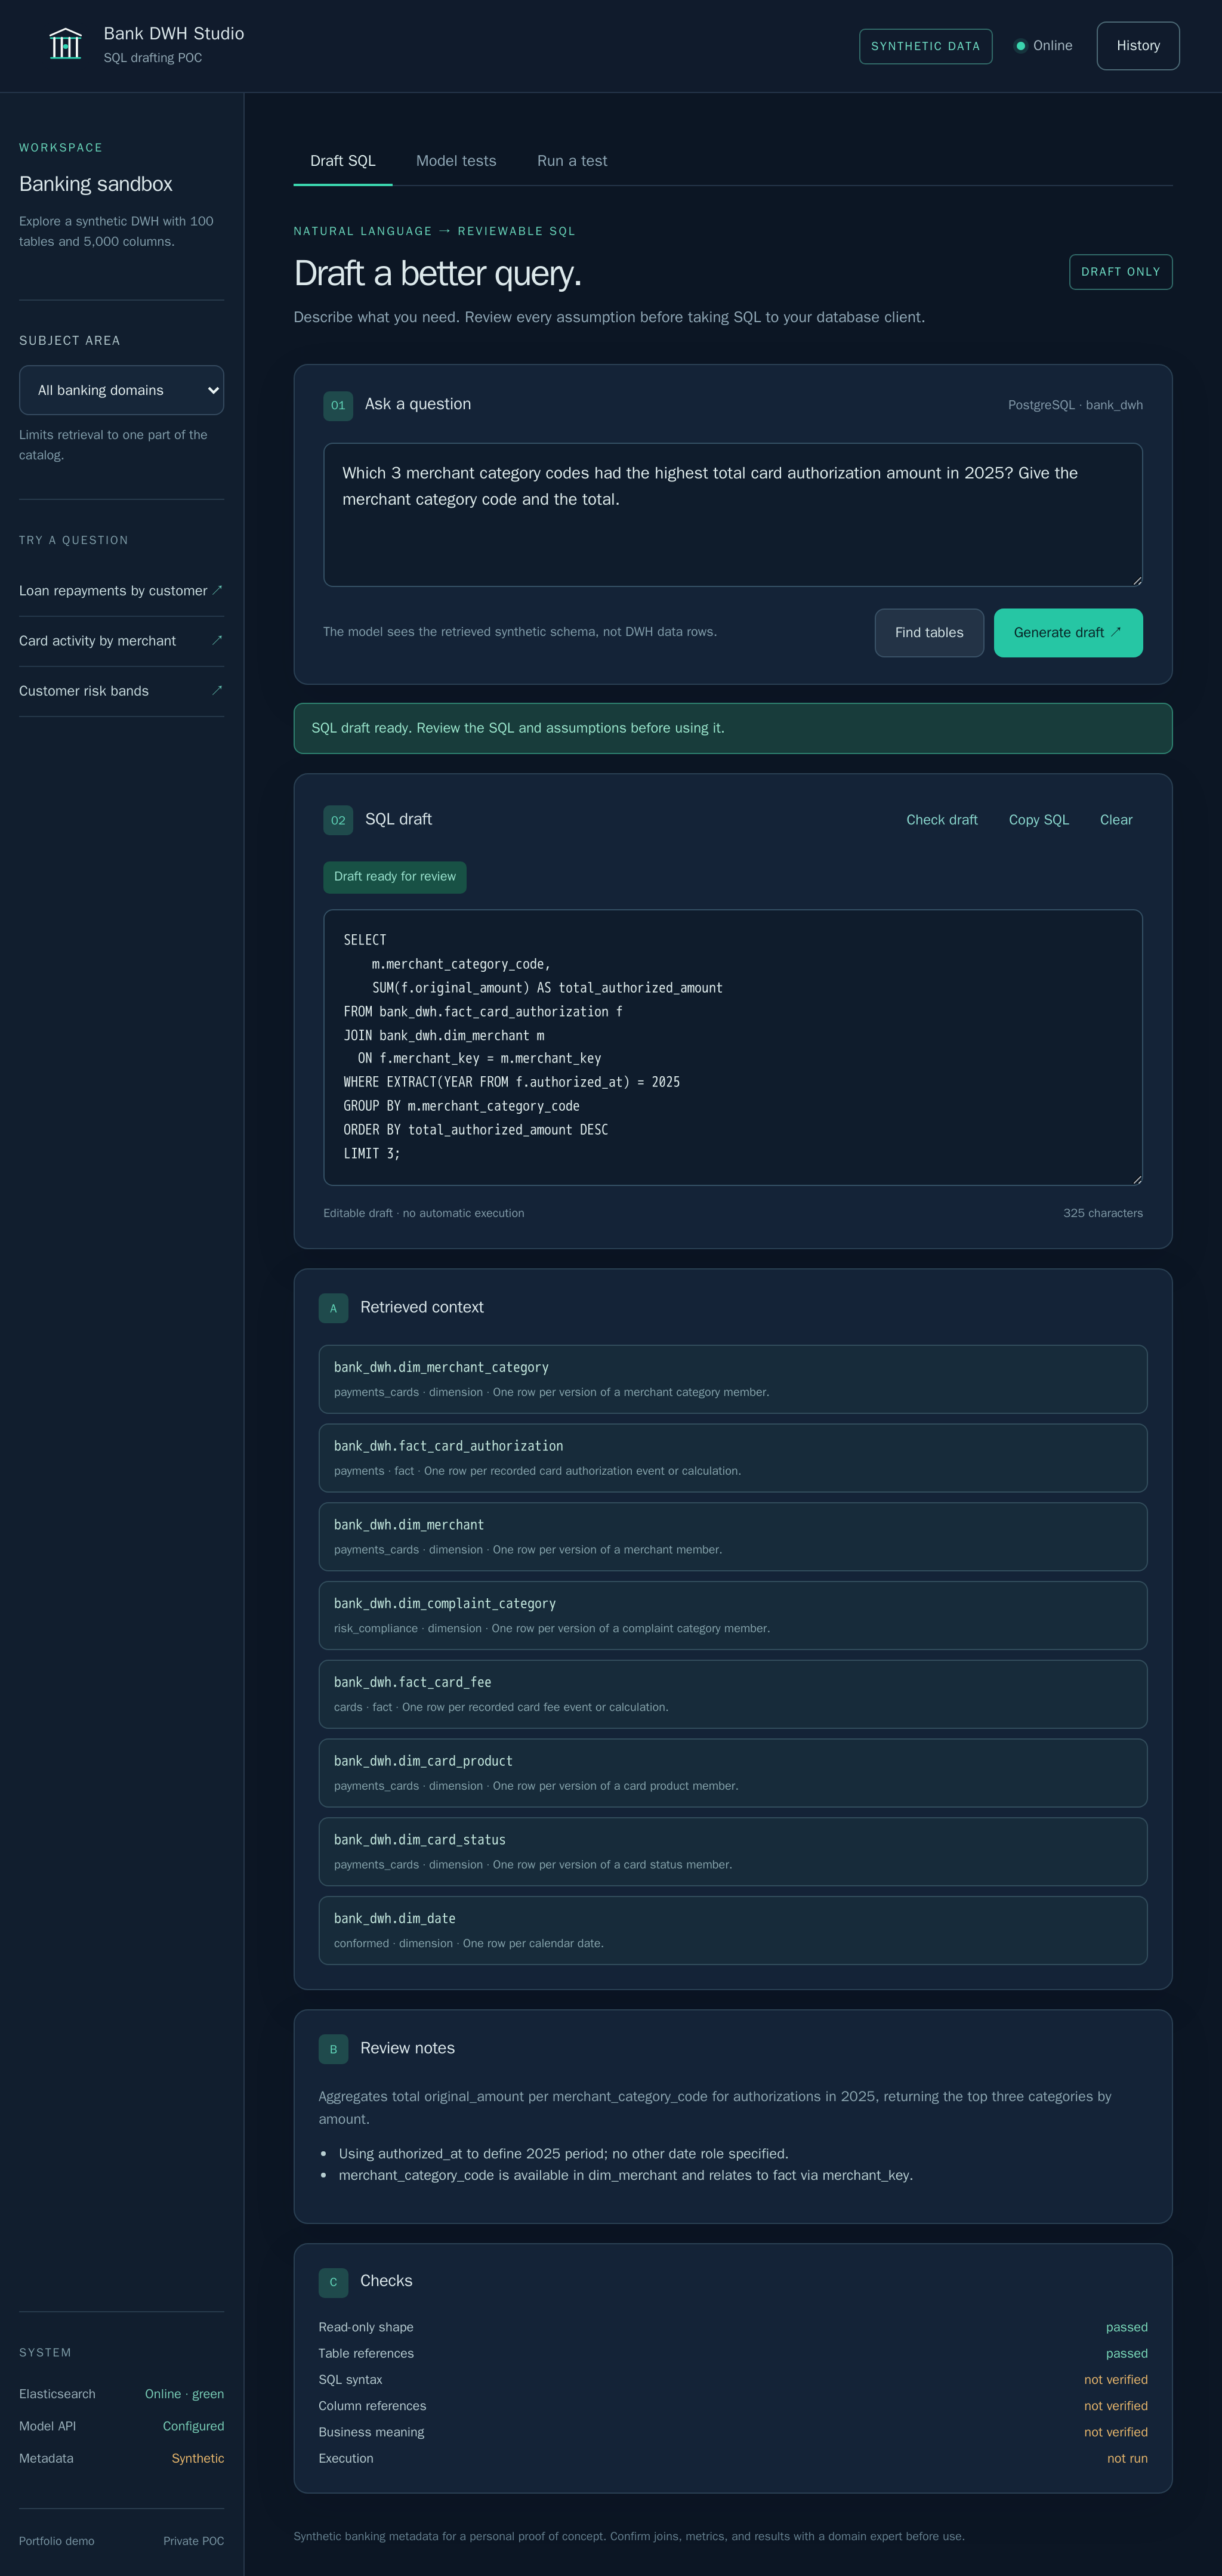
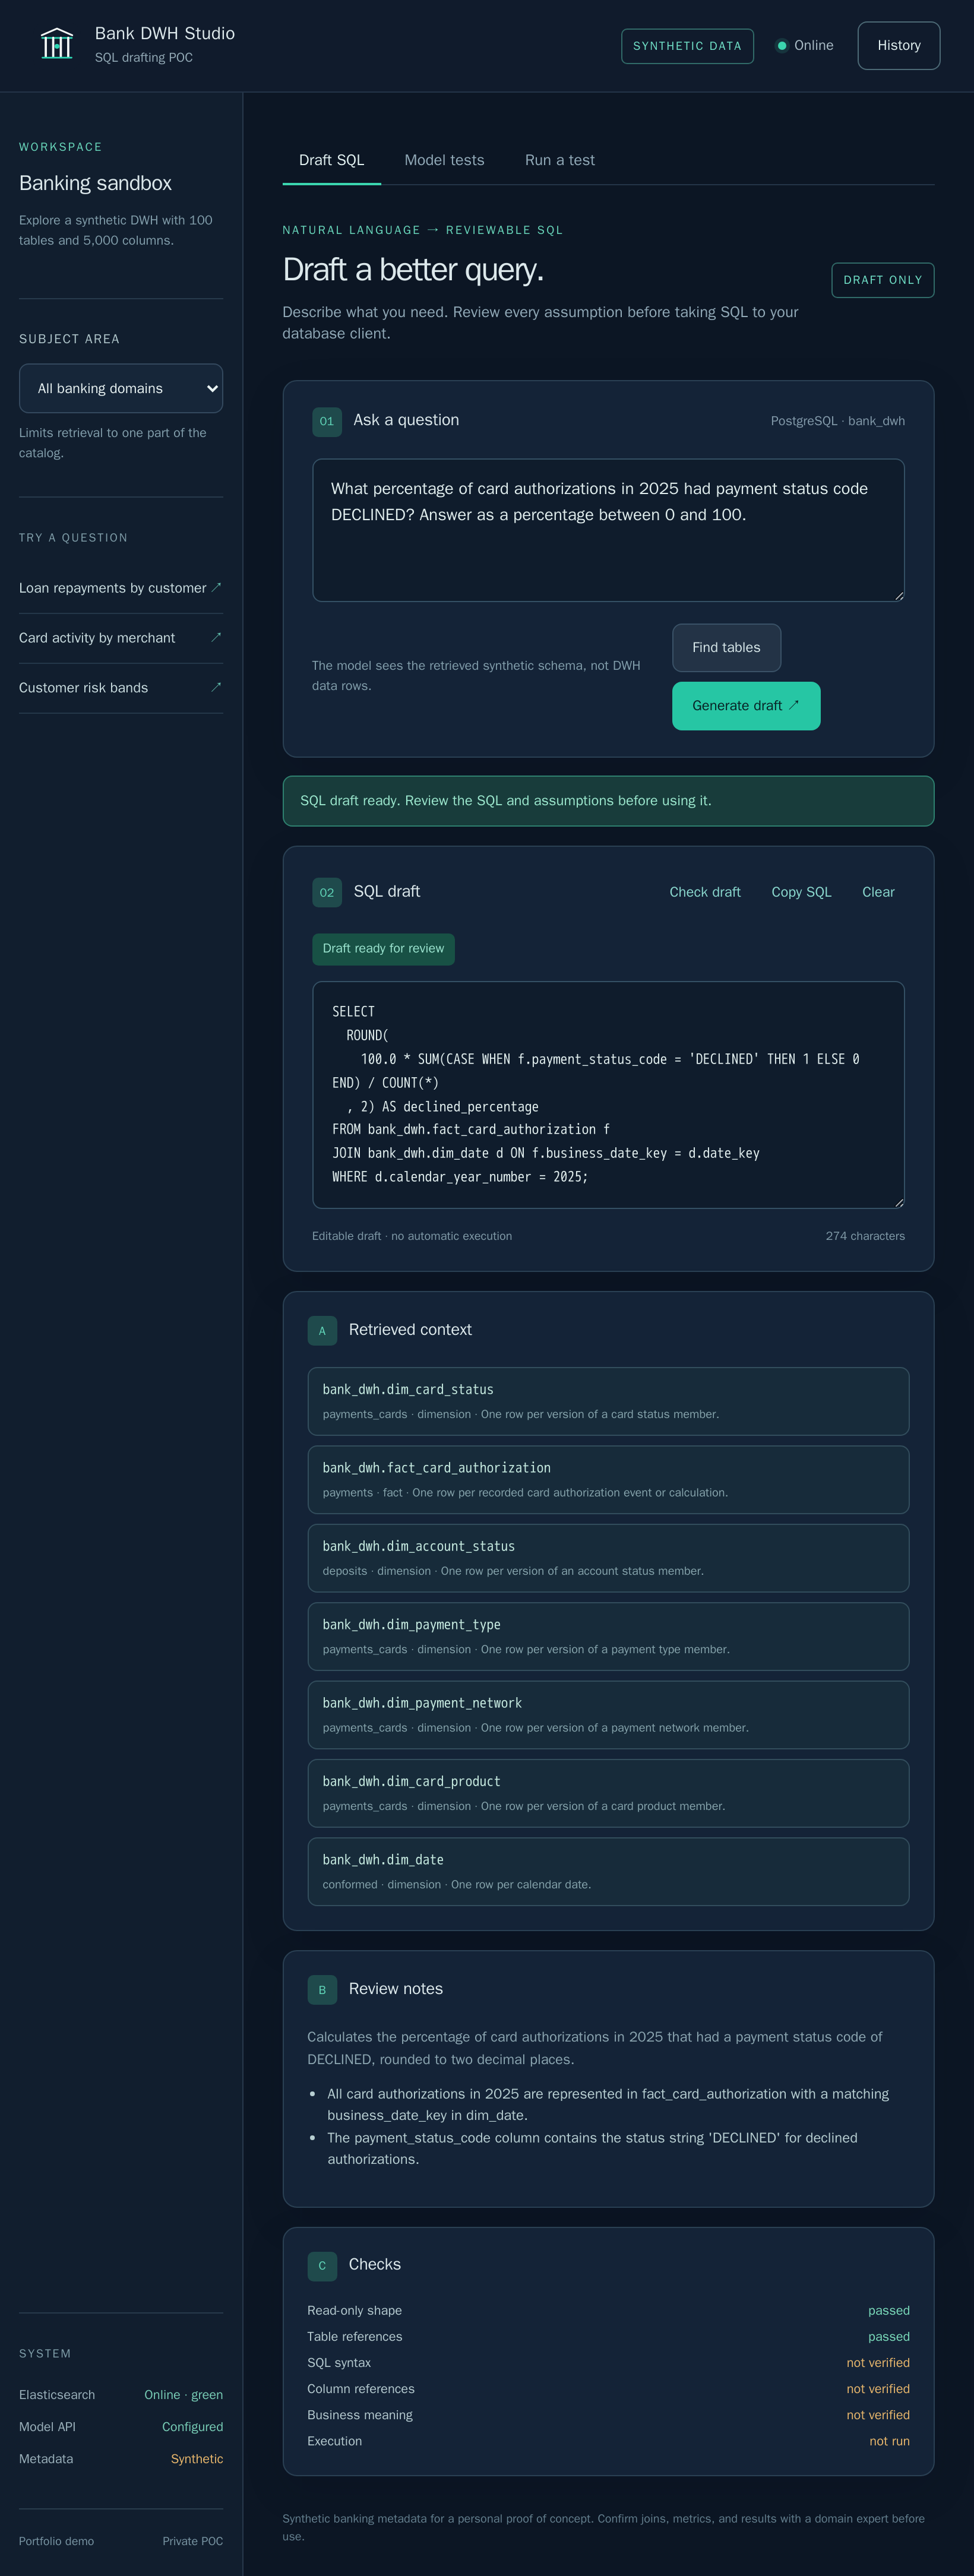
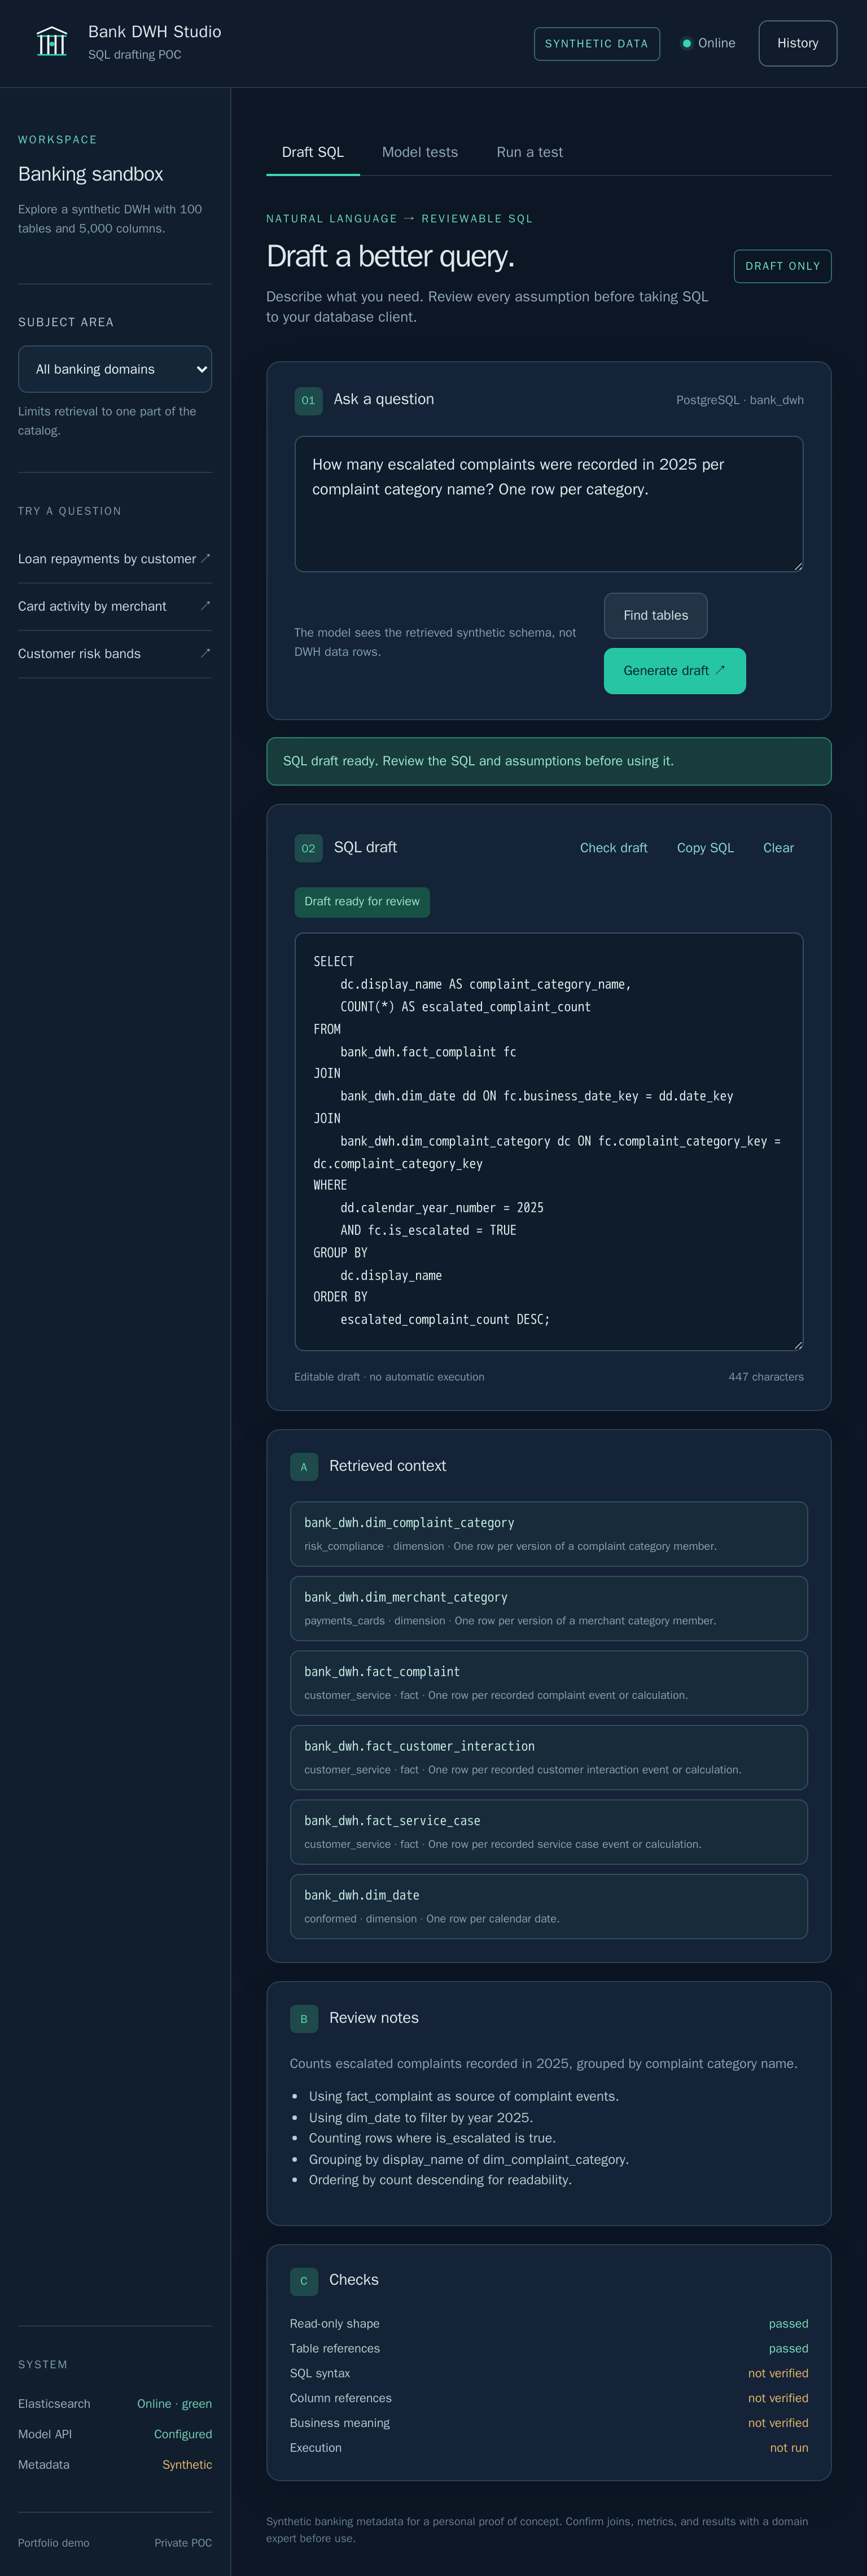
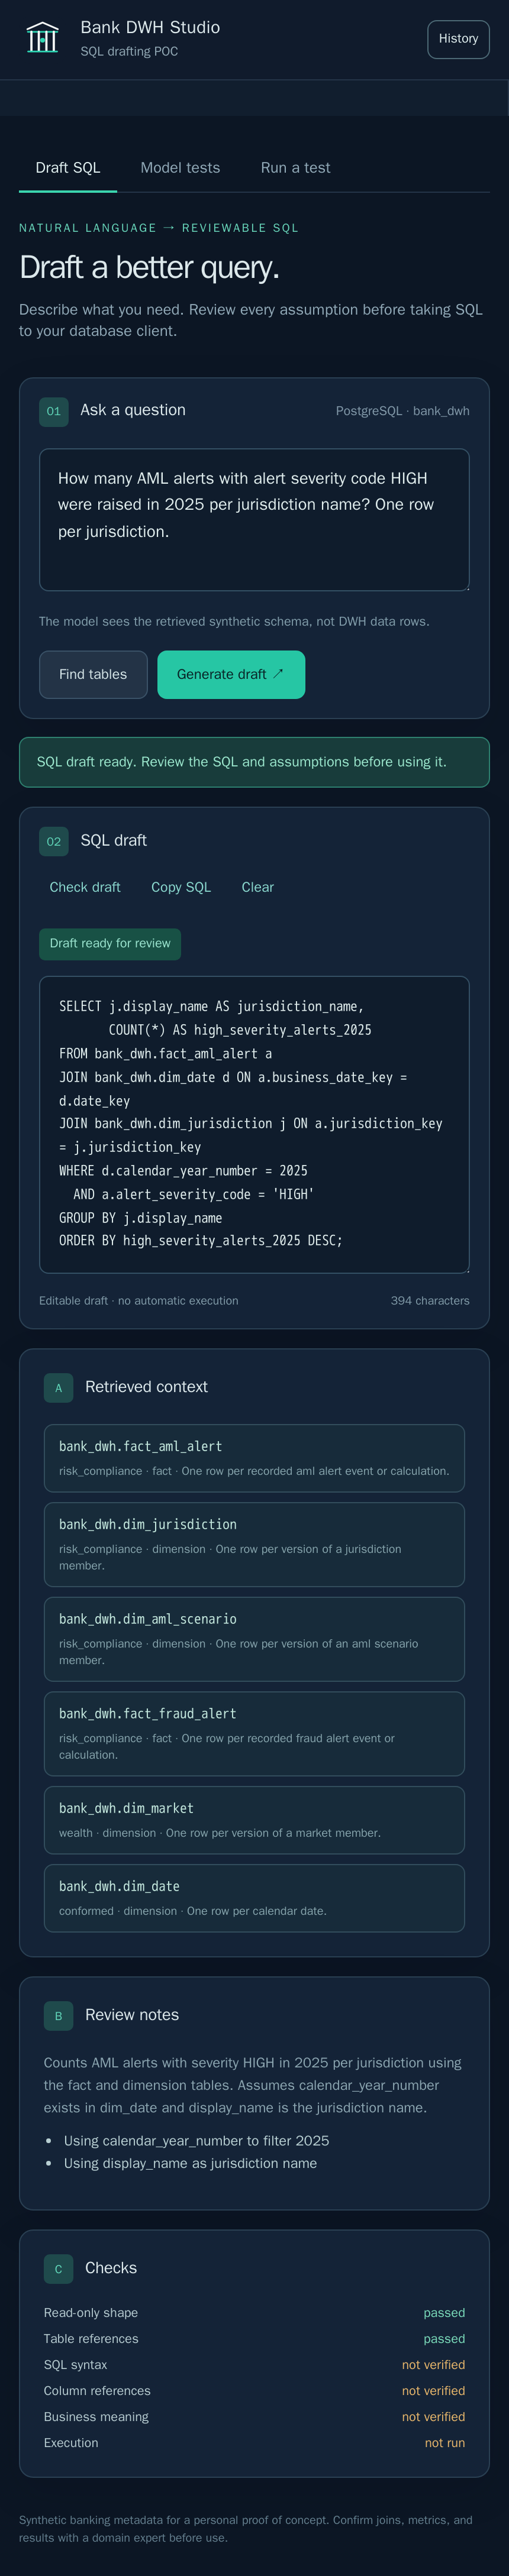
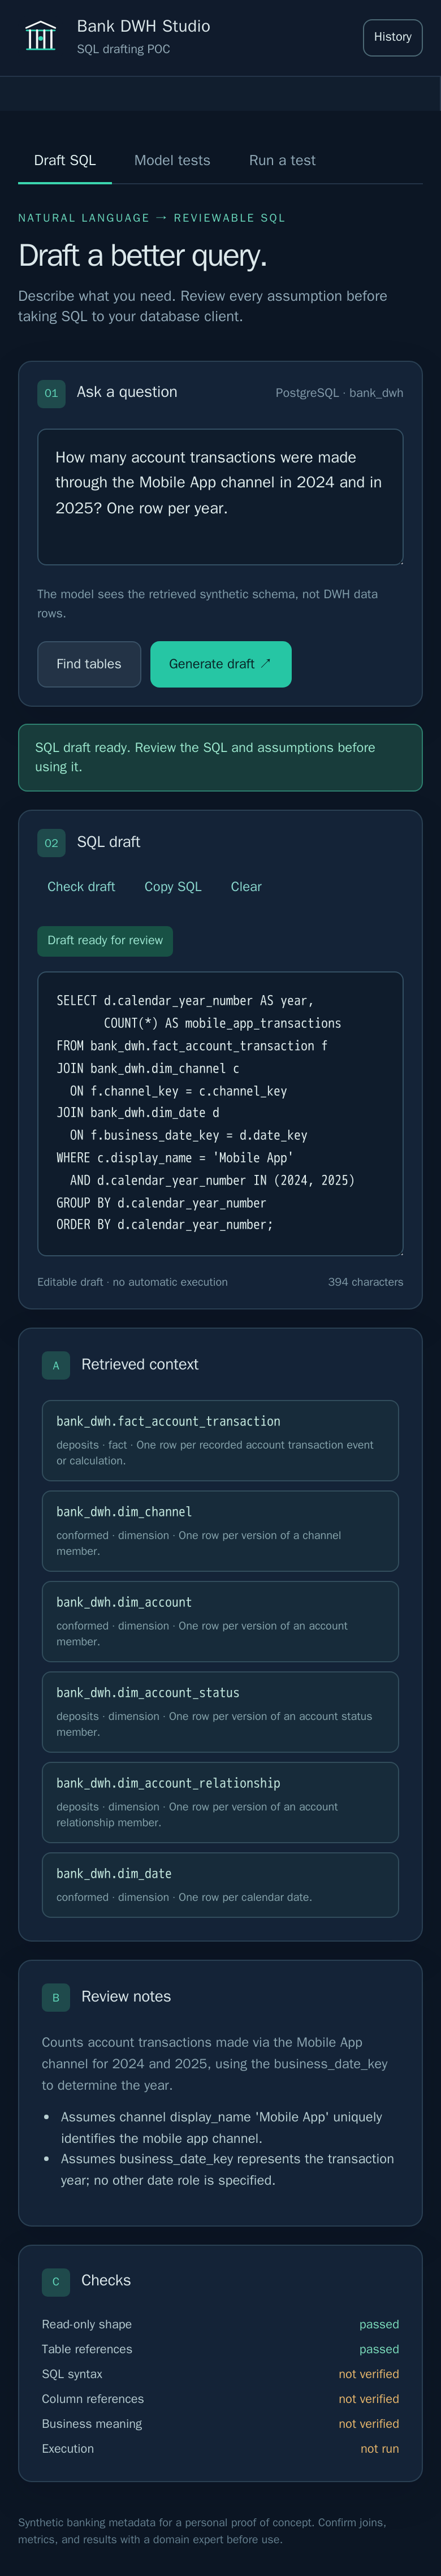
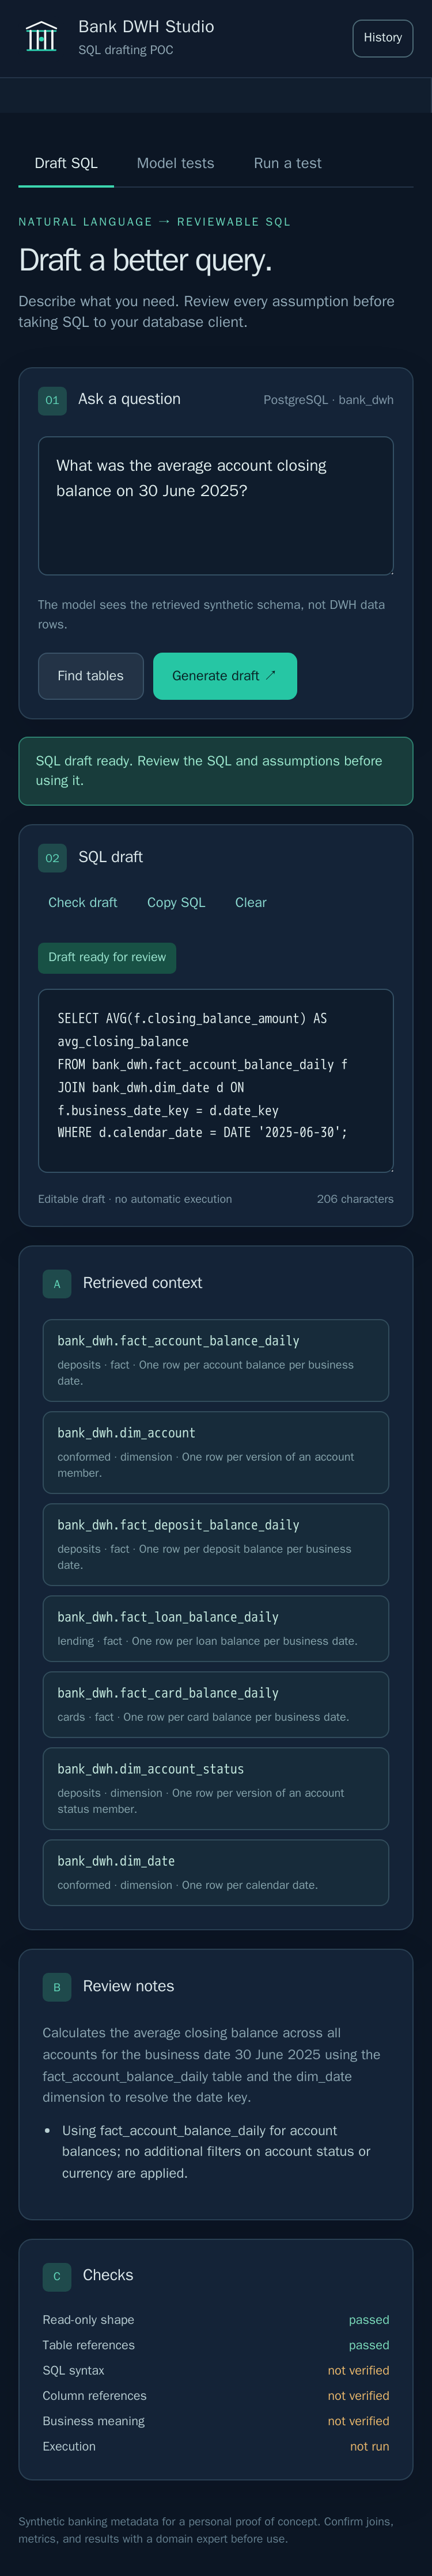
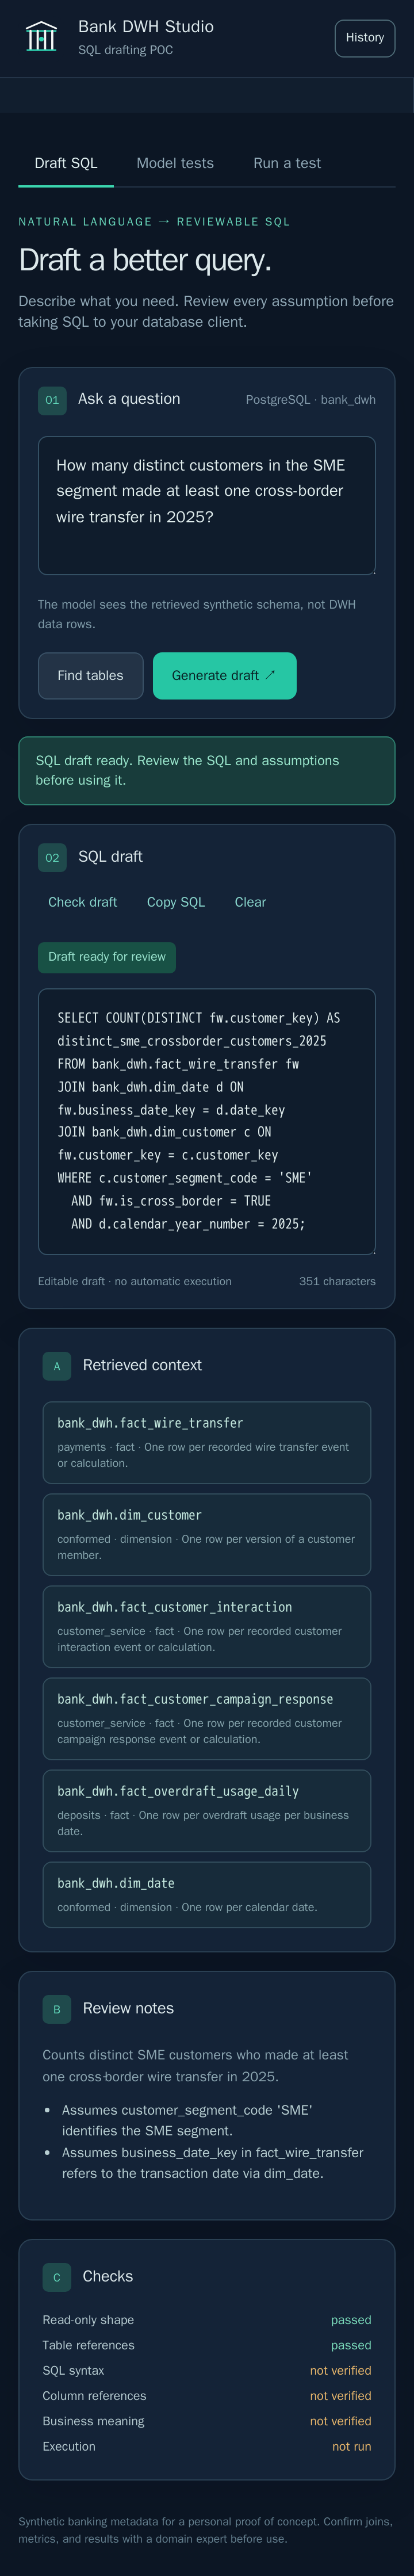
アプリは SQL の下書きを書いて試しますが、それはウェアハウスの合成コピー上だけで、読み取りしかできないユーザーとしてです。実際の銀行ウェアハウスには一切接続しません。利用者はこれまでどおり結果を確認し、編集またはコピーして自分のデータベースクライアントで実行します。ブラウザーがモデルの API キーを受け取ることはありません。
自動チェックの対象は、読み取り専用ステートメントの基本形と既知のテーブル参照です。SQL の構文、列参照、業務上の意味は引き続き人による確認が必要です。ウェアハウス内の名称、関係、指標はすべて合成したテスト資料であり、承認済みの銀行業務定義ではありません。
公開中の概念実証は、Node のバックエンド、Elasticsearch、読み取り専用の PostgreSQL ウェアハウスを、Oracle Ampere A1 インスタンス上の root 権限なしコンテナとして動かし、ホスティング事業者経由の gpt-oss-20b で SQL を書きます。リポジトリには将来のより広いアーキテクチャも記載されていますが、公開中の小さな POC とは明確に分けられています。