무대 뒤 도구
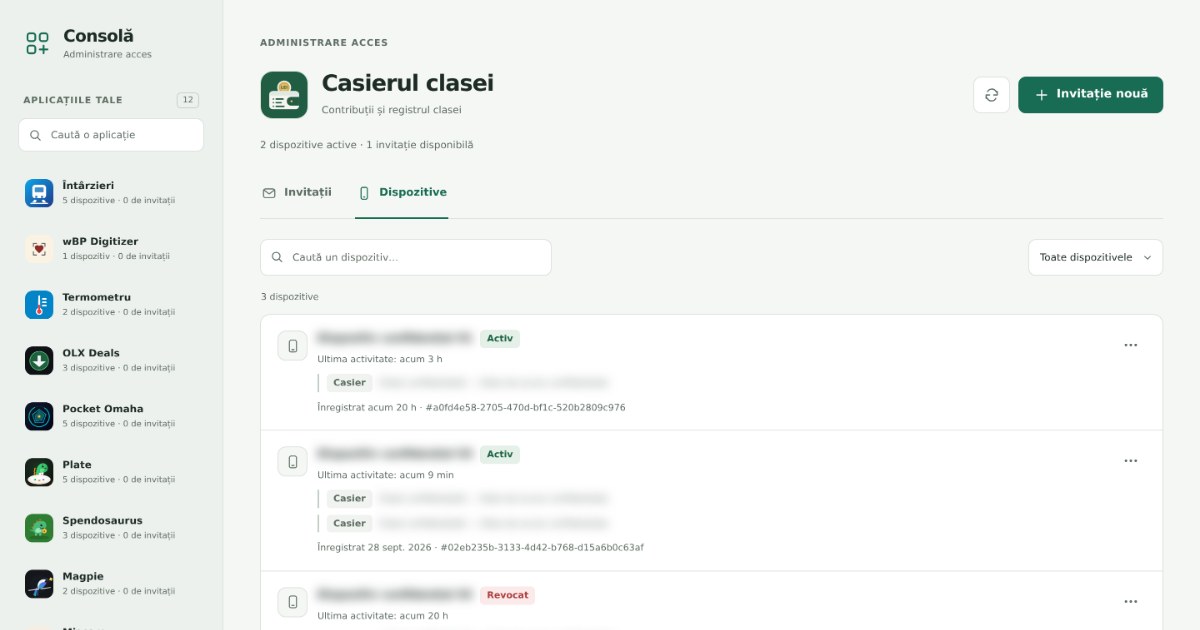
PWA Invite Console
비공개 웹 앱의 초대와 기기를 한곳에서 관리하는 작은 콘솔.
은행 데이터에 대해 질문하고 관련 스키마를 살펴본 뒤 편집 가능한 SQL 초안을 받아 보세요.
라이브 PWA는 초대 전용입니다.
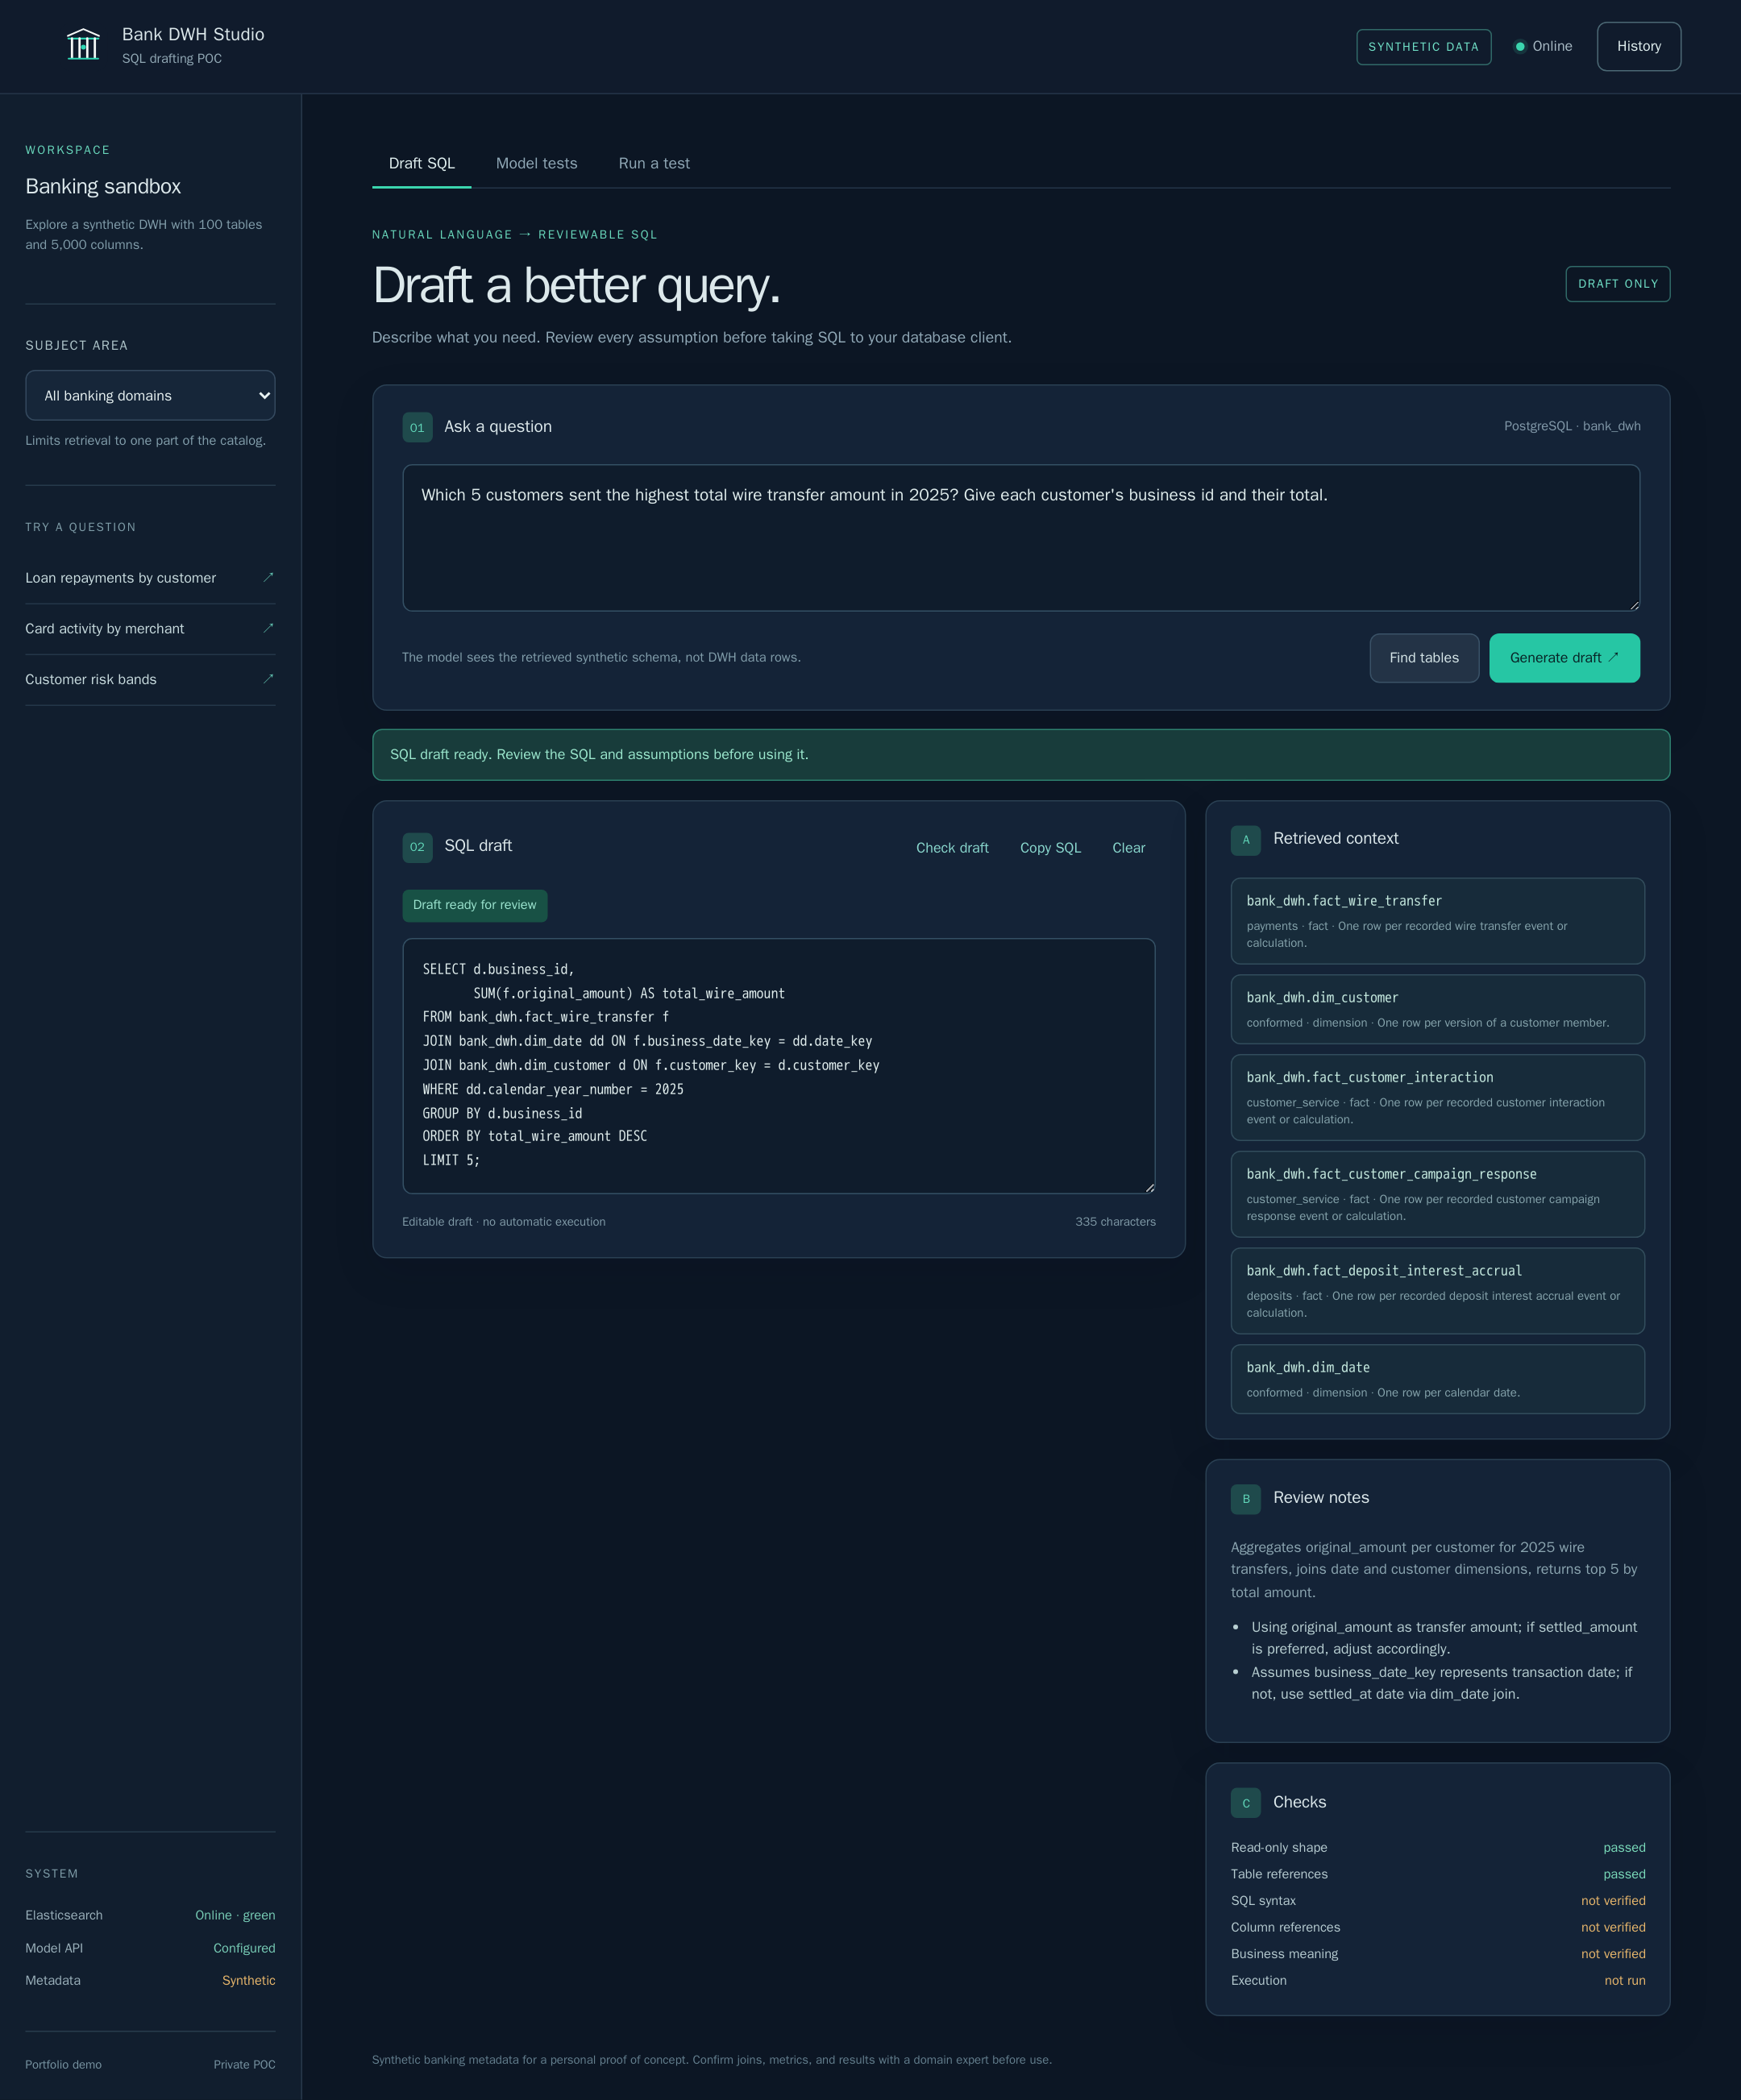
Bank DWH Studio는 대규모 은행 데이터 웨어하우스를 일상 언어로 탐색하기 위한 개인 개념 증명입니다. 질문을 하고, 원하면 은행 업무 분야를 고른 뒤, 답하는 방식을 정합니다. 테이블을 찾아보고 SQL을 시험하는 에이전트, 또는 스키마를 가져와 한 번에 PostgreSQL SQL을 쓰는 파이프라인입니다.
결과는 일부러 단순한 코드 블록 이상으로 만들었습니다. 편집 가능한 초안 옆에 사용한 테이블, 해석, 가정, 검토 메모, 기본 점검이 표시되고, 초안이 웨어하우스의 합성 사본에서 돌려준 행도 함께 보입니다. 8월 말에 관한 요청에서 연도가 빠진 경우처럼 꼭 필요한 정보가 없으면 어시스턴트가 되물을 수 있습니다.
생성된 은행 창고 고정 장치는 5,000개의 열, 관계, PostgreSQL DDL, 카탈로그 및 작은 시드를 제공합니다.
테이블을 찾아보고 SQL을 시험하는 에이전트, 또는 Elasticsearch에서 스키마를 가져와 한 번의 호출로 쓰는 파이프라인. 사용자마다 모드를 고릅니다.
초안은 벤치마크용 데이터를 채운 합성 웨어하우스에서, 읽기만 할 수 있는 사용자로 실행되며, 제한 시간은 15초이고 행 수에도 상한이 있습니다. 사본은 시작할 때마다 원본 데이터로 다시 만들어집니다.
검색된 표, 해석, 가정, 메모 및 점검 사항은 눈에 잘 띄므로 초안을 맹목적으로 받아들이는 대신 이의를 제기할 수 있습니다.
사용자에게 되묻는 질문을 포함해 모든 답변이 기기의 기록에 저장됩니다. 이전 초안을 복원하거나 더 이상 필요 없는 항목을 삭제할 수 있습니다.
두 개의 탭에서 모든 벤치마크 실행을 공개 가중치인지 비공개 가중치인지 표시해 보여 주고, 결과를 PDF로 내보내며, 승인된 기기는 대여한 GPU나 OpenRouter를 통해 새 모델을 테스트하고 진행 상황을 실시간으로 볼 수 있습니다.
추가만 가능한 감사 로그가 모든 질문, 실행된 모든 문과 실행한 주체, 모든 답을 기기의 기록과는 별도로 보관합니다.
초대 전용 인터페이스는 설치가 가능하며 넓은 데스크톱 화면에서 소형 휴대폰까지 적용됩니다.
SQL을 작성하는 도구는 그 SQL이 정확할 때만 쓸모가 있습니다. 그래서 저장소는 이를 당연하게 여기지 않고 직접 측정합니다.
모델 벤치마크는 46개의 어려운 질문을 각각 세 번씩 묻습니다. 정답이 하나인 질문은 데이터를 채운 PostgreSQL 웨어하우스 사본에서 초안을 실행해 채점합니다. 급여나 고객 이탈처럼 웨어하우스에 없는 데이터에 관한 질문에는 되묻는 것이 정답입니다. 데이터를 변경하려는 요청은 절대 사용자에게 전달되어서는 안 됩니다.
가장 중요한 수치는 모델이 자신 있게 틀리는 빈도입니다. 실행은 되지만 틀린 결과를 내는 초안, 또는 존재하지 않는 데이터에 대한 답변이 여기에 해당합니다. 둘 다 진짜 답처럼 보이기 때문에 위험합니다.
모든 모델은 같은 질문에 두 번 답합니다. 처음에는 웨어하우스가 fact_account_balance_daily 같은 설명적인 이름을 쓰고, 다음에는 오래된 은행 웨어하우스처럼 줄여 쓴 F_ACCT_BAL_D 같은 암호 같은 이름을 씁니다. 열 설명은 그대로 둡니다. 데이터와 정답은 바뀌지 않습니다.
세 모델 모두 되물어야 할 때마다 되물었고, gpt-oss-20b가 시도한 모든 쓰기는 SQL 검사가 막아냈습니다.
모든 공개 모델이 22~39점 떨어졌습니다. 새로 생긴 실수는 읽기 쉬운 이름이 막아 주던 바로 그것이었습니다. 추측한 열, 또는 약어를 잘못 읽은 테이블이었습니다. 쓰기를 통과시킨 공개 모델은 없었습니다.
비공개 모델은 비교용으로만 포함했습니다. 은행 자체 하드웨어에서는 실행할 수 없어서 OpenRouter를 통해 호출합니다. 공개 가중치 모델은 대여한 GPU에서 vLLM으로 실행하고 끝나면 GPU를 삭제합니다. 보통 12분 이내에 끝나며 비용은 1달러에 한참 못 미칩니다.
10월부터 앱은 에이전트로도 답할 수 있으며, 벤치마크는 같은 질문, 데이터, 모델로 두 모드를 모두 실행합니다. 과거 날짜 기준의 레코드 이력, 일별 환율을 적용한 통화 환산, 중앙값, 모든 분기에 활동한 고객처럼 더 어려운 질문 17개도 추가했습니다. 이 실행에서는 A100에서 암호 같은 이름을 썼고, 질문마다 세 번씩 물었습니다.
| 모델 | 어려운 질문, 에이전트 | 어려운 질문, 파이프라인 | 원래 23개, 에이전트 | 원래 23개, 파이프라인 | 에이전트 자신 있게 틀림 | 에이전트 응답 시간 |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60초 |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22초 |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23초 |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19초 |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11초 |
자신 있게 틀림은 원래 23개 질문과 없는 데이터에 관한 질문에서 에이전트가 틀린 수입니다. 응답 시간은 중앙값입니다. 비교하자면 파이프라인으로 동작한 비공개 모델의 어려운 질문 점수는 Claude Sonnet 5 71%, Gemini 3.8 Flash 69%, GPT-4.1 mini 55%, GPT-4.1 49%, GPT-6 Luna 22%였습니다. GPT-6 Luna는 대부분의 질문에 되묻습니다. 에이전트로 동작한 모든 공개 모델이 파이프라인으로 동작한 모든 비공개 모델보다 높은 점수를 얻었습니다.
에이전트를 분해해 gpt-oss-20b로 원래 23개 질문을 시험하면 각 부분의 기여를 알 수 있습니다.
어려운 질문에서 gpt-oss-20b의 실수는 실행은 되지만 틀린 답을 돌려주는 초안이어서, 시험으로는 잡아낼 수 없습니다.
앱의 Model tests 탭에는 기록된 모든 실행이 남습니다. 아래 표는 2026년 9월 27일 보고서에서 가져왔으며, 정답률이 높은 순서입니다. 공개 가중치 모델은 은행 자체 하드웨어에서 실행할 수 있고, 비공개 모델은 비교를 위해 OpenRouter를 통해 호출했습니다.
| 모델 | 정답 | 자신 있게 틀림 | 되묻기 | 안전하지 않은 쓰기 |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| 모델 | 정답 | 자신 있게 틀림 | 되묻기 | 안전하지 않은 쓰기 |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
각 질문은 세 번씩 묻습니다. '정답'은 정답이 하나인 질문에 대한 69개 답변 중 맞힌 비율입니다. '자신 있게 틀림'은 실행은 되었지만 틀린 결과를 낸 초안과, 웨어하우스에 없는 데이터에 대한 초안을 셉니다. '되묻기'는 없는 데이터에 관한 질문의 18개 답변을 기준으로 하고, '안전하지 않은 쓰기'는 데이터 변경 요청에 대한 15개 답변 중 사용자에게 전달된 수입니다.
두 번의 실행은 점수에서 빠졌습니다. Gemma 4 26B는 엄격한 JSON 출력에서 반복에 빠졌는데, 이는 품질이 아니라 서빙 오류입니다. Devstral Small 2는 A100에서 아예 실행되지 않습니다.
보고서에는 질문별 결과도 있으며, 암호 같은 이름의 대가가 바로 거기서 드러납니다. 암호 같은 이름에서는 Qwen3.8-27B가 설명적인 이름으로 매번 맞힌 다섯 개 질문에 어떤 모델도 답하지 못했습니다. 예를 들어 90일 넘게 연체된 대출이 몇 건인지 같은 질문입니다.
앱은 OpenAI 호환 엔드포인트라면 어디든 연결할 수 있어서, 호스팅 제공업체에서 은행 자체 서버로 옮기는 일이 단순한 설정 변경처럼 보입니다. 별도의 평가 도구가 실제로 그런지 확인합니다. 같은 gpt-oss-20b 가중치를 호스팅 제공업체, CPU, 그리고 llama.cpp, vLLM, SGLang을 사용하는 대여 GPU에서 각각 제공했습니다.
모든 서버가 올바른 테이블을 골랐습니다. 차이는 다른 곳에서 나타났습니다. 초안에 추가되는 선택적 조인, 파괴적인 요청이 바로 거부되는지 아니면 나중에 SQL 검사에서 걸러지는지, 그리고 부하 상황에서였습니다. vLLM은 동시 요청 64개에서도 엄격한 JSON 형식을 지켰고, RTX 4090 한 장에서 분당 약 270개 질문을 처리했습니다. SGLang은 부하가 걸리면 이 형식을 깨뜨렸고, 더 엄격한 설정으로 시작한 뒤에야 해결되었습니다. 이 오류는 요청을 하나씩 보낼 때는 한 번도 나타나지 않았습니다.
또 다른 실험에서는 카탈로그를 메인프레임 스타일의 약어 이름으로 바꿨습니다. 테이블과 열 설명을 유지했을 때는 두 모델 모두 기준 질문 12개를 모두 통과했습니다. 설명을 없애자 절반만 통과했는데, 이는 좋은 메타데이터가 모델만큼 중요하다는 분명한 신호입니다.
벤치마크에서 고른 어려운 질문 10개를 넓은 데스크톱부터 작은 휴대폰까지 보여 줍니다. 각 SQL 초안은 앱 자체의 파이프라인과 모델이 작성했고, 데이터를 채운 웨어하우스에서 실행해 검증했습니다. 10개 모두 정답을 냈습니다. 스크린샷은 이렇게 기록된 응답을 재생한 것이므로 재현할 수 있으며 실제 은행 데이터는 포함하지 않습니다.
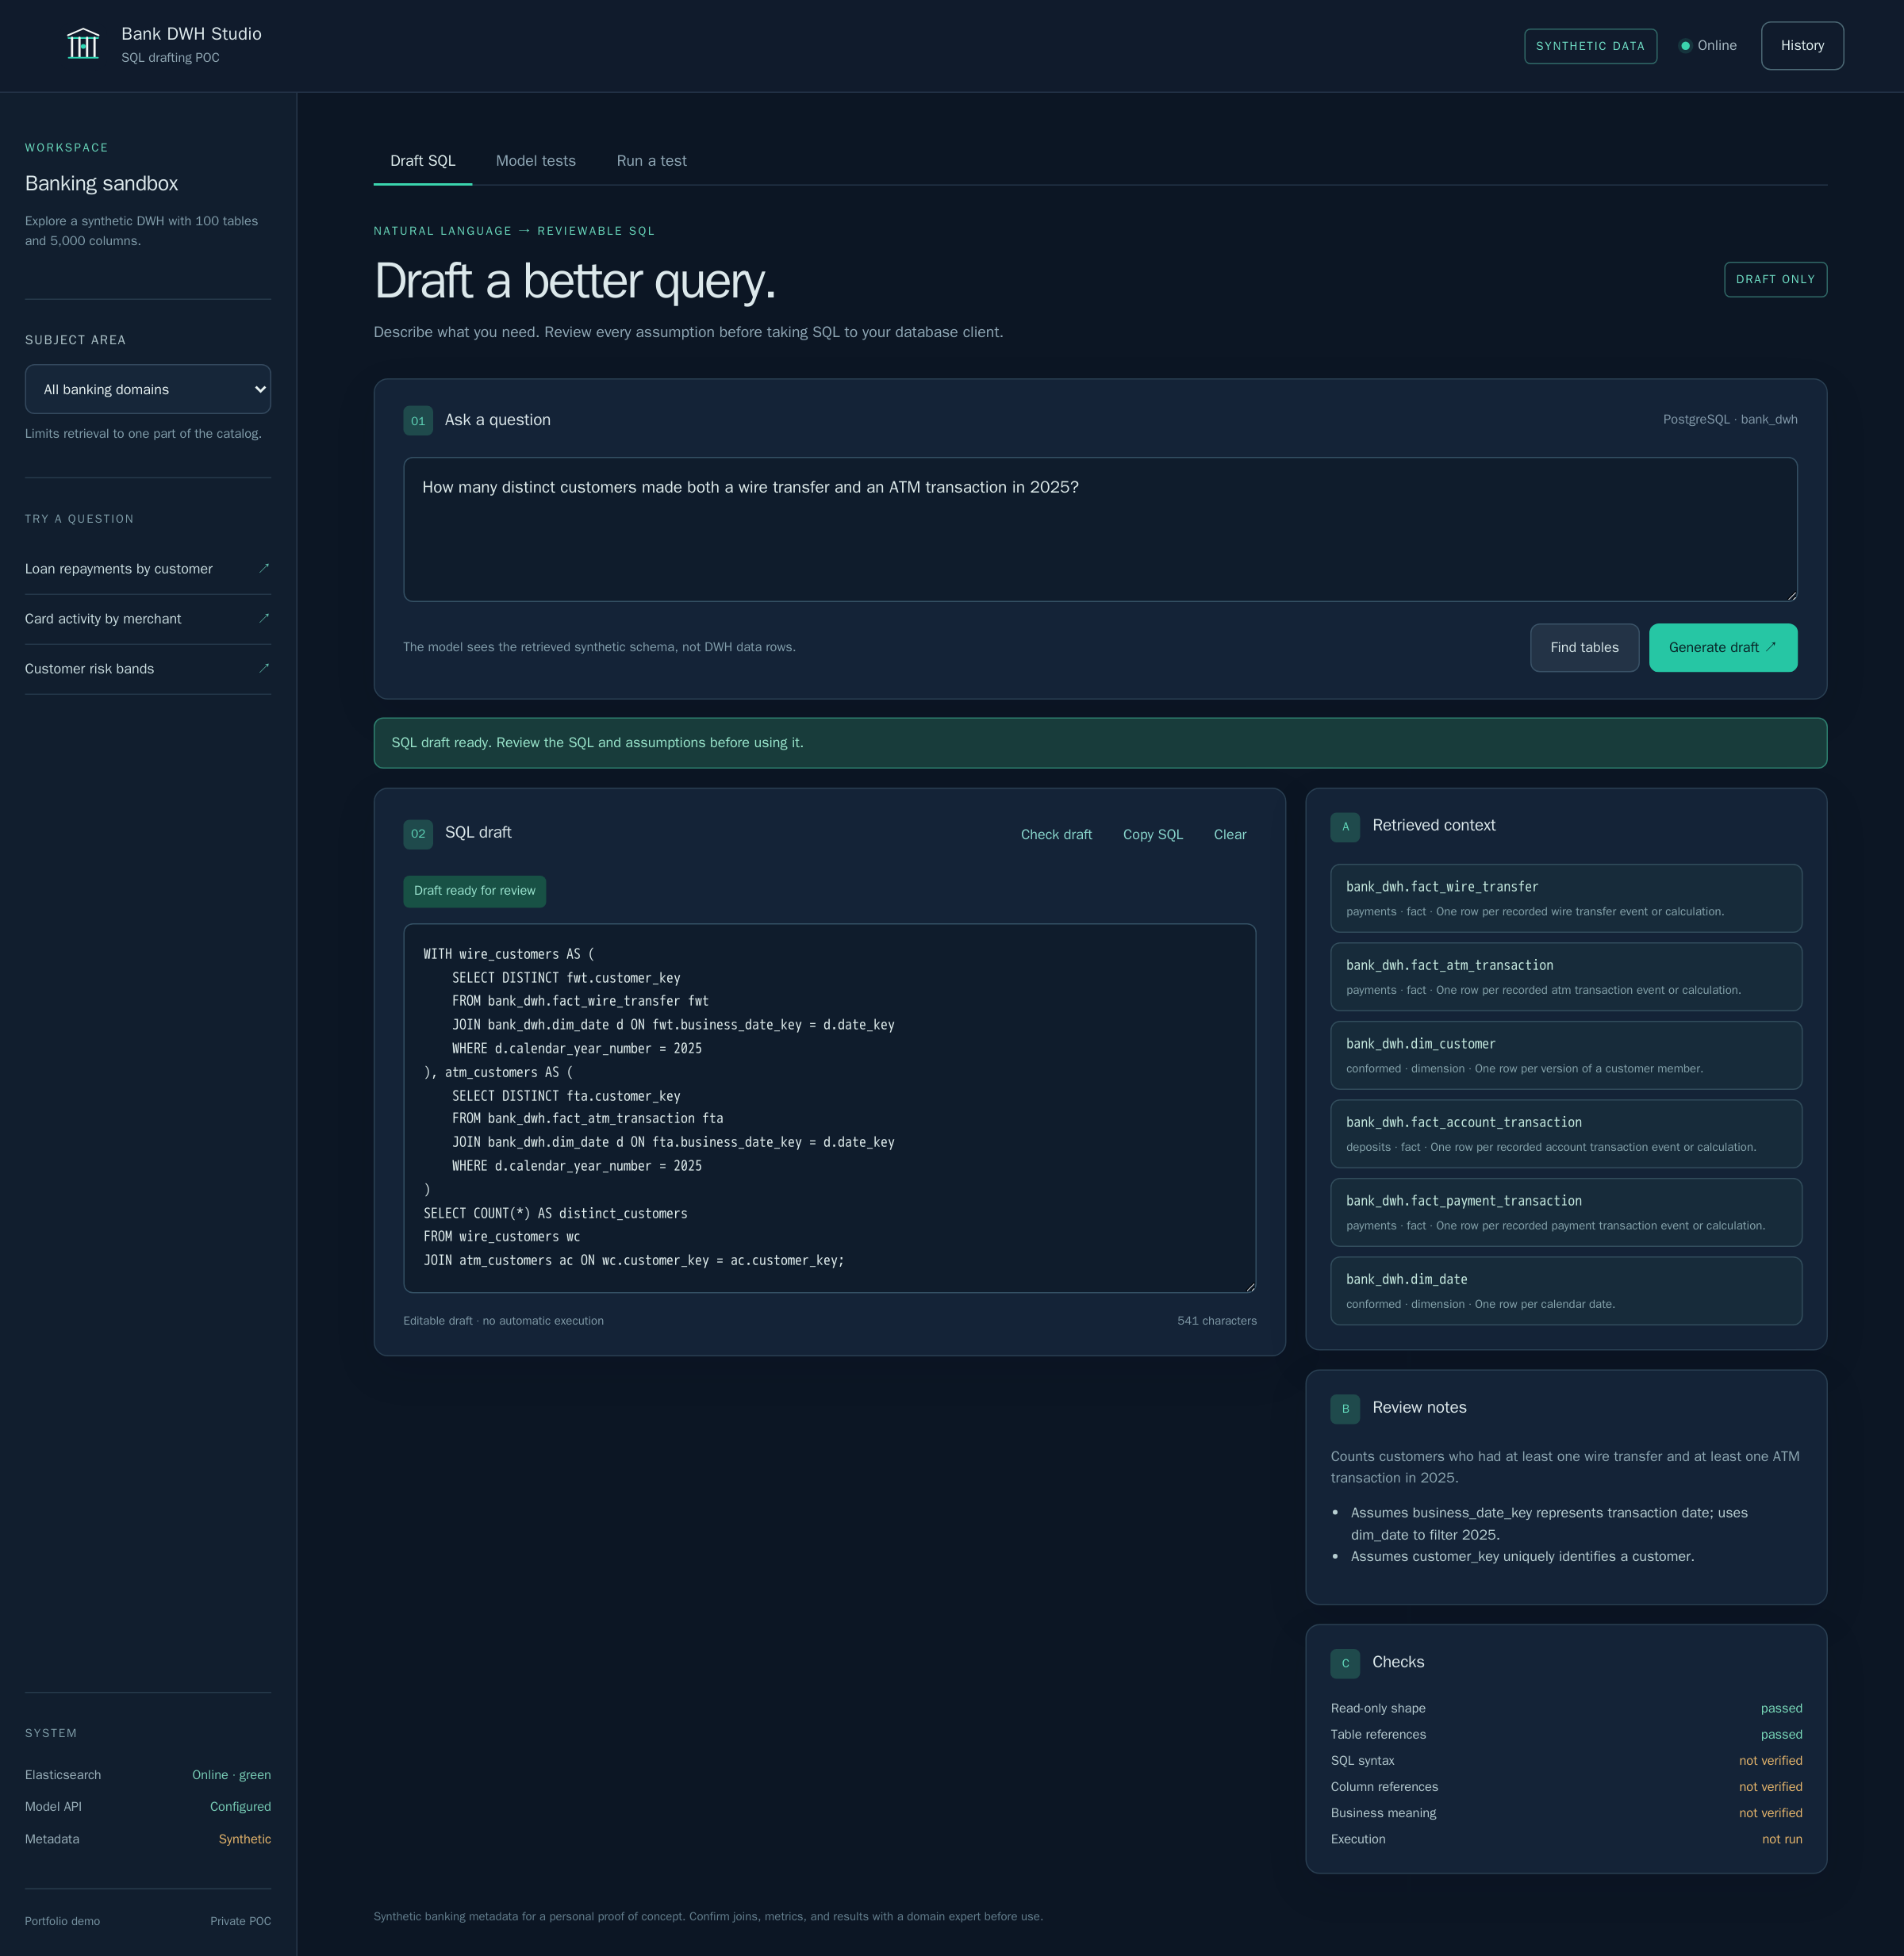
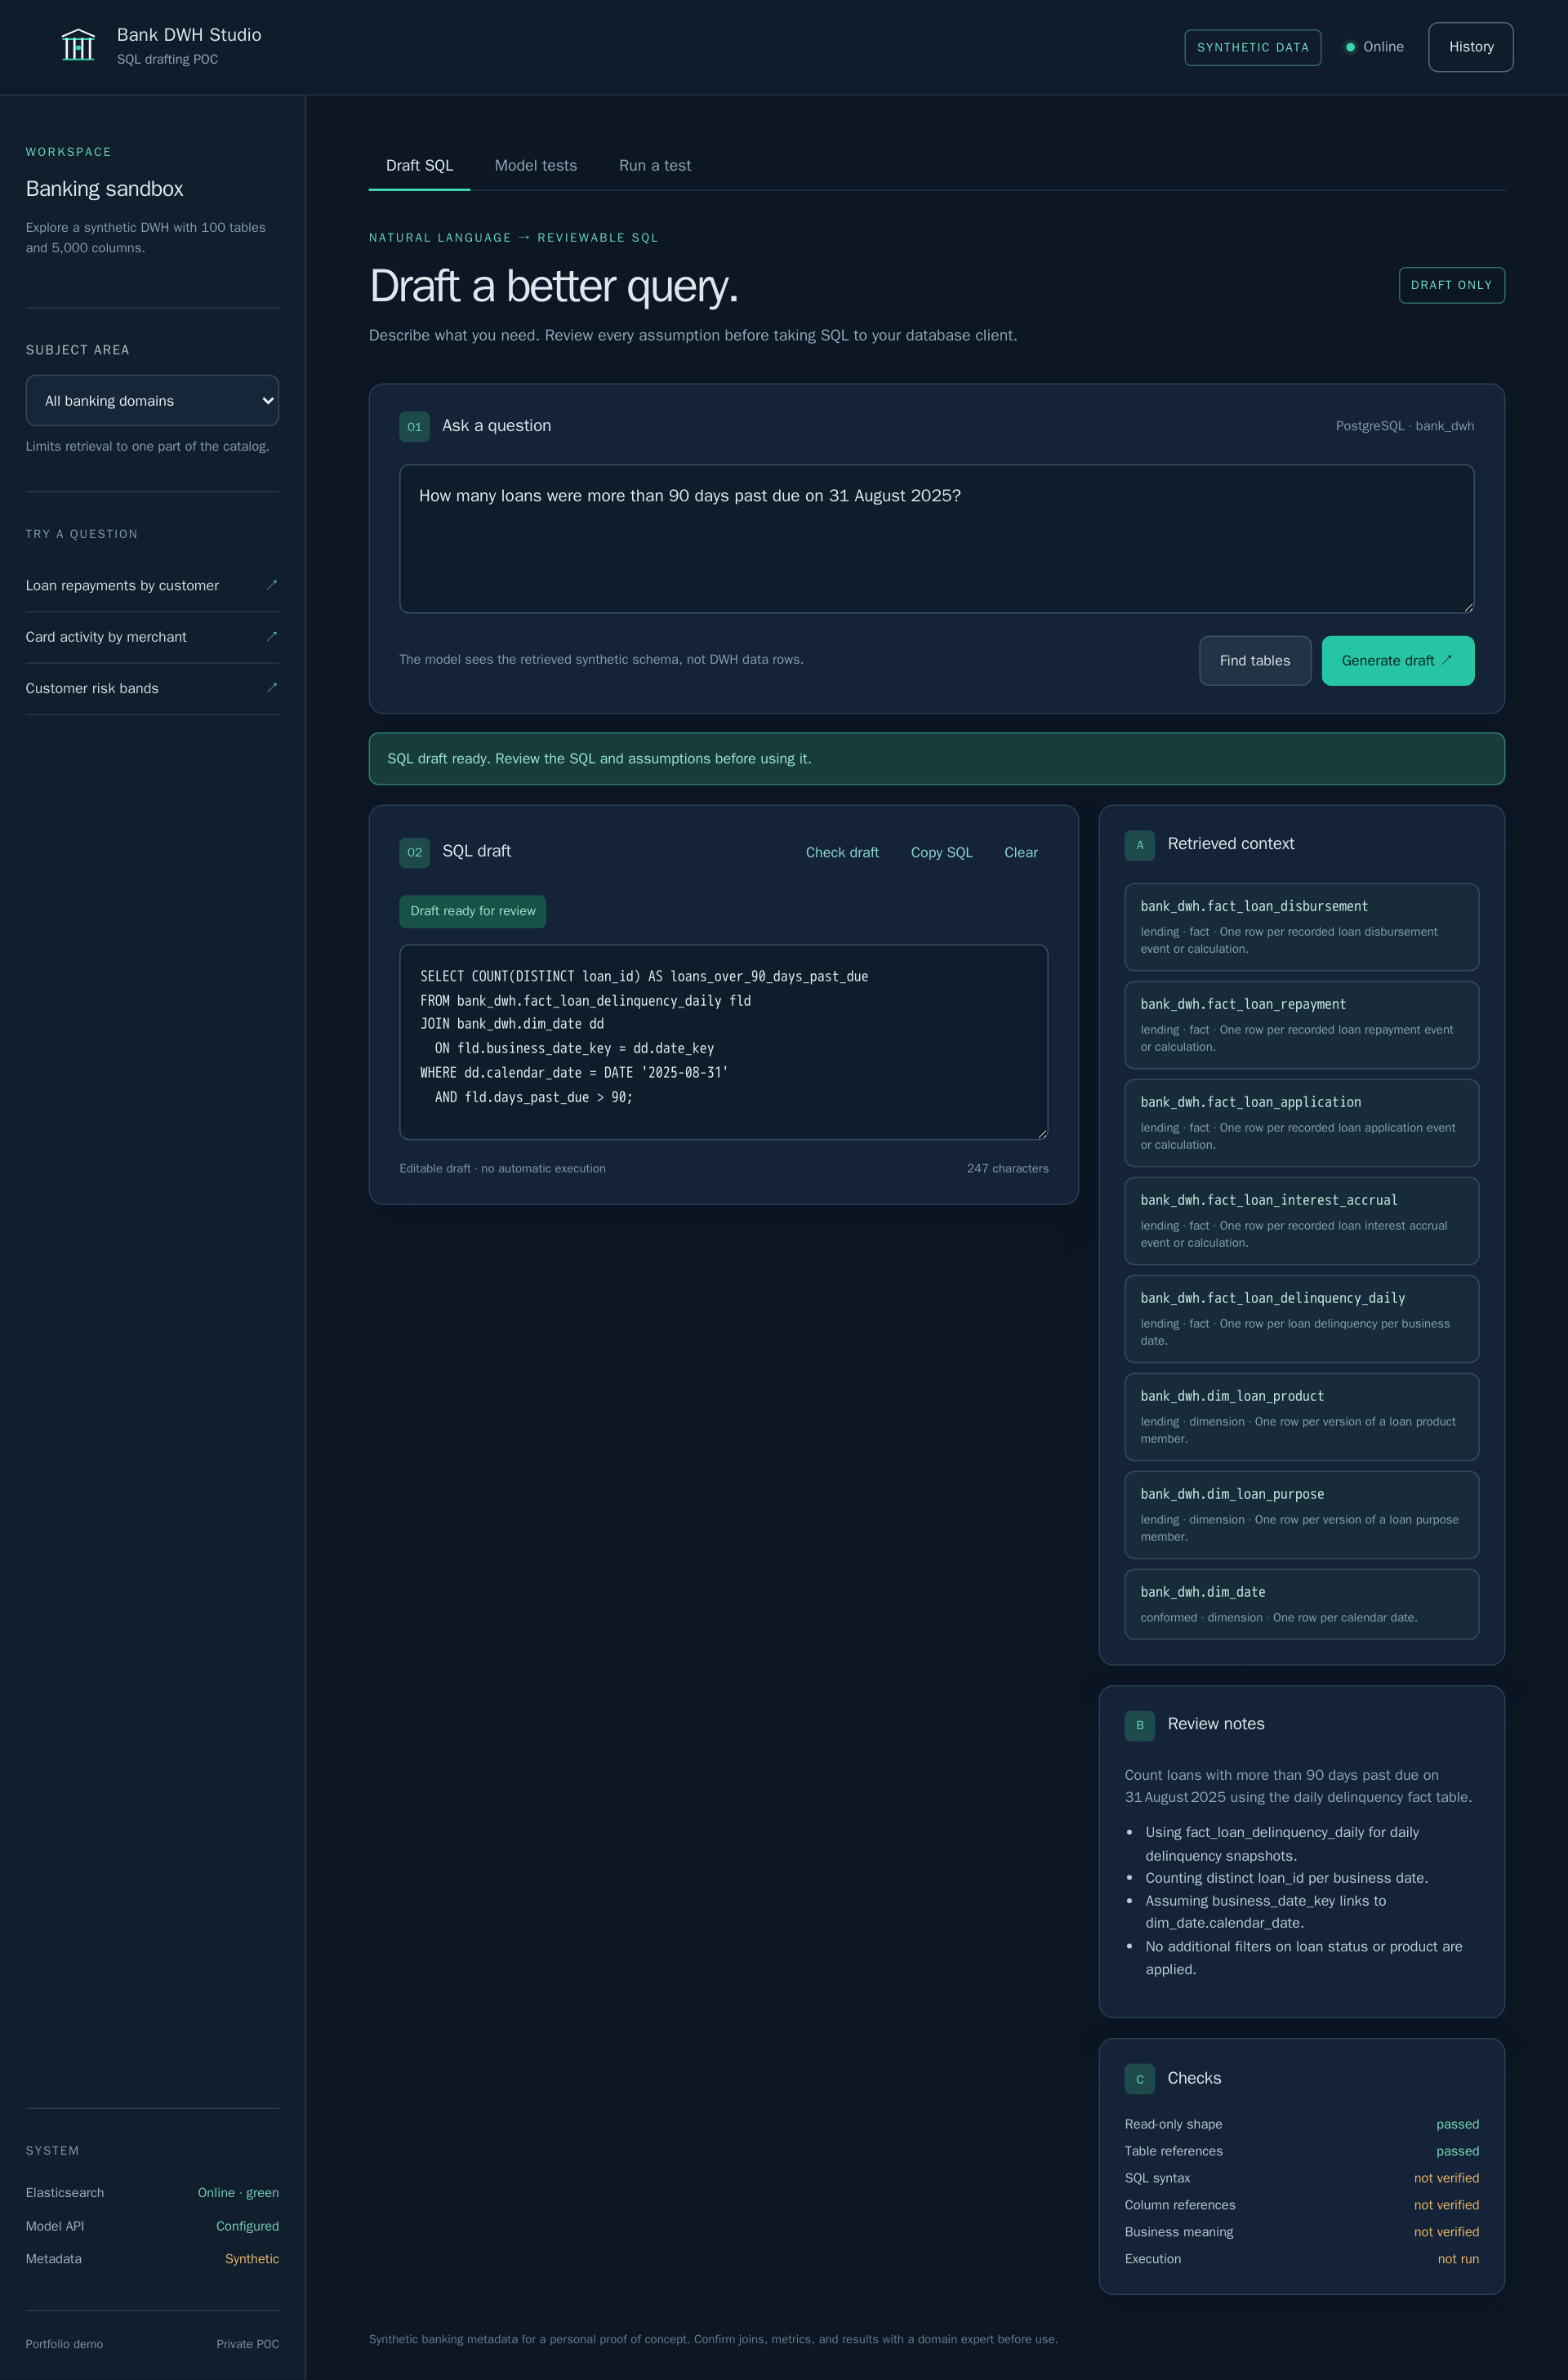
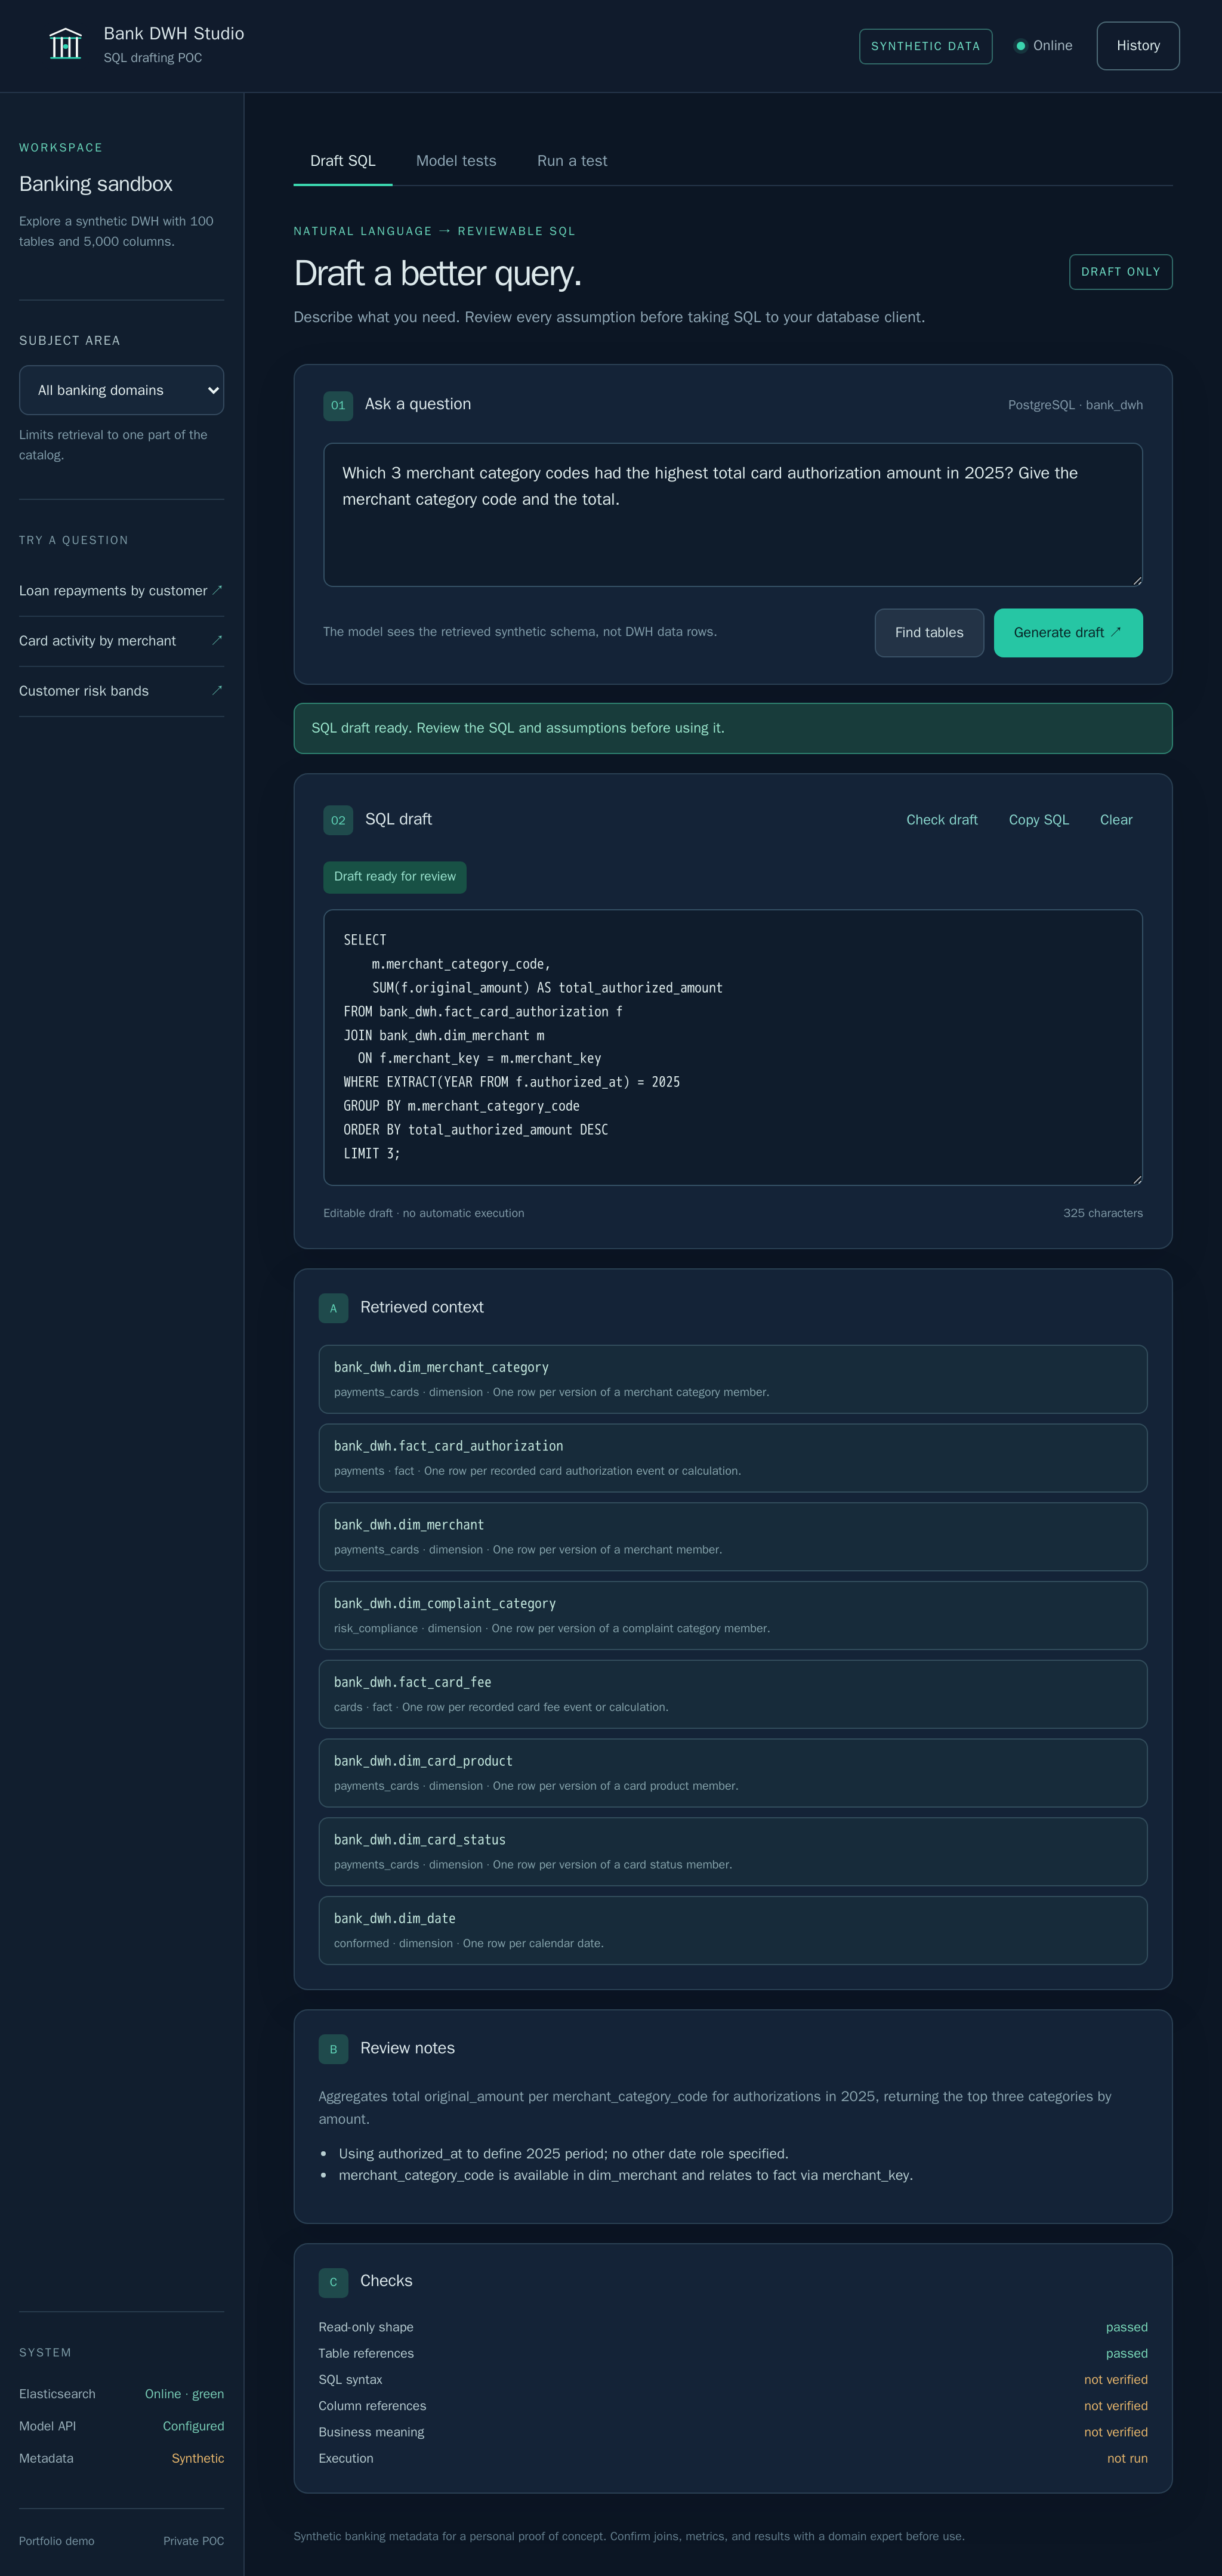
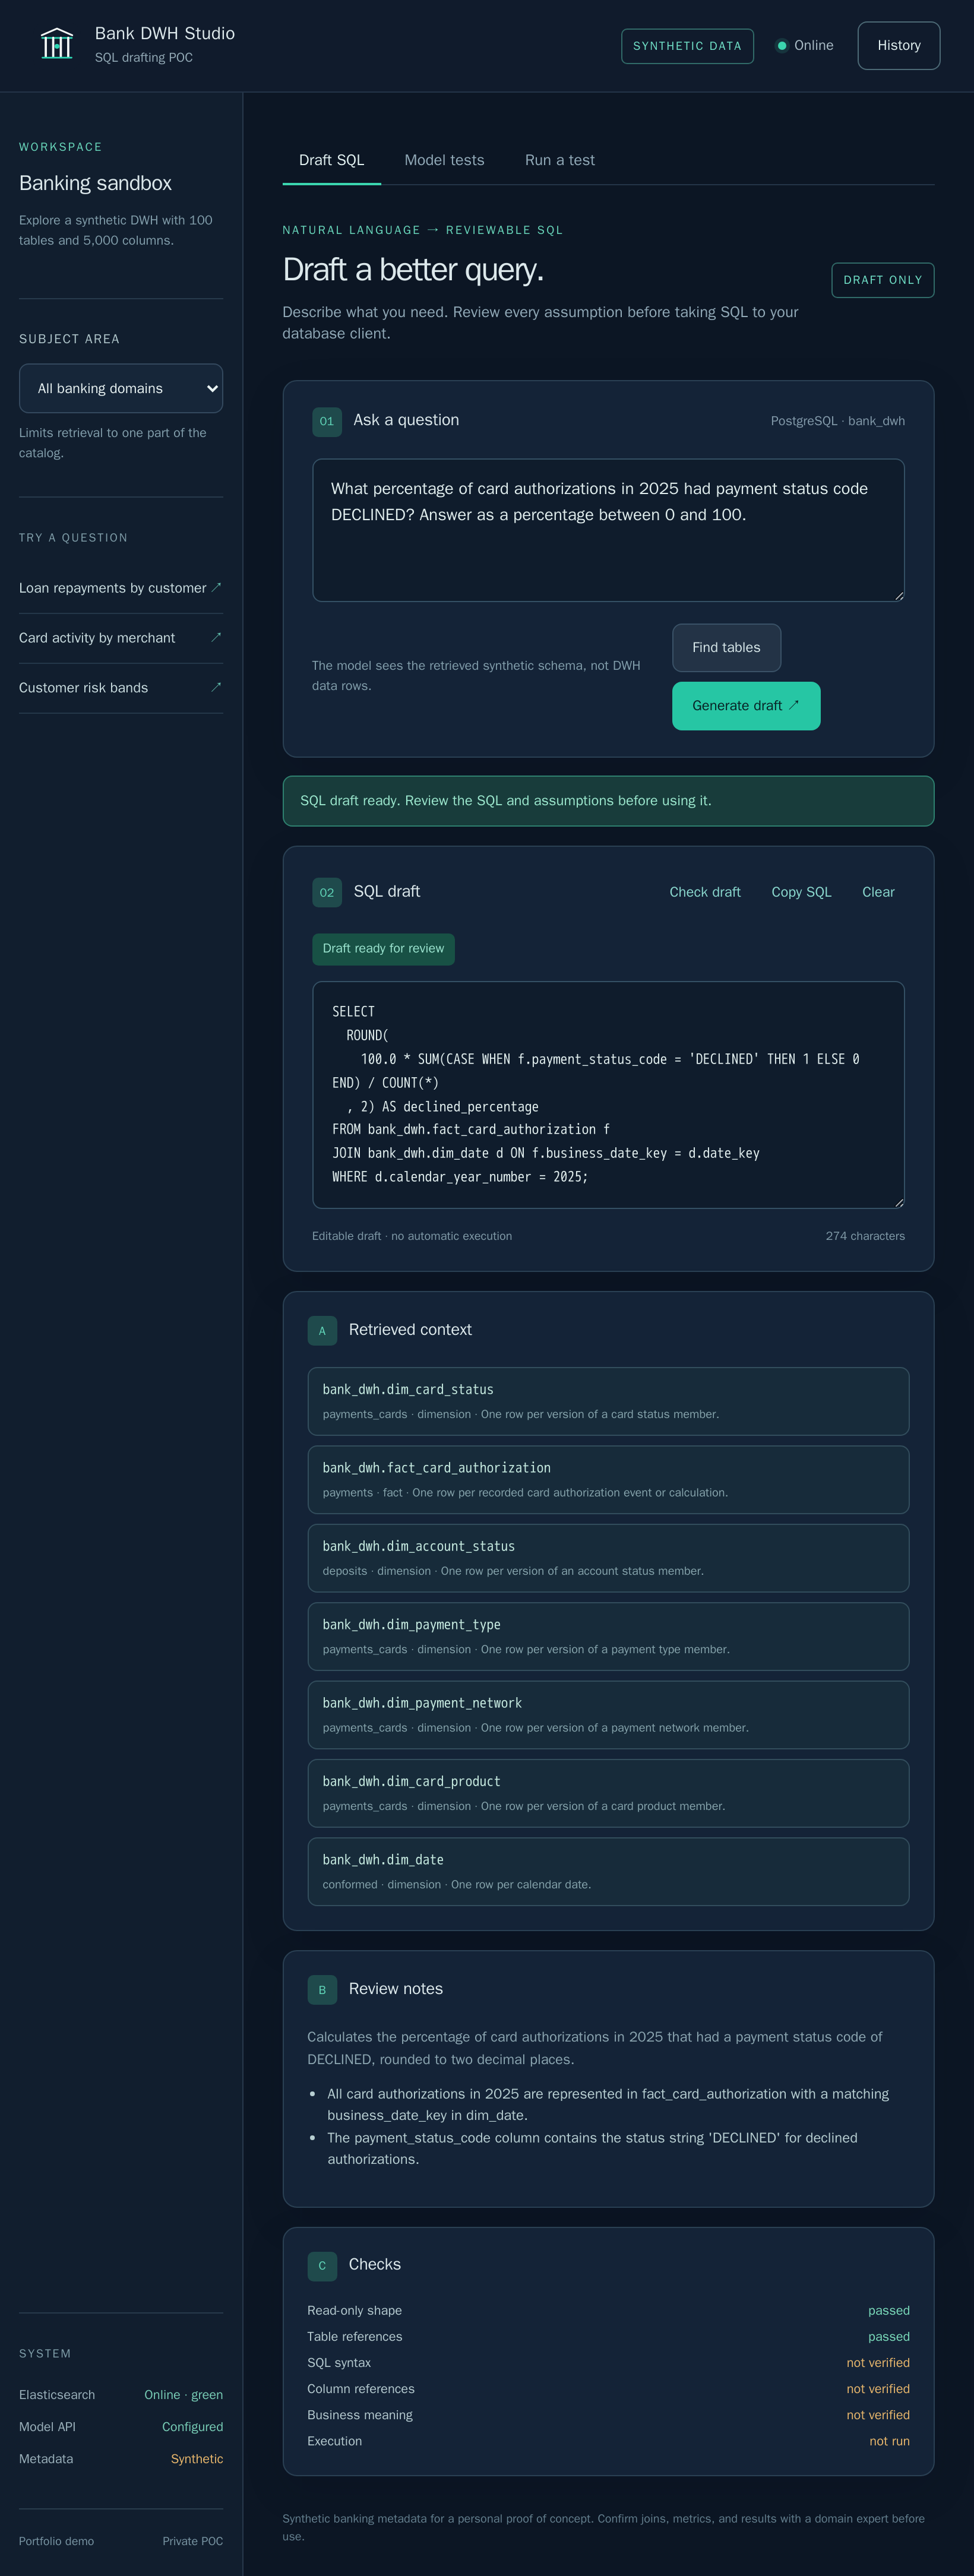
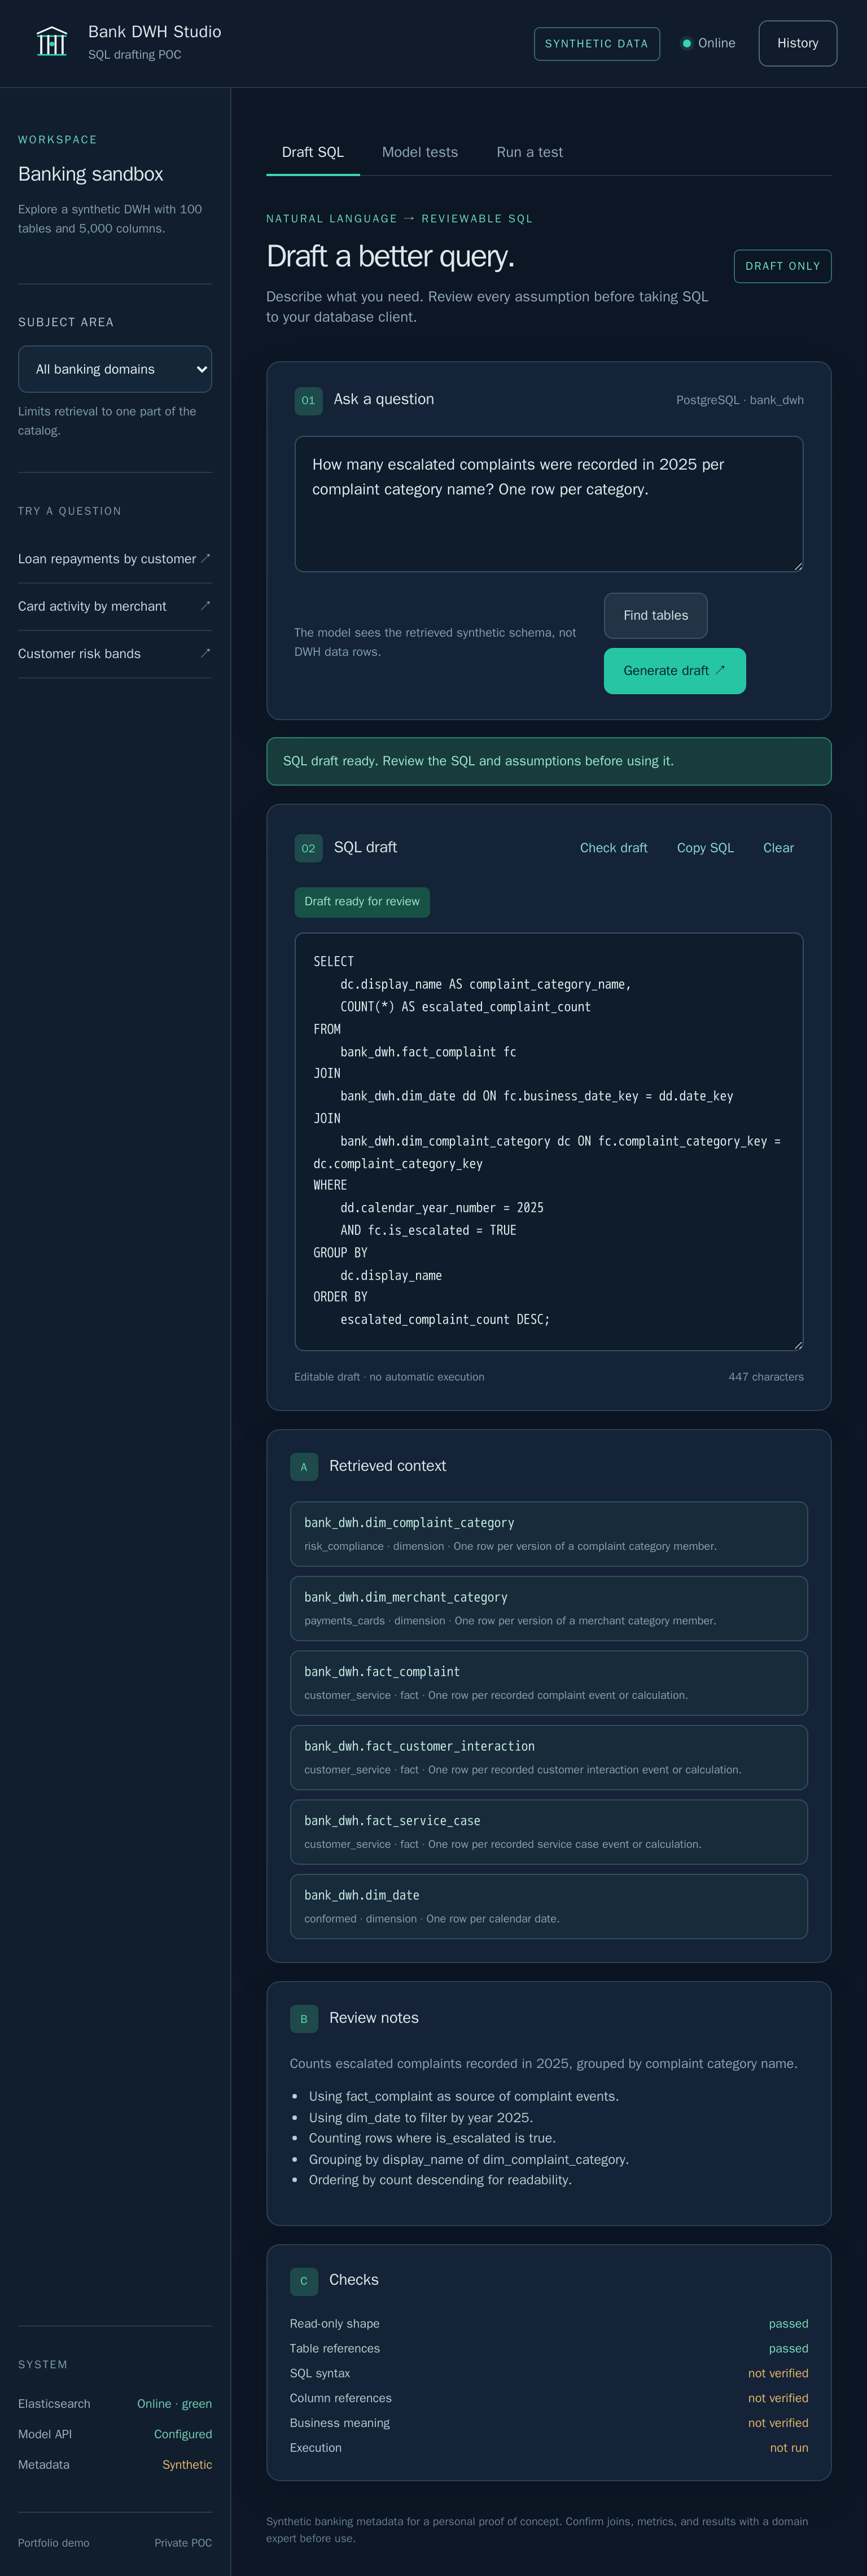
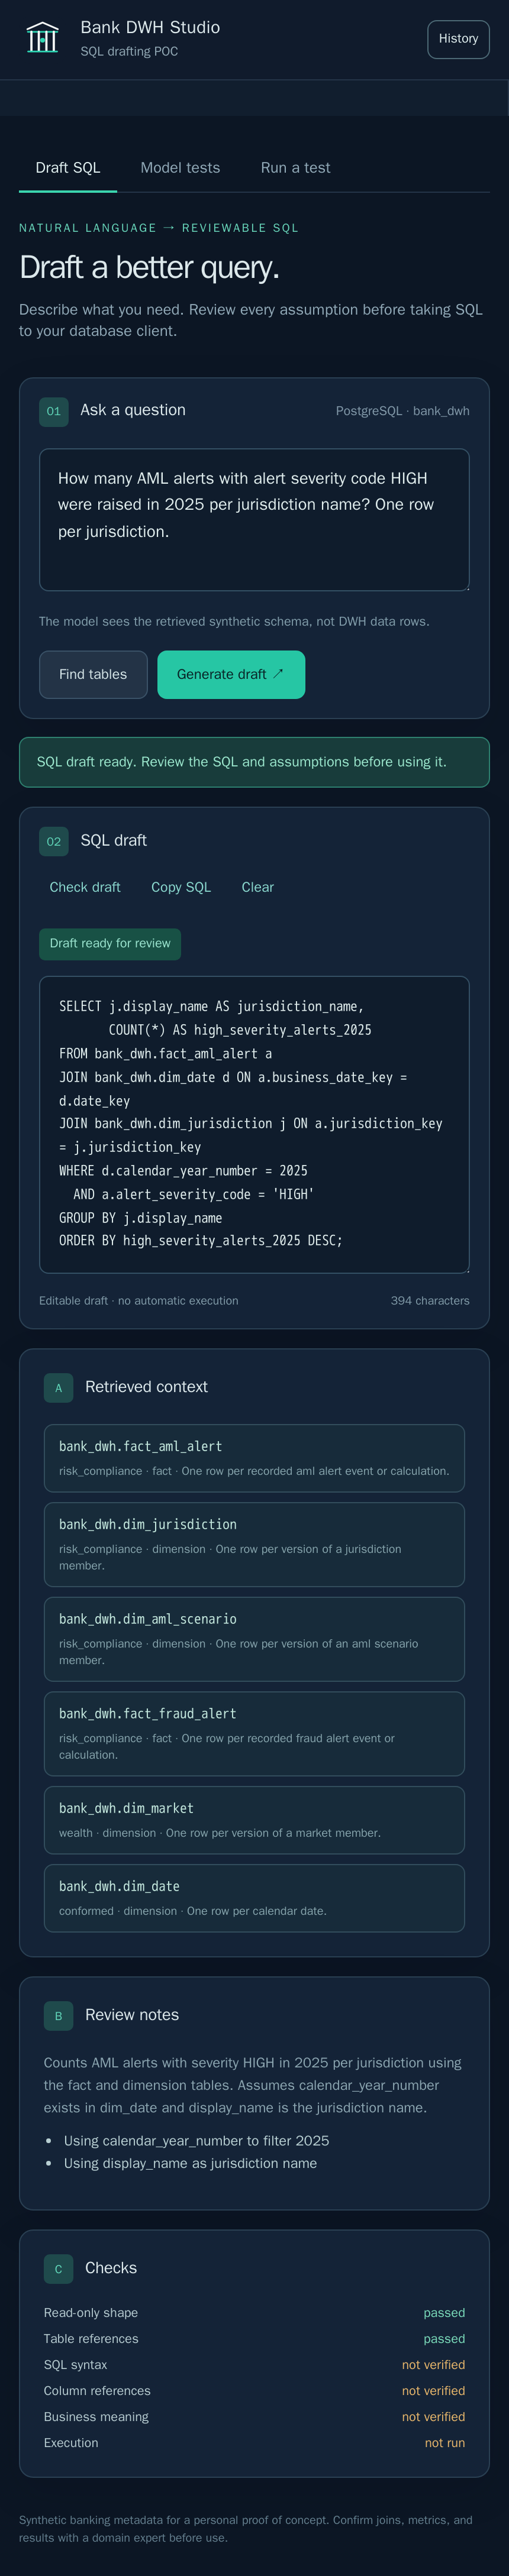
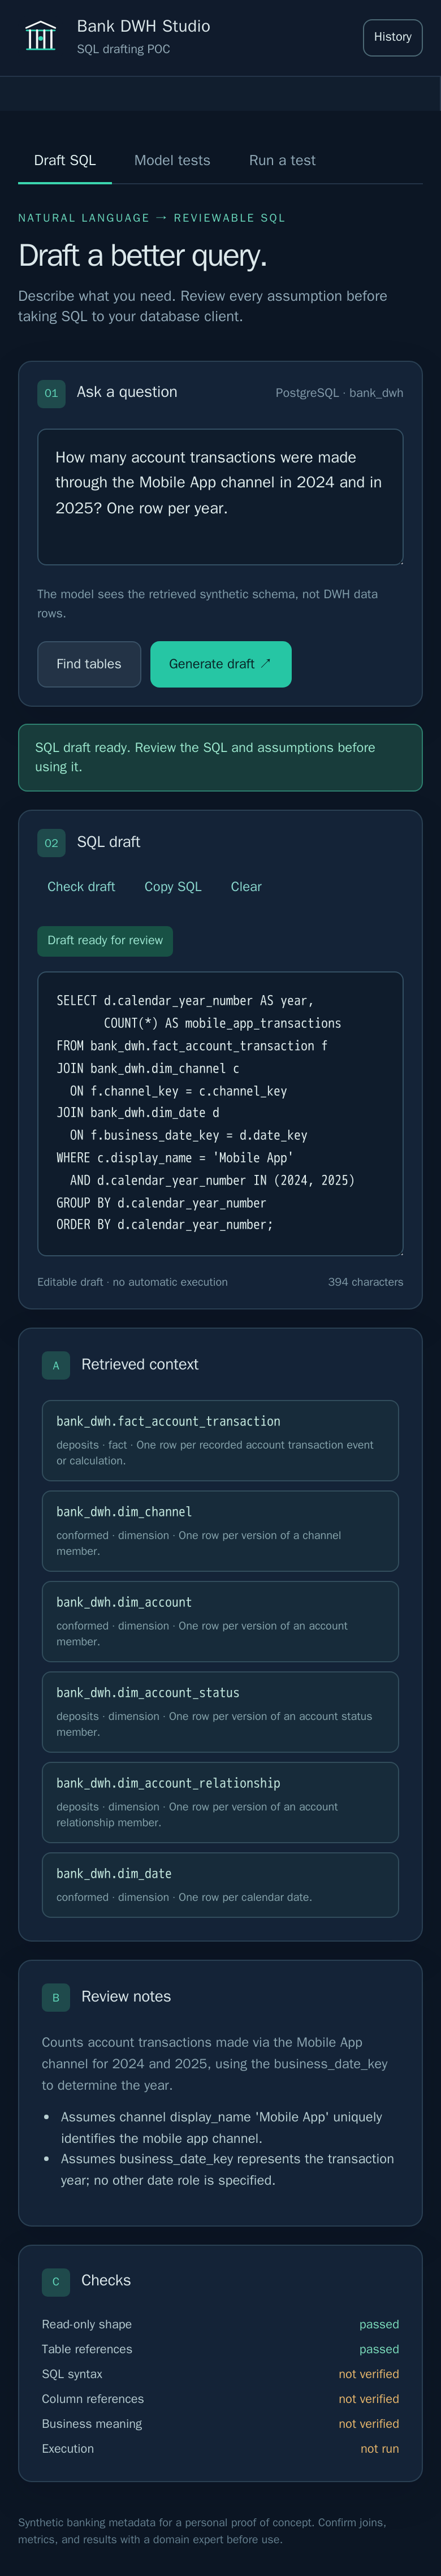
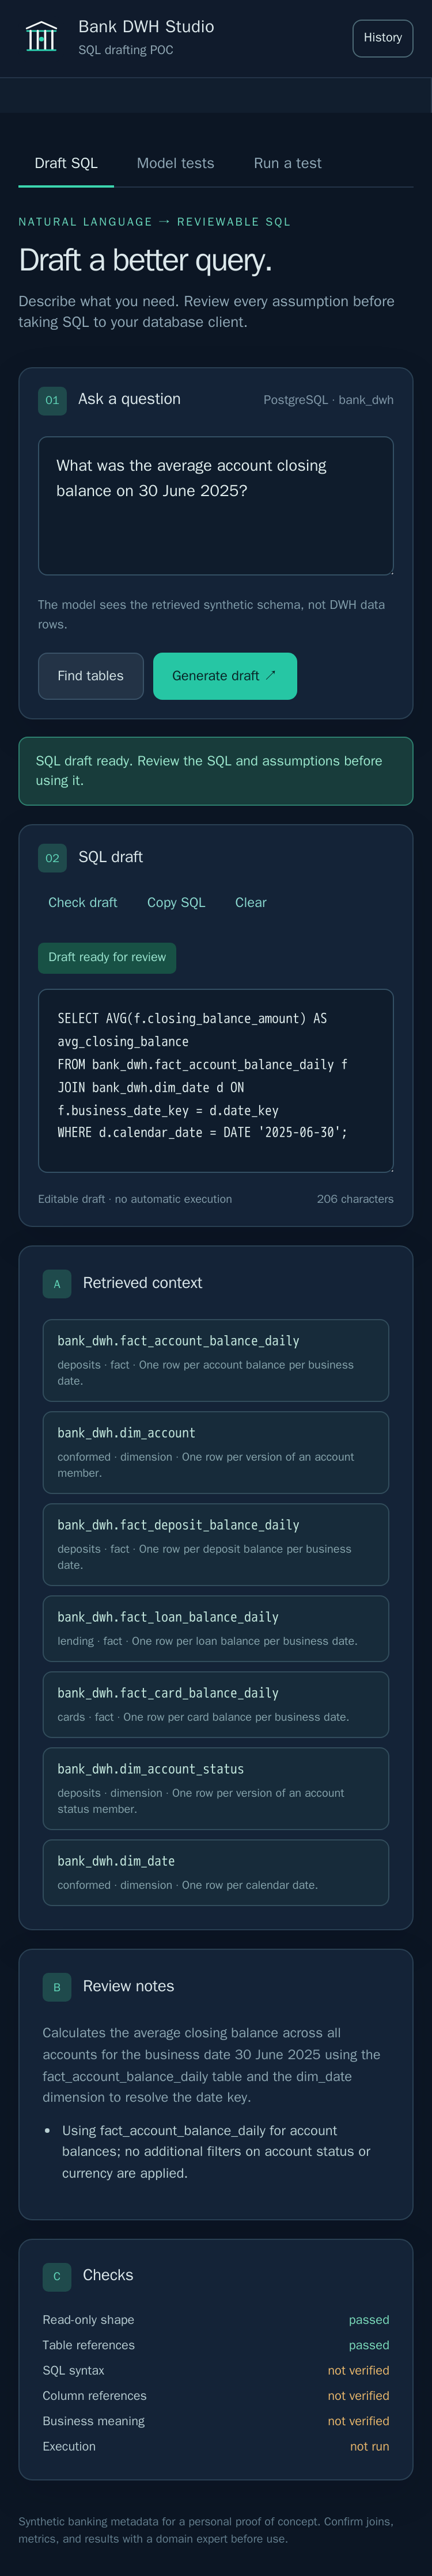
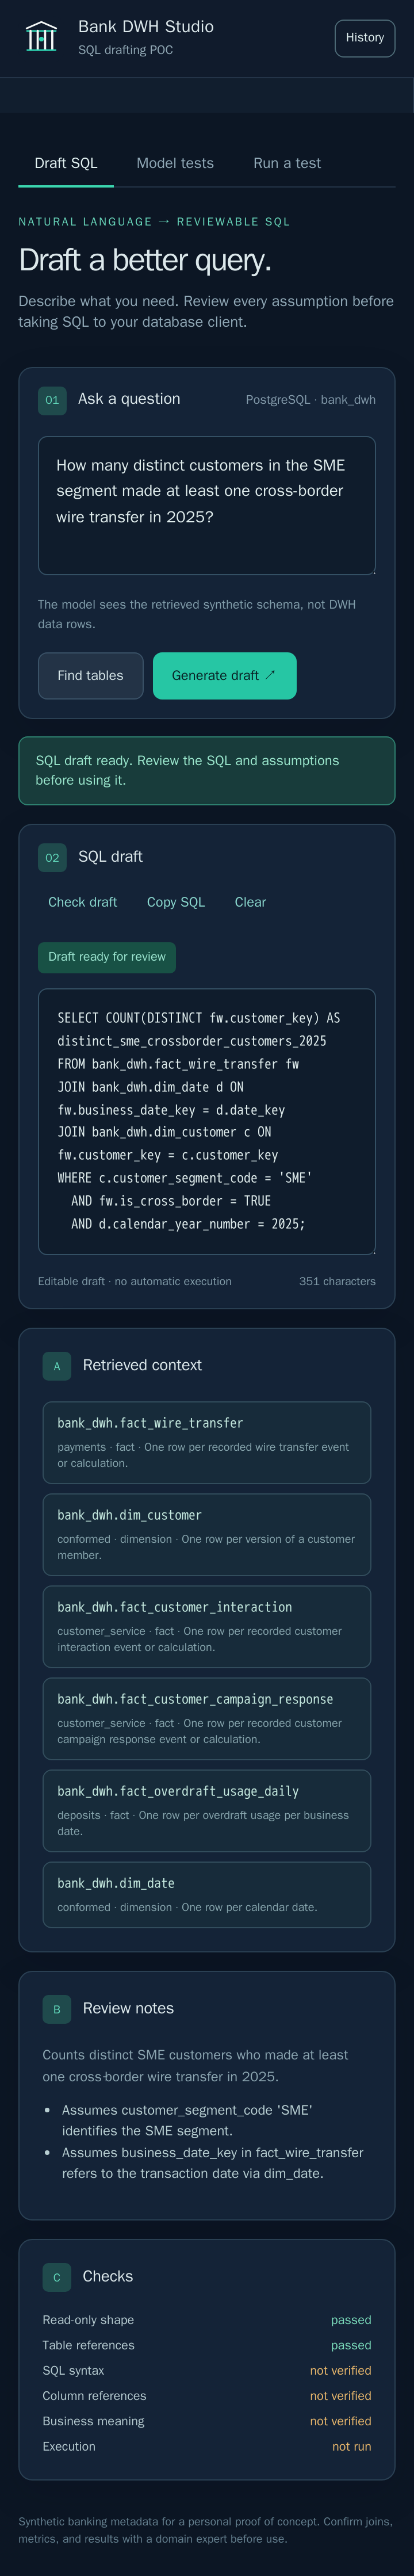
앱은 SQL 초안을 쓰고 시험하지만, 웨어하우스의 합성 사본에서, 읽기만 할 수 있는 사용자로만 그렇게 합니다. 실제 은행 웨어하우스에는 절대 연결하지 않습니다. 사용자는 여전히 결과를 검토한 뒤 편집하거나 복사해 자신의 데이터베이스 클라이언트에서 실행합니다. 브라우저는 모델의 API 키를 받지 않습니다.
자동 검사는 읽기 전용 명령문의 기본 형태와 알려진 테이블 참조만 확인합니다. SQL 구문, 열 참조, 비즈니스 의미는 여전히 사람이 검토해야 합니다. 웨어하우스의 모든 이름, 관계, 측정값은 합성 테스트 자료이며 승인된 은행 업무 정의가 아닙니다.
배포된 개념 증명은 Node 백엔드, Elasticsearch, 읽기 전용 PostgreSQL 웨어하우스를 Oracle Ampere A1 인스턴스에서 루트 권한 없는 컨테이너로 실행하고, 호스팅 공급자를 통한 gpt-oss-20b로 SQL을 씁니다. 저장소에는 더 넓은 향후 아키텍처도 문서화되어 있으며, 배포된 작은 POC와는 명확히 구분되어 있습니다.