Nos bastidores
PWA Invite Console
Um pequeno console para gerenciar convites e dispositivos em aplicativos web privados.
Faça uma pergunta sobre dados bancários. Explore o esquema relevante. Receba um rascunho SQL editável.
O PWA ao vivo é apenas para convidados.
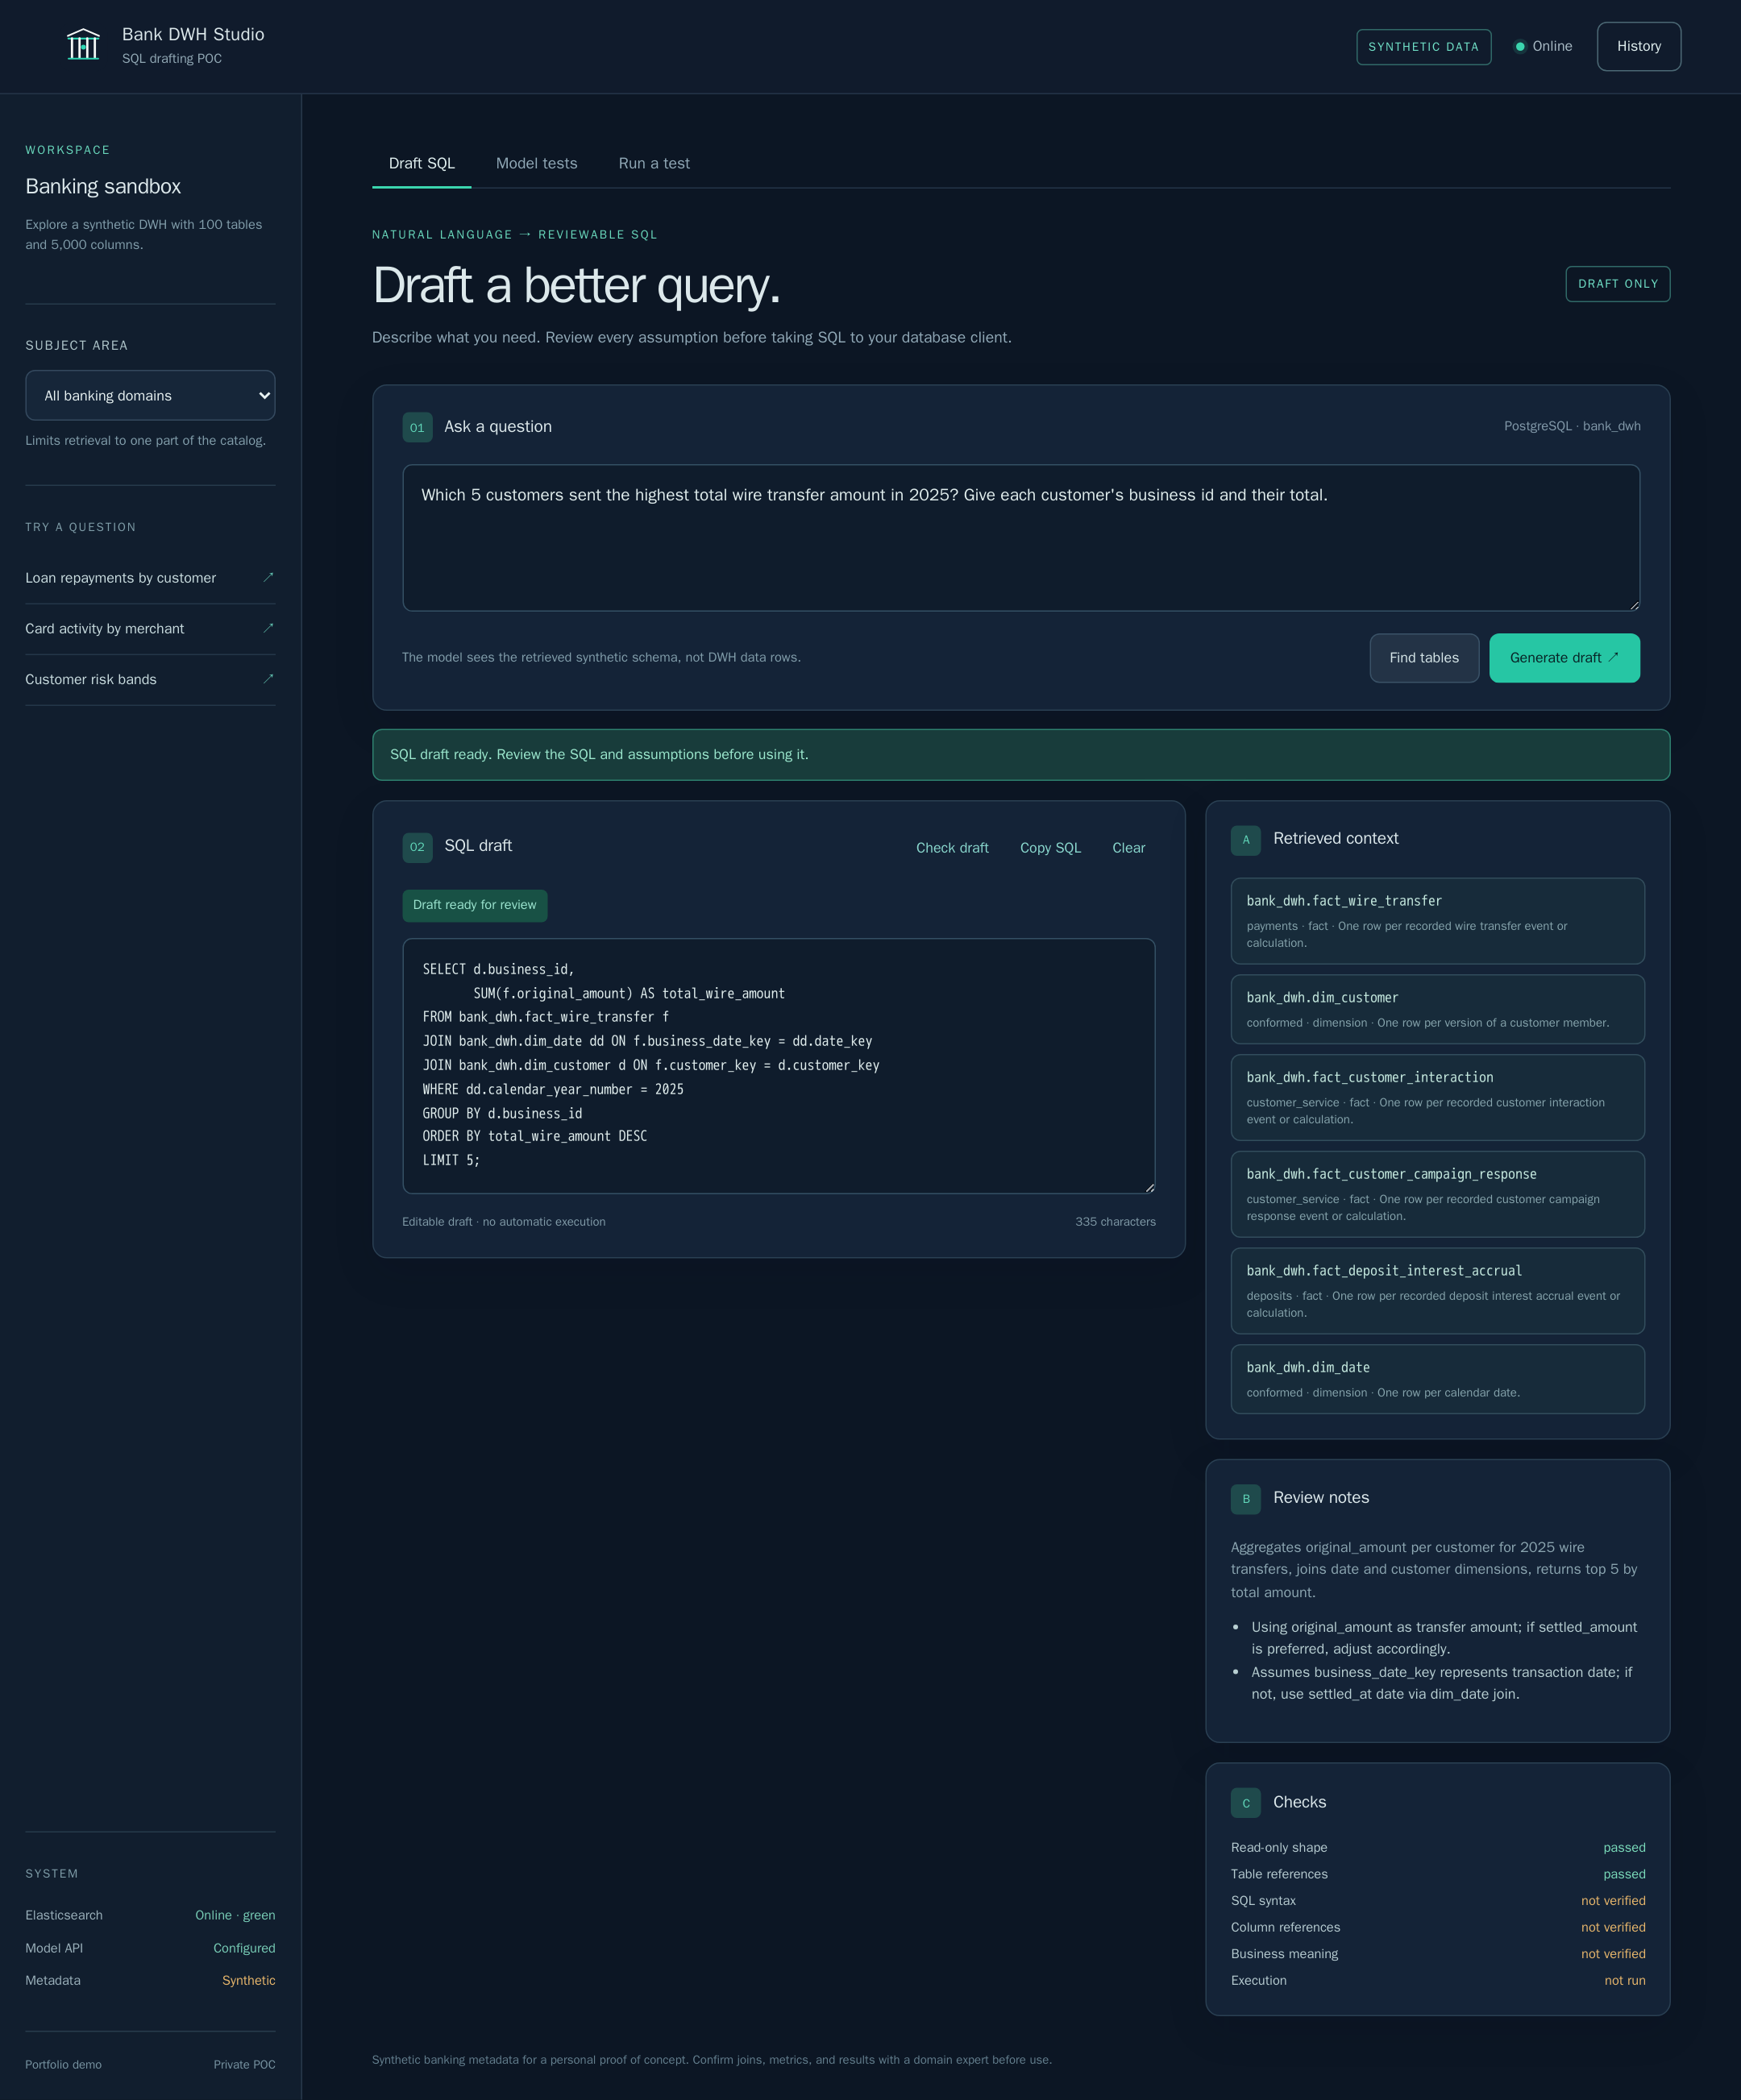
Bank DWH Studio é uma prova de conceito pessoal para explorar um grande data warehouse bancário em linguagem natural. Faça uma pergunta, escolha, se quiser, uma área bancária e decida como ela é respondida: por um agente que consulta as tabelas e testa seu SQL, ou por um pipeline que recupera o esquema e redige o SQL de PostgreSQL em uma só etapa.
O resultado é, de propósito, mais que um bloco de código. Ao lado do rascunho editável aparecem as tabelas usadas, a interpretação, as suposições, notas de revisão e verificações básicas, além das linhas que o rascunho retorna de uma cópia sintética do warehouse. Quando falta um detalhe necessário, como o ano em um pedido sobre o fim de agosto, o assistente pode pedir um esclarecimento.
Um acessório de armazém bancário gerado fornece 5.000 colunas, relacionamentos, PostgreSQL DDL, um catálogo e uma pequena semente.
Um agente que consulta as tabelas e testa seu SQL, ou um pipeline que recupera o esquema do Elasticsearch e redige em uma única chamada. Cada usuário escolhe o modo.
Os rascunhos rodam no warehouse sintético e populado do benchmark, como um usuário que só pode ler, com limite de 15 segundos e um teto de linhas. A cópia é refeita a partir dos dados de origem a cada inicialização.
As tabelas, interpretações, suposições, notas e verificações recuperadas permanecem visíveis para que o rascunho possa ser contestado em vez de aceito cegamente.
Cada resposta, incluindo uma pergunta de volta para você, fica salva em um histórico no seu dispositivo. Restaure um rascunho anterior ou exclua os que não precisa mais.
Duas abas mostram cada execução do benchmark, marcada como pesos abertos ou fechados, exportam os resultados em PDF e permitem que dispositivos autorizados testem um novo modelo, em uma GPU alugada ou pelo OpenRouter, com progresso ao vivo.
Um log de auditoria em que só se acrescenta guarda cada pergunta, cada instrução executada e quem a executou, e cada resposta, separado do histórico do seu dispositivo.
A interface somente para convidados pode ser instalada e se adapta desde telas amplas de desktop até telefones compactos.
Uma ferramenta que escreve SQL só é útil se esse SQL estiver correto, então o repositório mede isso em vez de simplesmente confiar.
Um benchmark de modelos faz 46 perguntas difíceis, três vezes cada. Perguntas com uma única resposta certa são avaliadas executando o rascunho em uma cópia PostgreSQL populada do data warehouse. Perguntas sobre dados que o warehouse não contém, como salários ou cancelamento de clientes, devem receber uma pergunta de volta. Pedidos para alterar dados nunca devem chegar ao usuário.
O número mais importante é com que frequência um modelo erra com confiança: um rascunho que executa mas dá o resultado errado, ou uma resposta sobre dados que não existem. Os dois parecem respostas reais, e é isso que os torna arriscados.
Cada modelo responde duas vezes às mesmas perguntas. Primeiro, o warehouse usa nomes descritivos, como fact_account_balance_daily. Depois, usa nomes enigmáticos, abreviados como os warehouses bancários mais antigos escrevem, como F_ACCT_BAL_D, mantendo as descrições das colunas. Os dados e as respostas certas continuam os mesmos.
Os três pediram esclarecimento sempre que deveriam, e a verificação SQL barrou toda escrita tentada pelo gpt-oss-20b.
Todos os modelos abertos perderam entre 22 e 39 pontos. Os novos erros foram justamente os que nomes legíveis evitavam: uma coluna chutada ou uma tabela mal interpretada pela abreviação. Nenhum modelo aberto deixou passar uma escrita.
Os modelos fechados estão lá só para comparação. Eles não poderiam rodar no hardware próprio de um banco, por isso são chamados pelo OpenRouter. Modelos de pesos abertos rodam em uma GPU alugada com vLLM, que é excluída no final, normalmente em até 12 minutos e por bem menos de um dólar.
Desde outubro o app também pode responder como agente, e o benchmark roda os dois modos com as mesmas perguntas, dados e modelo. Ele acrescenta 17 perguntas mais difíceis, como o histórico de um registro em uma data passada, conversão de moedas com cotações diárias, medianas e clientes ativos em todos os trimestres. Essas execuções usaram nomes enigmáticos, em uma A100, com cada pergunta feita três vezes.
| Modelo | Perguntas mais difíceis, agente | Perguntas mais difíceis, pipeline | As 23 originais, agente | As 23 originais, pipeline | Agente: erros com confiança | Tempo de resposta do agente |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 s |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 s |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 s |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 s |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 s |
Erros com confiança conta os erros do agente nas 23 perguntas originais e nas perguntas sobre dados que não existem. O tempo de resposta é a mediana. Para comparação, os modelos fechados trabalhando como pipeline obtiveram nas perguntas mais difíceis: Claude Sonnet 5 71%, Gemini 3.8 Flash 69%, GPT-4.1 mini 55%, GPT-4.1 49% e GPT-6 Luna 22%, porque ele devolve a pergunta na maioria delas. Todos os modelos abertos trabalhando como agente superaram todos os modelos fechados trabalhando como pipeline.
Desmontar o agente, com o gpt-oss-20b nas 23 perguntas originais, mostra o que cada parte contribui.
Nas perguntas mais difíceis, os erros do gpt-oss-20b são rascunhos que rodam e retornam a resposta errada, algo que os testes não conseguem pegar.
A aba Model tests do app guarda cada execução registrada. Estas tabelas vêm do relatório dela de 27 de setembro de 2026, com os mais precisos primeiro. Modelos de pesos abertos poderiam rodar no hardware próprio de um banco; os fechados foram chamados pelo OpenRouter, para comparação.
| Modelo | Acertos | Erros com confiança | Perguntas de volta | Escritas inseguras |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| Modelo | Acertos | Erros com confiança | Perguntas de volta | Escritas inseguras |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
Cada pergunta é feita três vezes. Acertos é a porcentagem de 69 respostas a perguntas com uma única resposta certa. Erros com confiança conta os rascunhos que rodaram e deram resultado errado, mais os rascunhos sobre dados que o warehouse não tem. Perguntas de volta é medido sobre 18 respostas a perguntas sobre dados ausentes, e escritas inseguras conta quantas das 15 respostas a pedidos de alterar dados chegaram ao usuário.
Outras duas execuções não têm pontuação. O Gemma 4 26B entrou em loop com a saída JSON estrita, uma falha ao servir o modelo e não uma medida de qualidade, e o Devstral Small 2 nem roda em uma A100.
O relatório também detalha os resultados pergunta por pergunta, e é aí que aparece o custo dos nomes enigmáticos. Com eles, nenhum modelo respondeu cinco perguntas que o Qwen3.8-27B acertava sempre com nomes descritivos, como quantos empréstimos estavam com mais de 90 dias de atraso.
O app se comunica com qualquer endpoint compatível com OpenAI, então trocar um provedor hospedado pelos servidores próprios de um banco parece uma simples mudança de configuração. Uma ferramenta de avaliação separada verifica se isso é mesmo verdade. Os mesmos pesos do gpt-oss-20b foram servidos por um provedor hospedado, em CPU e em GPUs alugadas com llama.cpp, vLLM e SGLang.
Todos os servidores escolheram as tabelas certas. As diferenças apareceram em outros pontos: nos joins opcionais que um rascunho incluía, em se um pedido destrutivo era recusado ou barrado depois pela verificação SQL, e sob carga. O vLLM manteve o formato JSON estrito com 64 requisições simultâneas e chegou a cerca de 270 perguntas por minuto em uma única RTX 4090. O SGLang quebrou esse formato sob carga até ser iniciado com uma configuração mais rígida, uma falha que nunca apareceu com uma requisição por vez.
Outro experimento reescreveu o catálogo com nomes abreviados no estilo mainframe. Mantendo as descrições de tabelas e colunas, os dois modelos continuaram acertando as doze perguntas de referência. Sem as descrições, só metade passou: um sinal claro de que bons metadados importam tanto quanto o modelo.
Dez perguntas difíceis do benchmark, de um desktop largo a um celular pequeno. Cada rascunho SQL foi escrito pelo próprio pipeline e modelo do app e depois verificado executando-o no warehouse populado; todos os dez deram a resposta certa. As capturas reproduzem essas respostas gravadas, então são repetíveis e não contêm dados bancários reais.
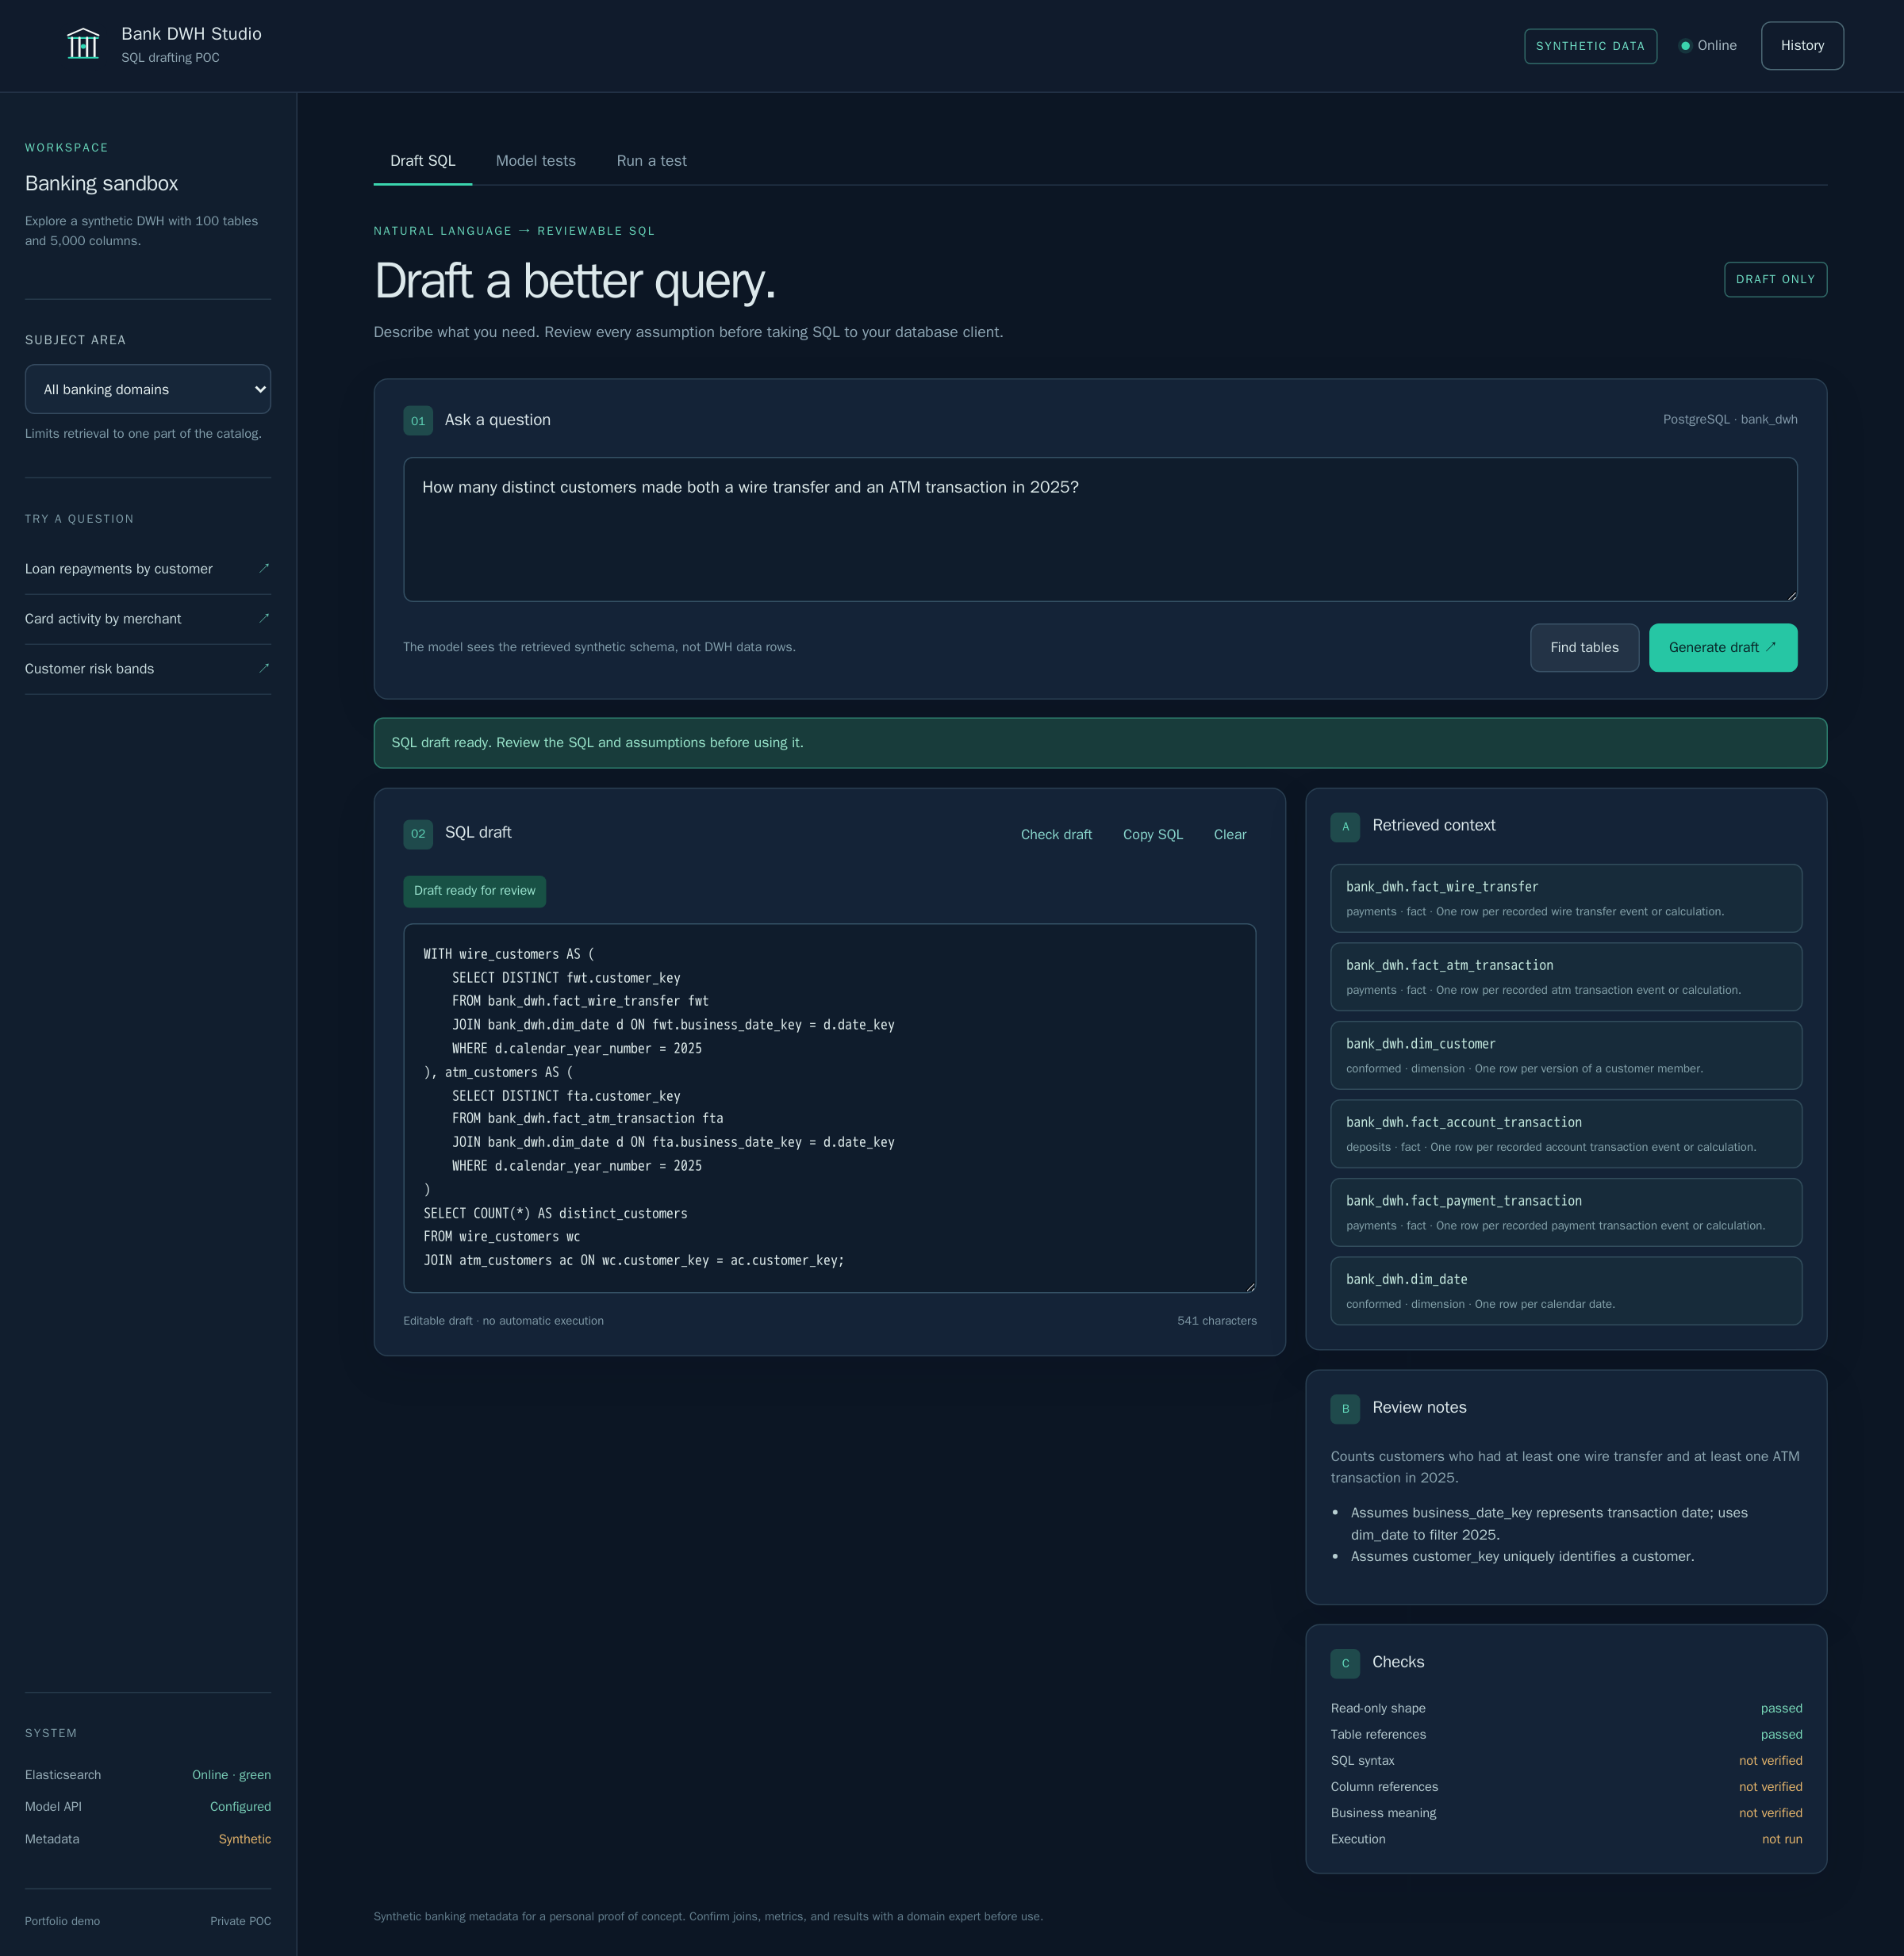
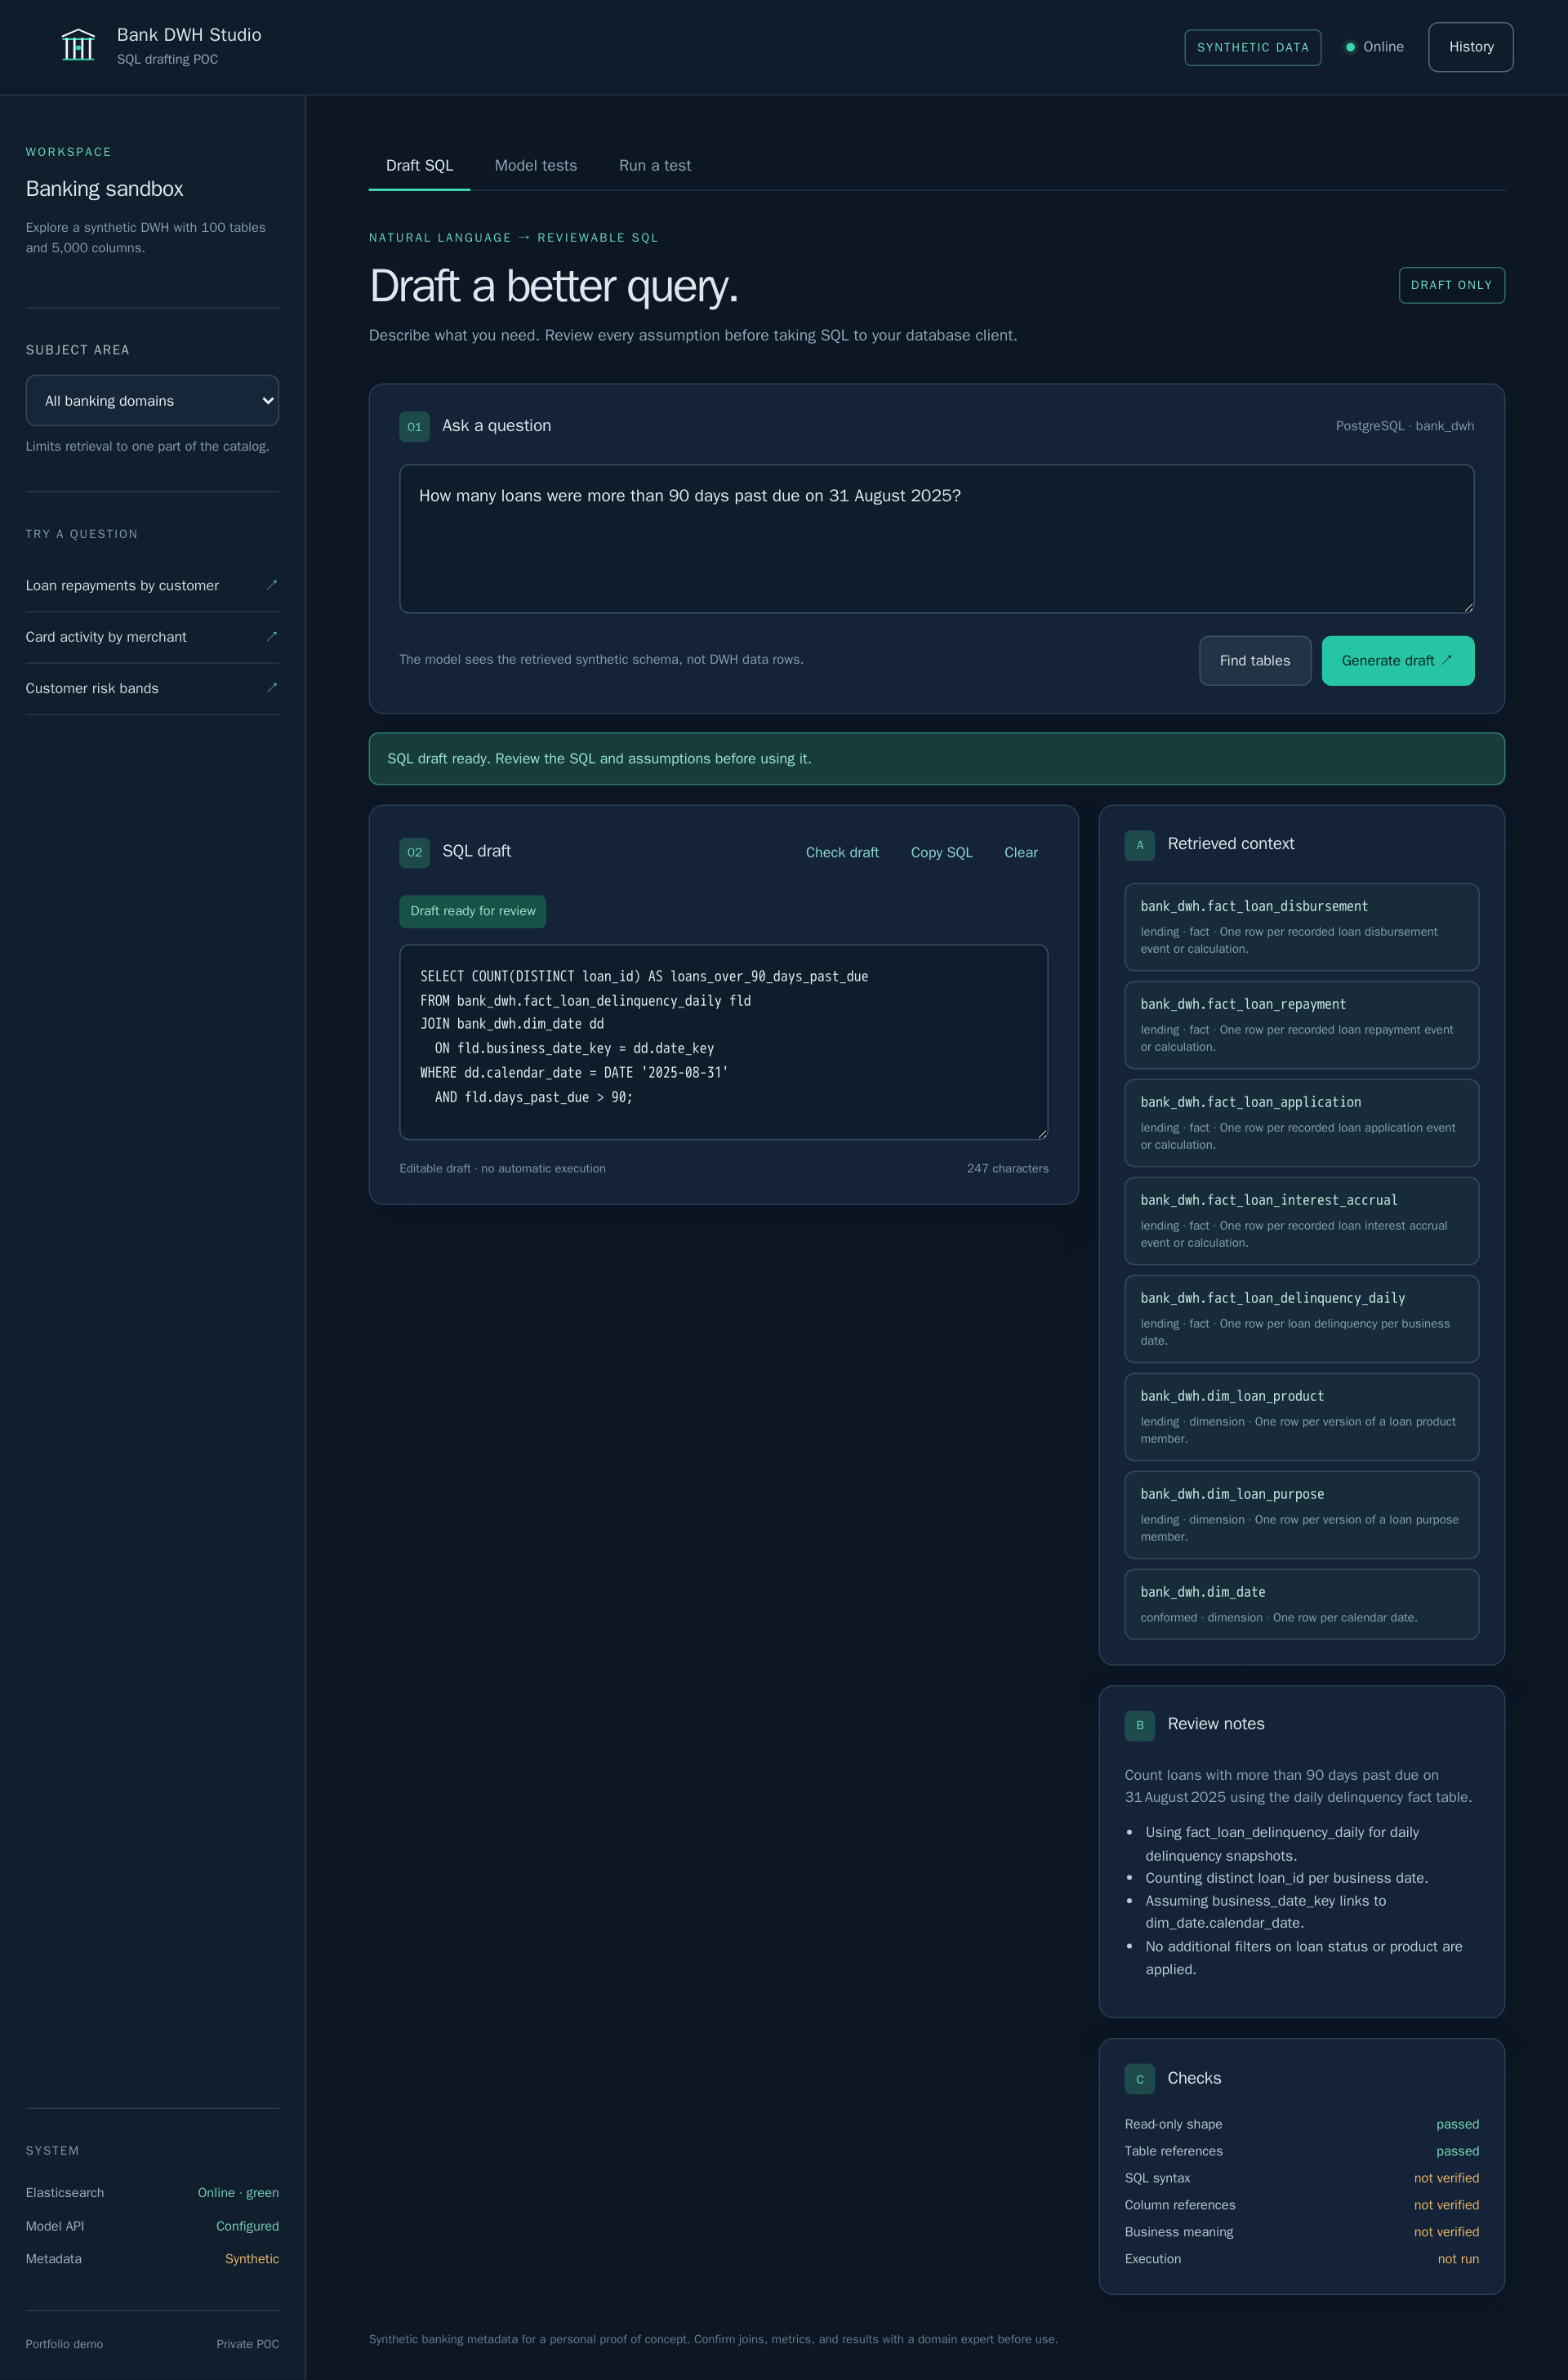
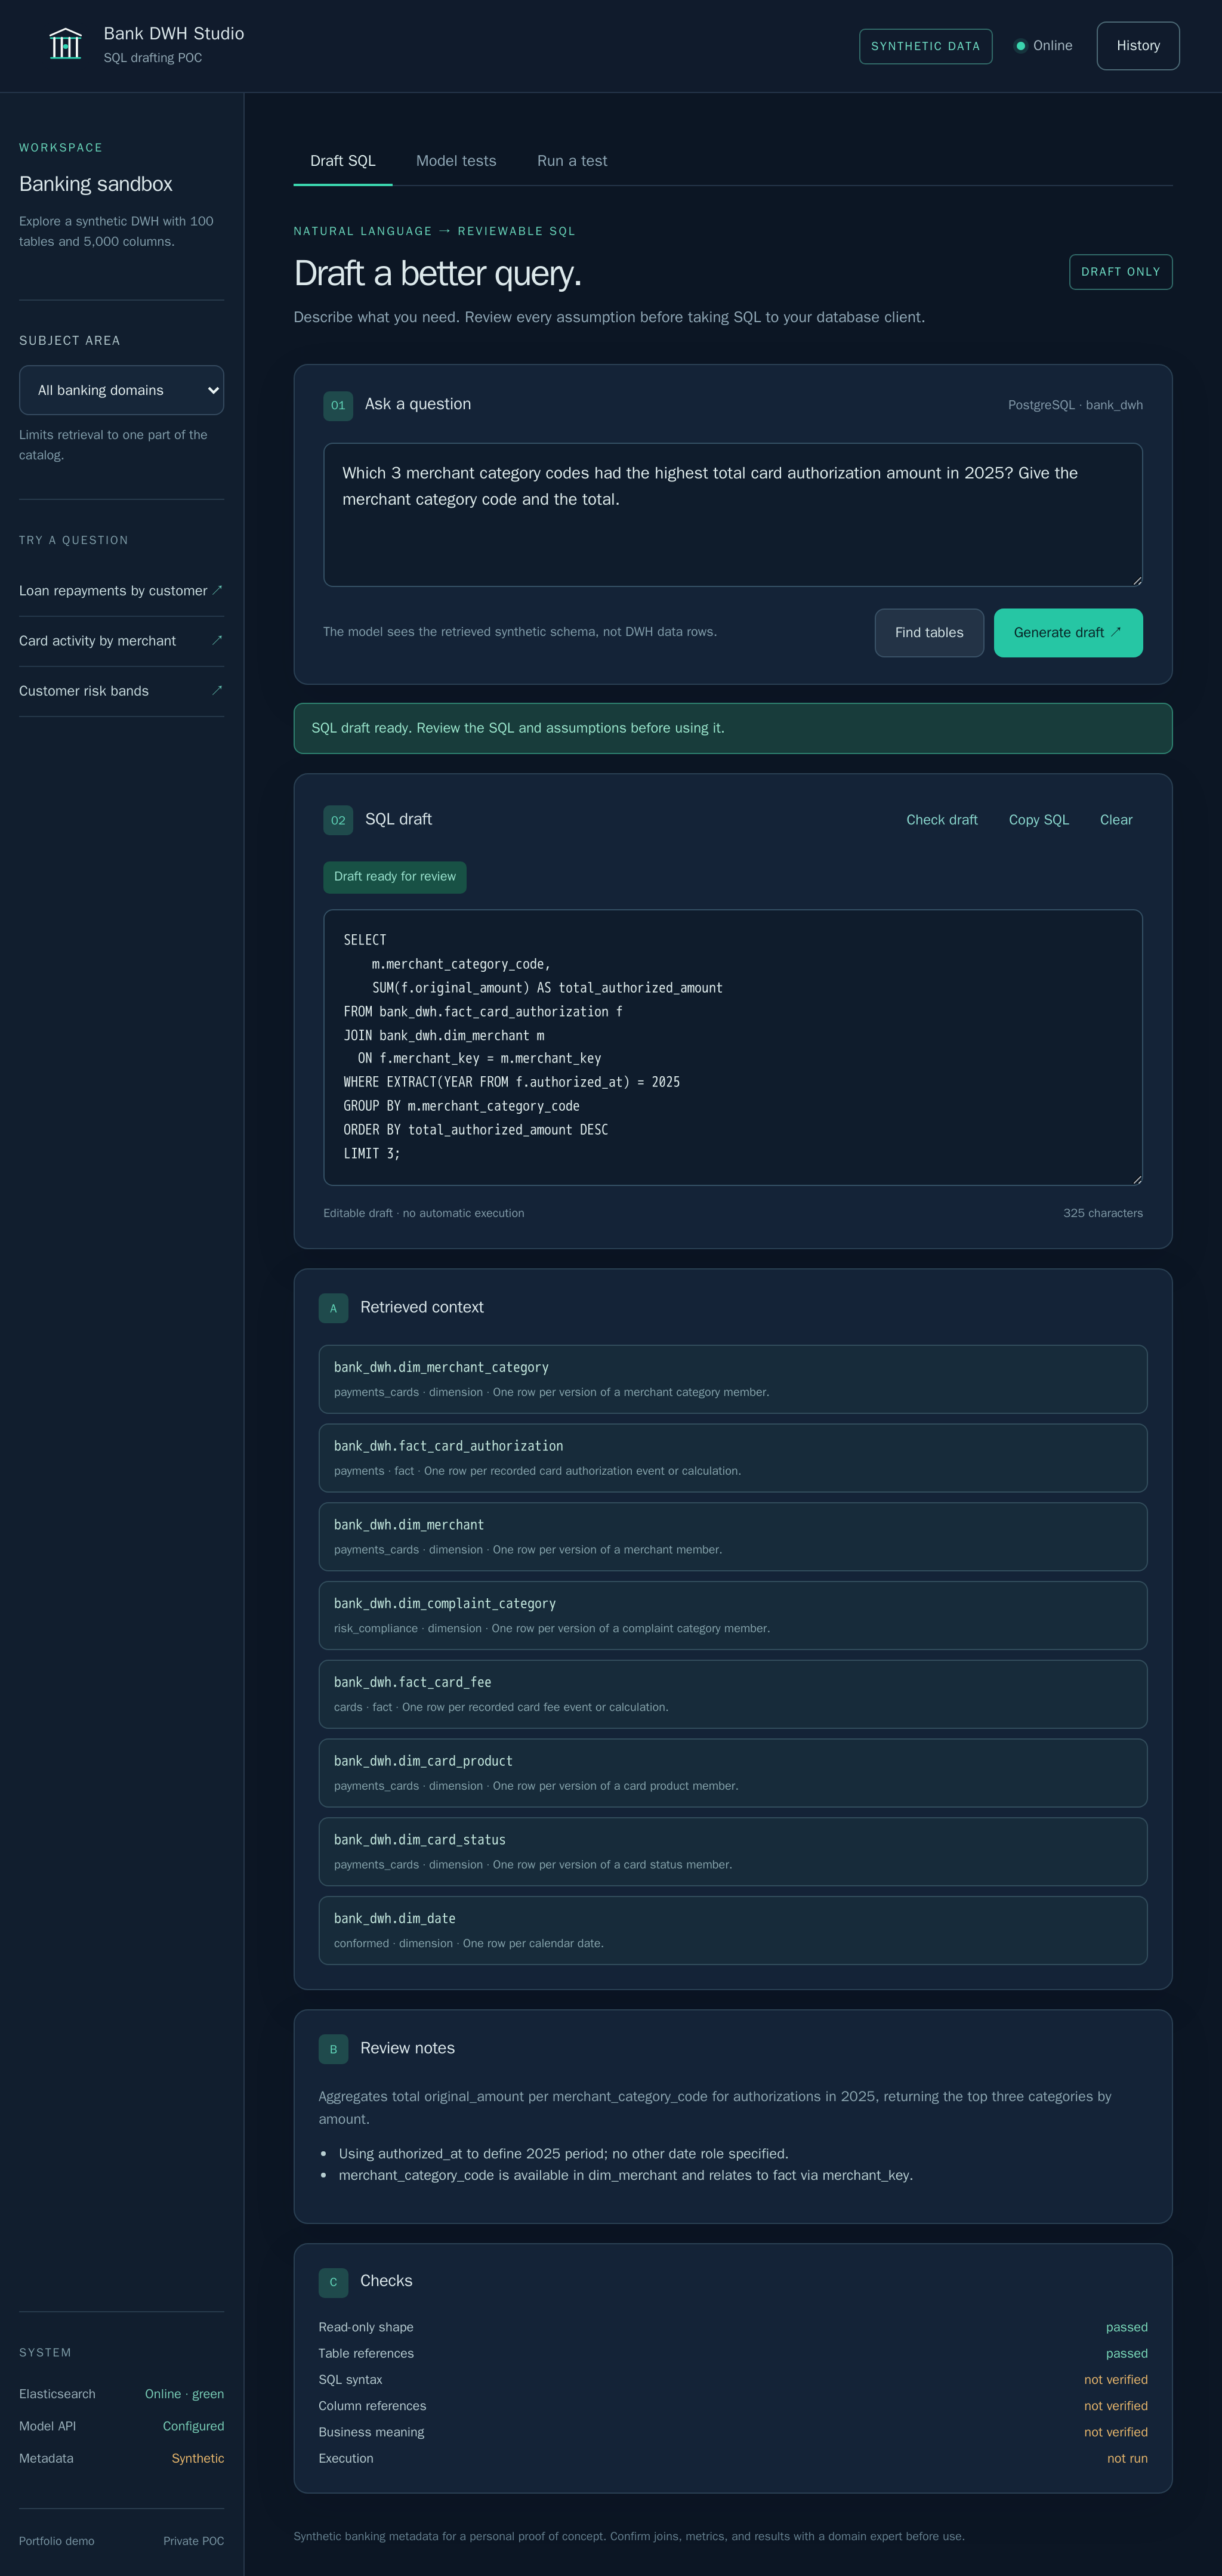
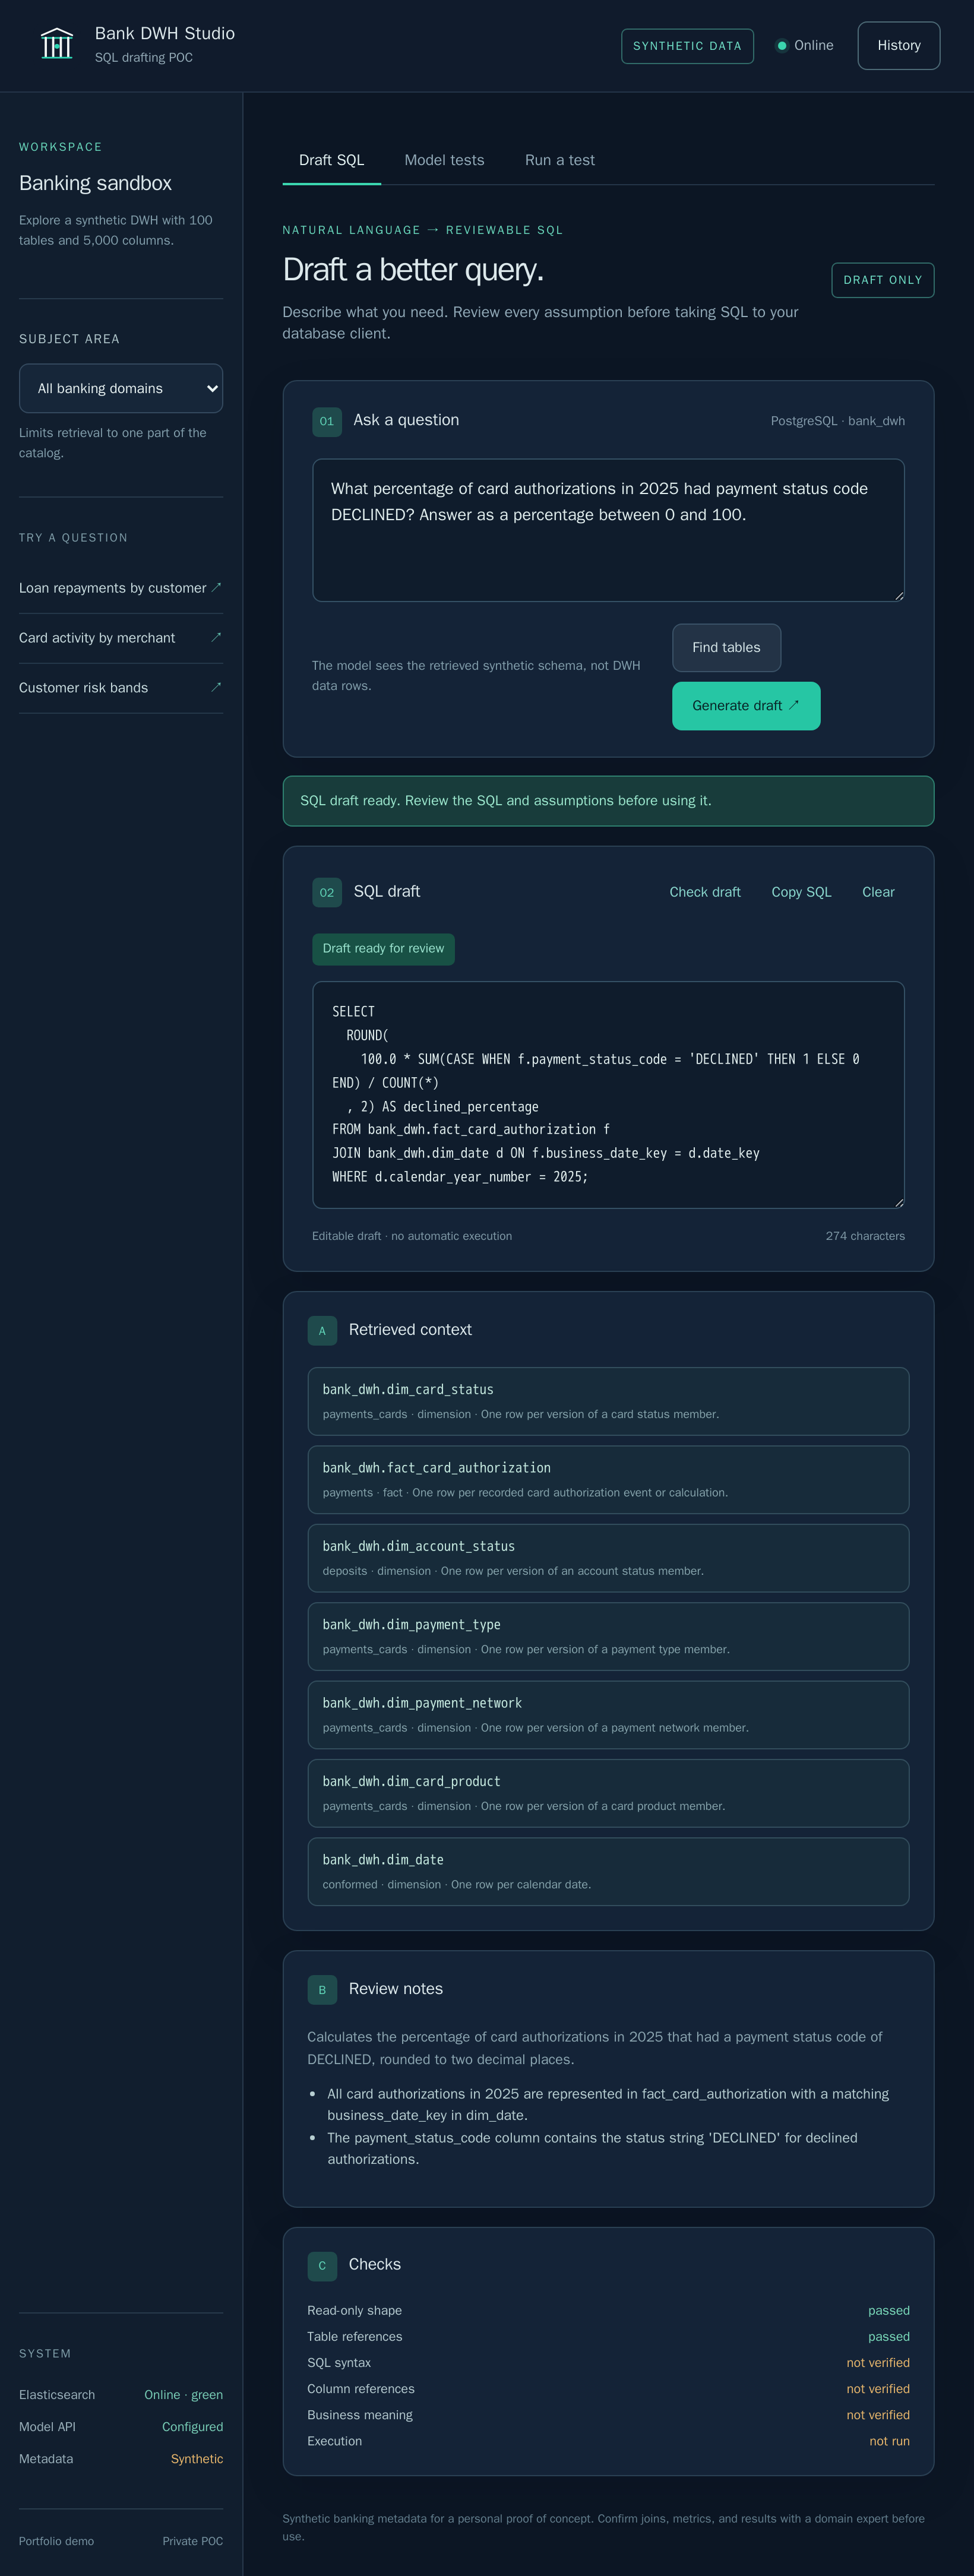
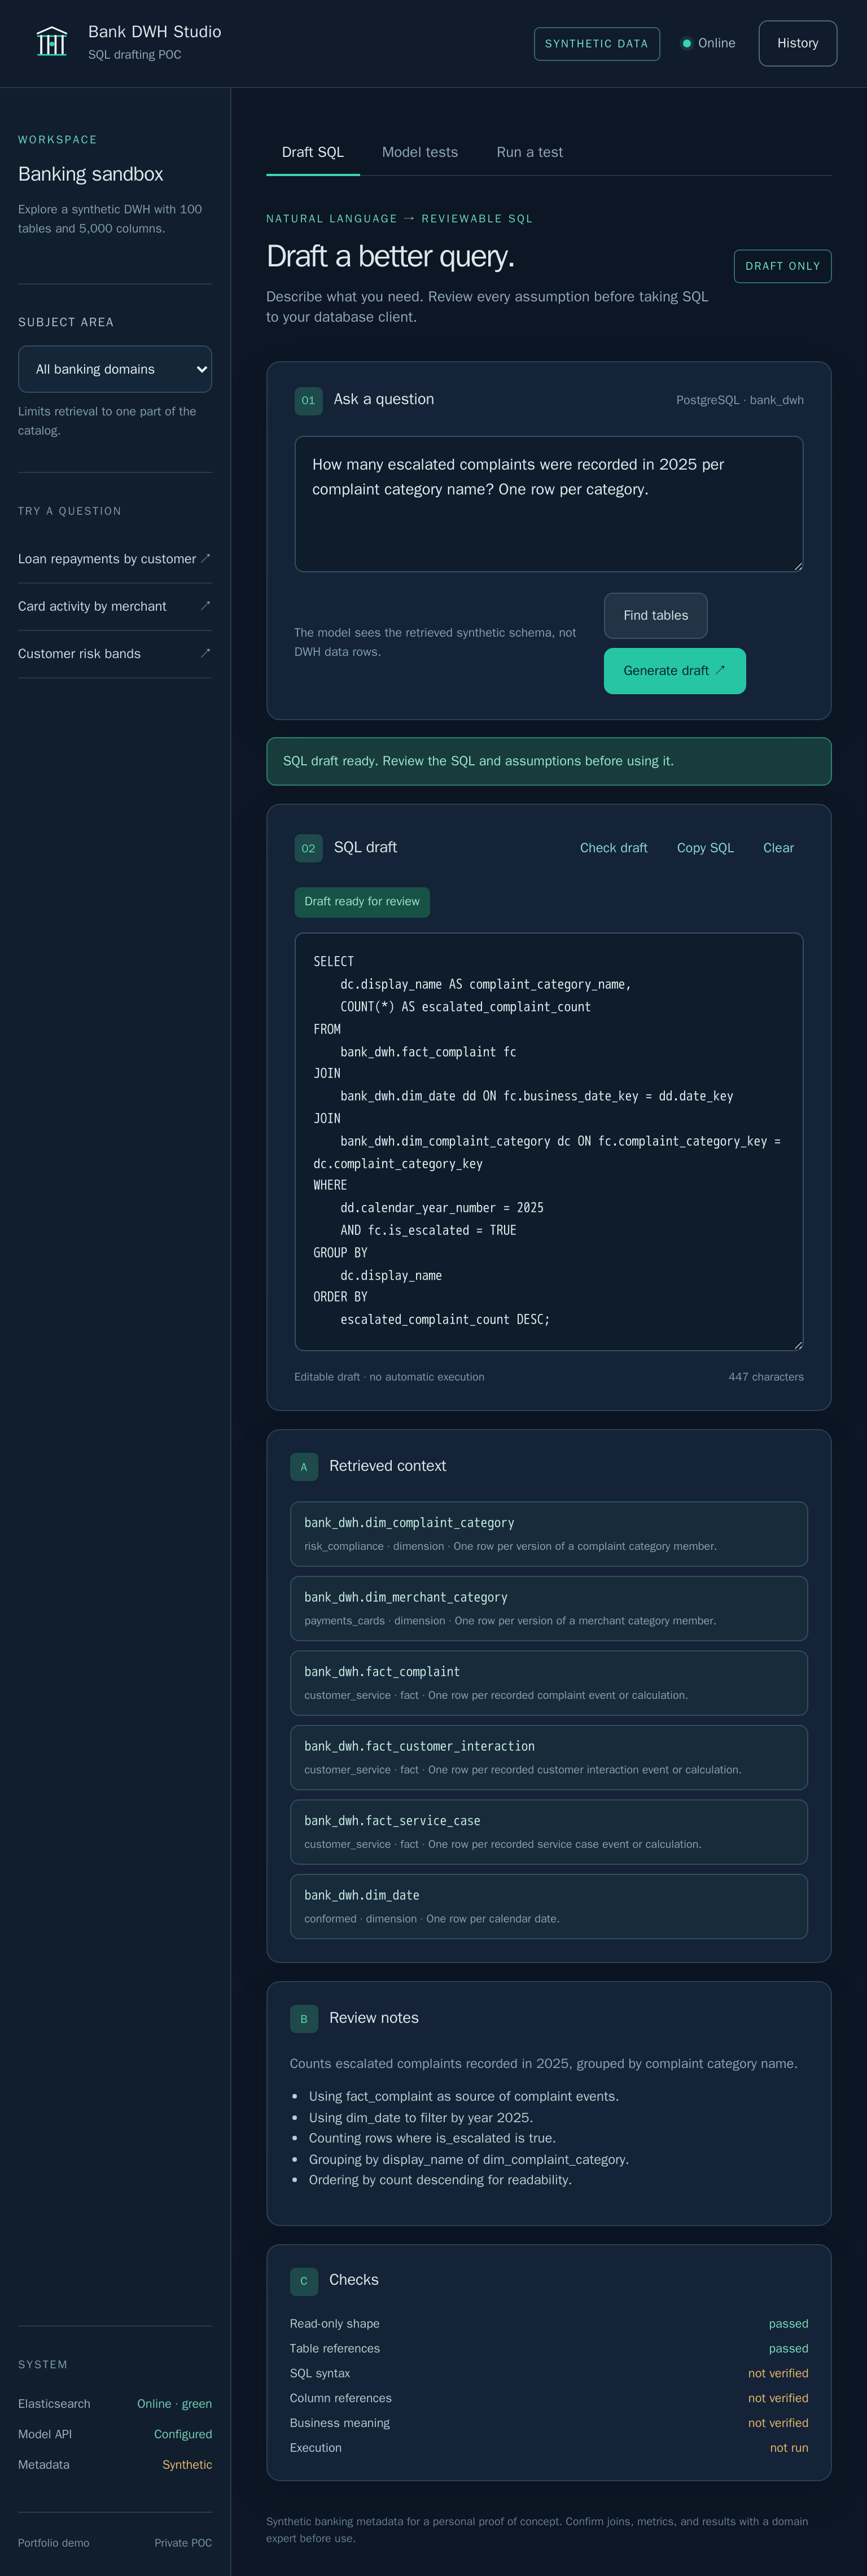
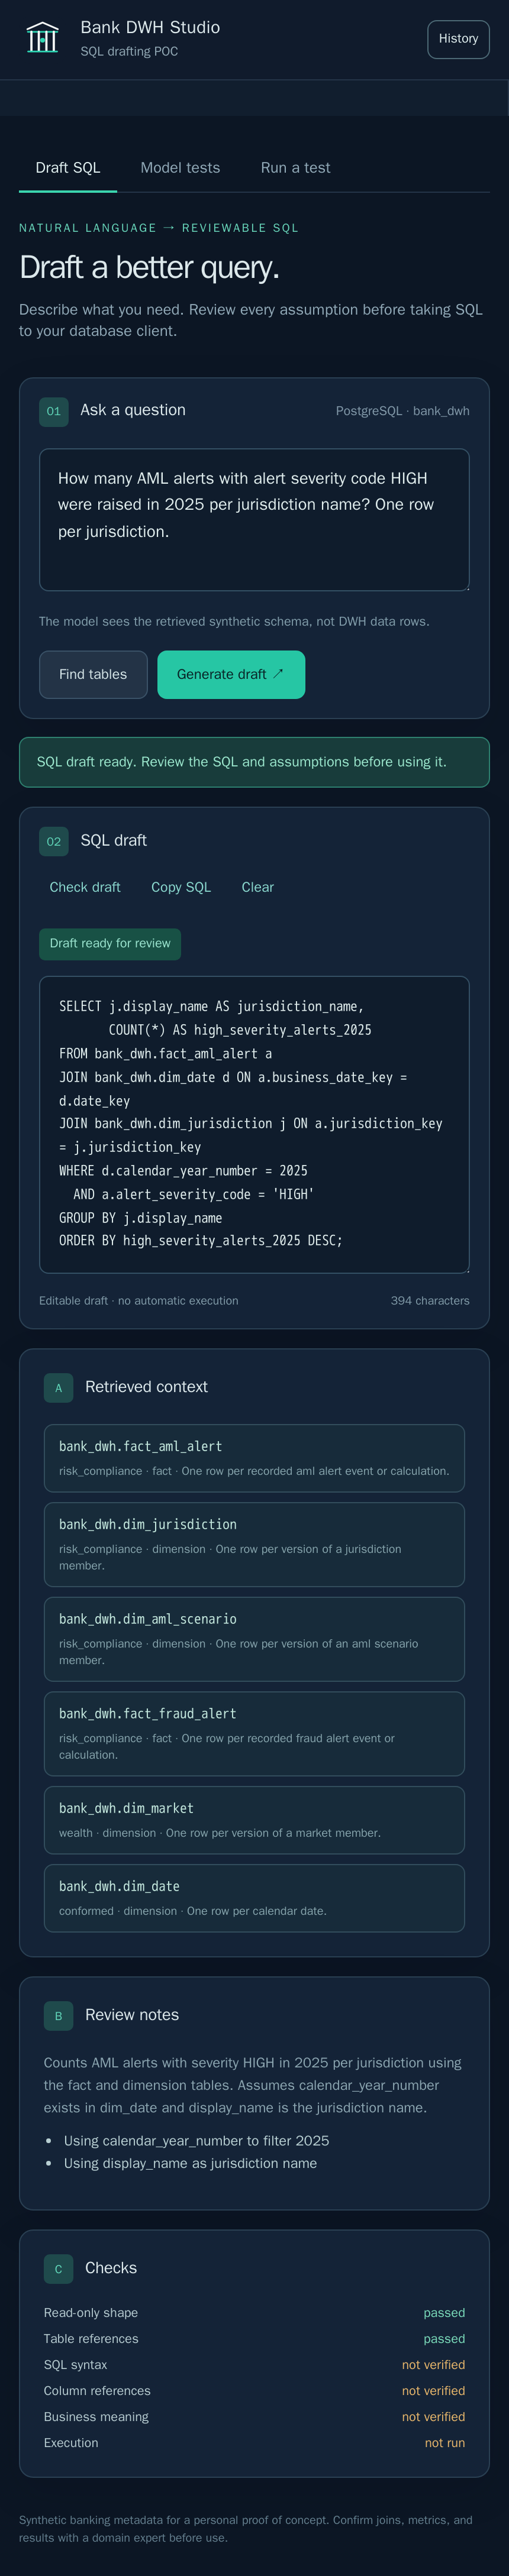
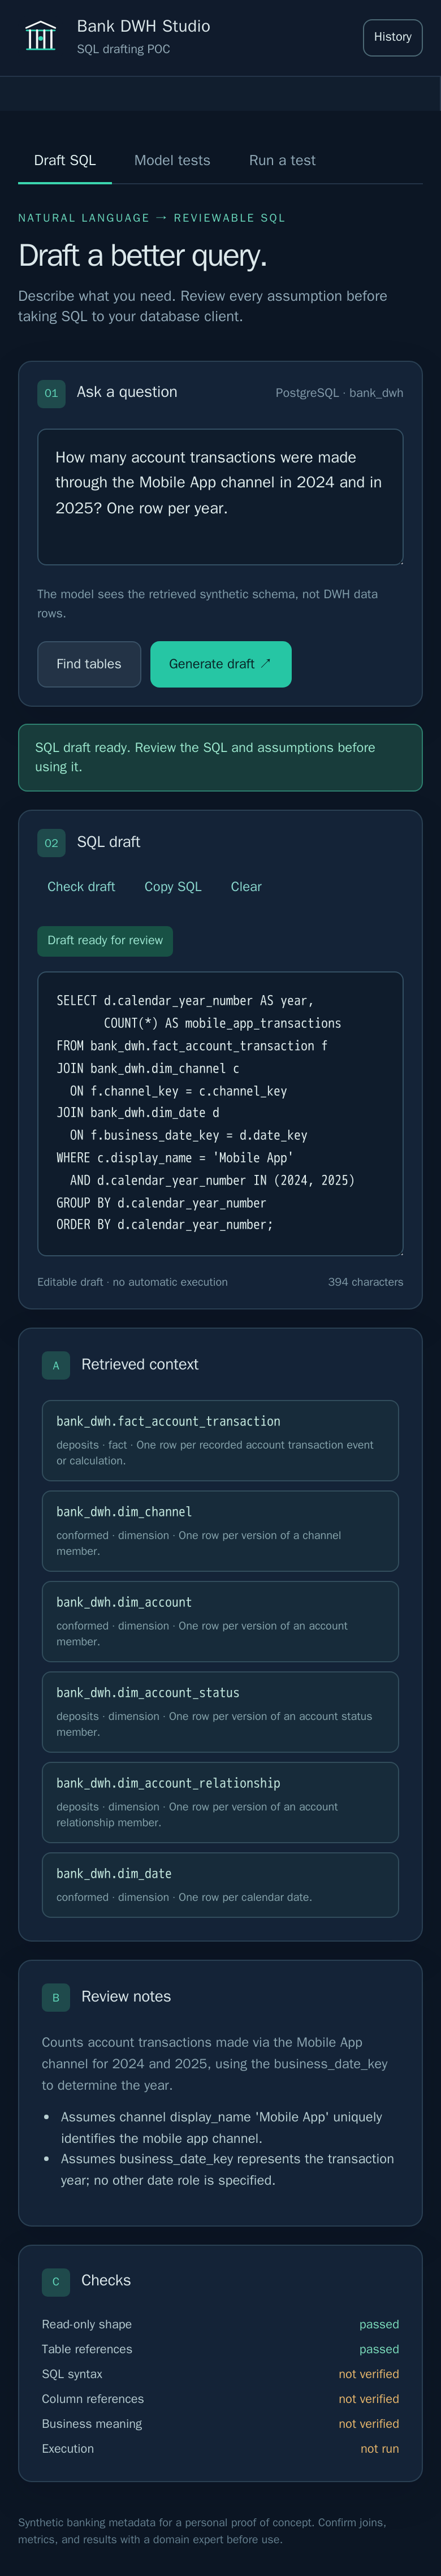
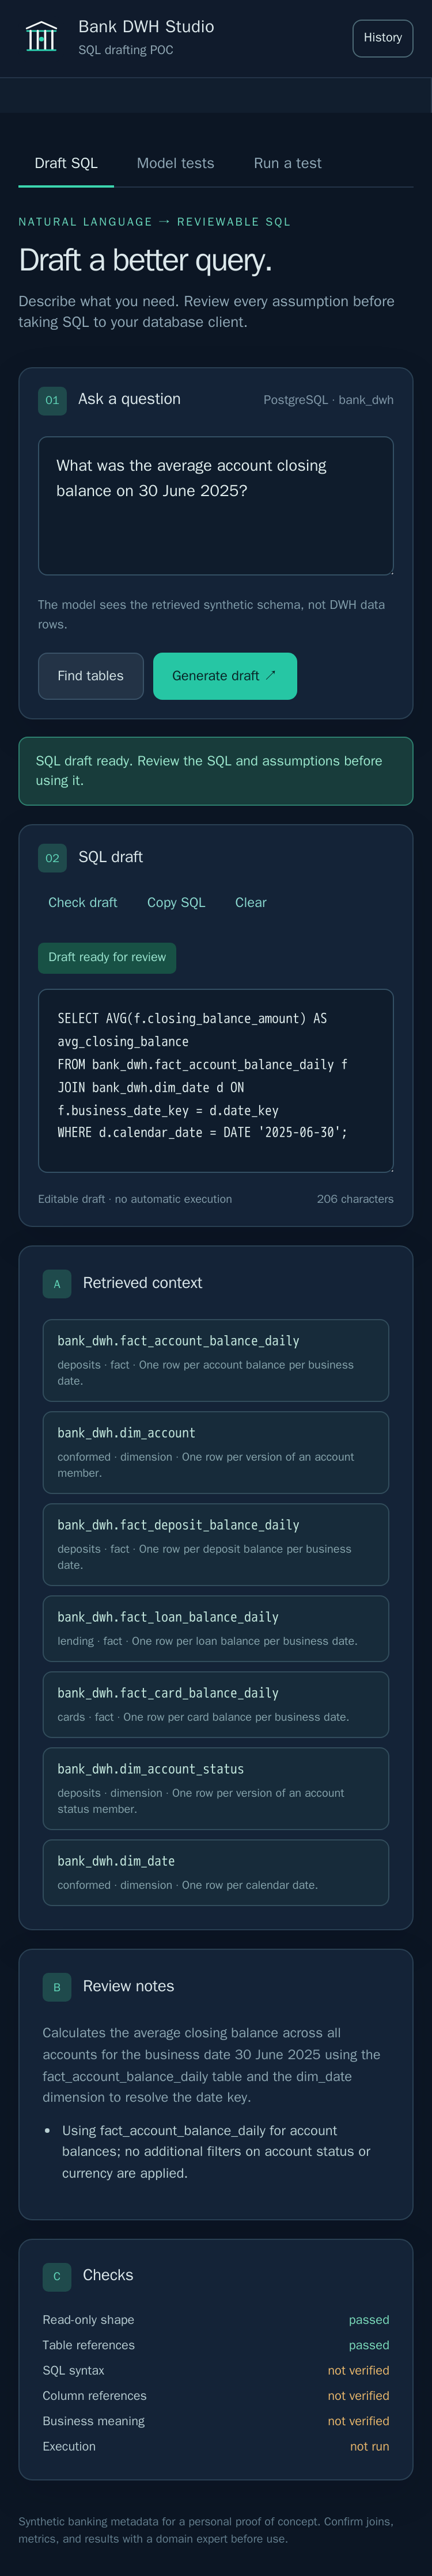
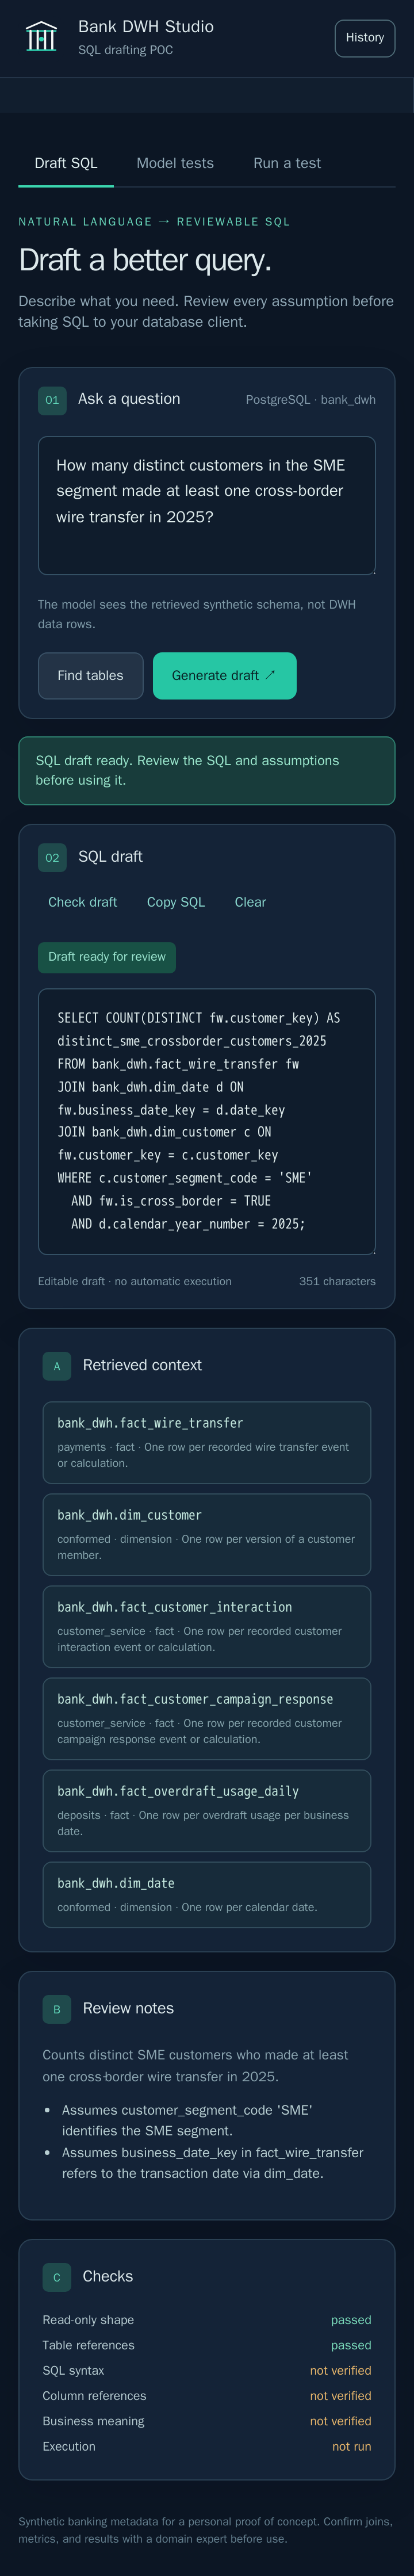
O app escreve e testa rascunhos SQL, mas só em uma cópia sintética do warehouse e como um usuário que só pode ler; ele nunca se conecta a um warehouse bancário real. Os usuários continuam revisando o resultado e depois o editam ou copiam e o executam no próprio cliente de banco de dados. O navegador nunca recebe a chave de API do modelo.
As verificações automáticas cobrem a estrutura de uma instrução somente de leitura e referências a tabelas conhecidas. A sintaxe SQL, as referências de colunas e o significado de negócio ainda exigem revisão humana. Todos os nomes, relacionamentos e indicadores do warehouse são material de teste sintético, não definições bancárias aprovadas.
A prova de conceito implantada roda um backend Node, o Elasticsearch e o warehouse PostgreSQL somente leitura como contêineres sem root em uma instância Oracle Ampere A1, e redige SQL com o gpt-oss-20b por meio de um provedor hospedado. O repositório também documenta uma arquitetura futura mais ampla, claramente separada do POC implantado, que é menor.
Um pequeno console para gerenciar convites e dispositivos em aplicativos web privados.
Uma pequena peça que ajuda aplicativos web a funcionar offline e ficar atualizados.
Desenhe como as coisas fluem. Crie e exporte diagramas no navegador.