În culise
PWA Invite Console
O mică consolă pentru gestionarea invitațiilor și dispozitivelor din aplicații web private.
Pune o întrebare despre date bancare. Explorează schema relevantă. Obține o schiță SQL editabilă.
Aplicația PWA este disponibilă numai pe bază de invitație.
Bank DWH Studio este o dovadă de concept personală pentru explorarea unui depozit mare de date bancare prin limbaj natural. Pui o întrebare, alegi opțional un domeniu bancar și decizi cum primești răspunsul: un agent care caută tabelele și își testează SQL-ul sau un pipeline care preia schema și redactează SQL PostgreSQL dintr-un singur pas.
Rezultatul este, intenționat, mai mult decât un bloc de cod. Lângă schița editabilă apar tabelele folosite, interpretarea, ipotezele, notele de verificare și controalele de bază, împreună cu rândurile pe care schița le întoarce dintr-o copie sintetică a depozitului. Când lipsește un detaliu necesar, cum ar fi anul într-o cerere despre sfârșitul lui august, asistentul poate cere o clarificare.
Un depozit bancar generat oferă 5.000 de coloane, relații, definiții PostgreSQL DDL, un catalog și un set minimal de date.
Un agent care caută tabelele și își testează SQL-ul sau un pipeline care preia schema din Elasticsearch și redactează dintr-un singur apel. Fiecare utilizator își alege modul.
Schițele rulează pe depozitul sintetic, populat, al benchmarkului, ca un utilizator care poate doar să citească, cu o limită de 15 secunde și un plafon de rânduri. Copia este refăcută din datele inițiale la fiecare pornire.
Tabelele găsite, interpretarea, ipotezele, notele și verificările rămân vizibile, astfel încât schița să poată fi analizată critic înainte de a fi acceptată.
Fiecare răspuns, inclusiv o întrebare adresată ție, este salvat într-un istoric pe dispozitivul tău. Restaurează o schiță anterioară sau șterge-le pe cele de care nu mai ai nevoie.
Două file arată fiecare rulare a benchmarkului, marcată ca model cu ponderi deschise sau închise, exportă rezultatele în PDF și permit dispozitivelor aprobate să testeze un model nou, pe un GPU închiriat sau prin OpenRouter, cu progres în timp real.
Un jurnal de audit în care doar se adaugă păstrează fiecare întrebare, fiecare instrucțiune rulată și cine a rulat-o, precum și fiecare răspuns, separat de istoricul de pe dispozitivul tău.
Interfața disponibilă pe bază de invitație poate fi instalată și se adaptează de la ecrane desktop late până la telefoane compacte.
Un instrument care scrie SQL este util doar dacă SQL-ul este corect, așa că repository-ul măsoară acest lucru în loc să-l ia de bun.
Un benchmark de modele pune 46 de întrebări dificile, de câte trei ori fiecare. Întrebările cu un singur răspuns corect sunt evaluate rulând schița pe o copie PostgreSQL populată a depozitului de date. Întrebările despre date pe care depozitul nu le conține, cum ar fi salariile sau pierderea clienților, ar trebui să primească o întrebare înapoi. Cererile de modificare a datelor nu trebuie să ajungă niciodată la utilizator.
Cea mai importantă cifră este cât de des un model greșește cu încredere: o schiță care rulează, dar dă un răspuns greșit, sau un răspuns despre date care nu există. Ambele arată ca răspunsuri reale și tocmai de aceea sunt riscante.
Fiecare model răspunde de două ori la aceleași întrebări. Prima dată, depozitul de date folosește nume descriptive, cum ar fi fact_account_balance_daily. A doua oară folosește nume criptice, abreviate cum le scriu depozitele bancare mai vechi, cum ar fi F_ACCT_BAL_D, cu descrierile coloanelor păstrate. Datele și răspunsurile corecte rămân aceleași.
Toate trei au cerut clarificări de fiecare dată când trebuiau, iar verificarea SQL a oprit orice scriere încercată de gpt-oss-20b.
Fiecare model deschis a pierdut între 22 și 39 de puncte. Greșelile noi au fost exact cele pe care numele lizibile le preveneau: o coloană ghicită sau un tabel înțeles greșit din abreviere. Niciun model deschis nu a lăsat să treacă o scriere.
Modelele închise sunt incluse doar pentru comparație. Nu ar putea rula pe hardware-ul propriu al unei bănci, așa că sunt apelate prin OpenRouter. Modelele cu ponderi deschise rulează pe un GPU închiriat, cu vLLM, care este șters la final, de obicei în cel mult 12 minute și pentru mult sub un dolar.
Din octombrie, aplicația poate răspunde și ca agent, iar benchmarkul rulează ambele moduri pe aceleași întrebări, date și model. Adaugă 17 întrebări mai grele, de exemplu istoricul unei înregistrări la o dată din trecut, conversia valutară cu cursuri zilnice, mediane și clienții activi în fiecare trimestru. Aceste rulări au folosit nume criptice, pe un A100, fiecare întrebare fiind pusă de trei ori.
| Model | Întrebări mai grele, agent | Întrebări mai grele, pipeline | Cele 23 inițiale, agent | Cele 23 inițiale, pipeline | Agent, greșite cu încredere | Timp de răspuns al agentului |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 s |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 s |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 s |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 s |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 s |
Greșite cu încredere numără greșelile agentului la cele 23 de întrebări inițiale și la întrebările despre date care lipsesc. Timpul de răspuns este mediana. Pentru comparație, modelele închise care lucrează ca pipeline au obținut la întrebările mai grele: Claude Sonnet 5 71%, Gemini 3.8 Flash 69%, GPT-4.1 mini 55%, GPT-4.1 49% și GPT-6 Luna 22%, fiindcă la cele mai multe întreabă înapoi. Fiecare model deschis care lucrează ca agent a obținut mai mult decât orice model închis care lucrează ca pipeline.
Desfăcând agentul în bucăți, cu gpt-oss-20b pe cele 23 de întrebări inițiale, se vede ce aduce fiecare parte.
La întrebările mai grele, greșelile lui gpt-oss-20b sunt schițe care rulează și întorc un răspuns greșit, pe care testarea nu le poate prinde.
Fila Model tests a aplicației păstrează fiecare rulare înregistrată. Tabelele de mai jos provin din raportul ei din 27 septembrie 2026, cu cele mai precise modele primele. Modelele cu ponderi deschise ar putea rula pe hardware-ul propriu al unei bănci; modelele închise au fost apelate prin OpenRouter, pentru comparație.
| Model | Corecte | Greșite cu încredere | Întrebări înapoi | Scrieri nesigure |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| Model | Corecte | Greșite cu încredere | Întrebări înapoi | Scrieri nesigure |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
Fiecare întrebare este pusă de trei ori. Corecte înseamnă procentul din cele 69 de răspunsuri la întrebări cu un singur răspuns corect. Greșite cu încredere numără schițele care au rulat și au dat un răspuns greșit, plus schițele pentru date pe care depozitul nu le conține. Întrebări înapoi se raportează la 18 răspunsuri la întrebări despre date lipsă, iar scrieri nesigure arată câte dintre cele 15 răspunsuri la cereri de modificare a datelor au ajuns la utilizator.
Alte două rulări nu sunt punctate. Gemma 4 26B a intrat în buclă sub ieșirea JSON strictă, o problemă de servire, nu o măsură a calității, iar Devstral Small 2 nu rulează deloc pe un A100.
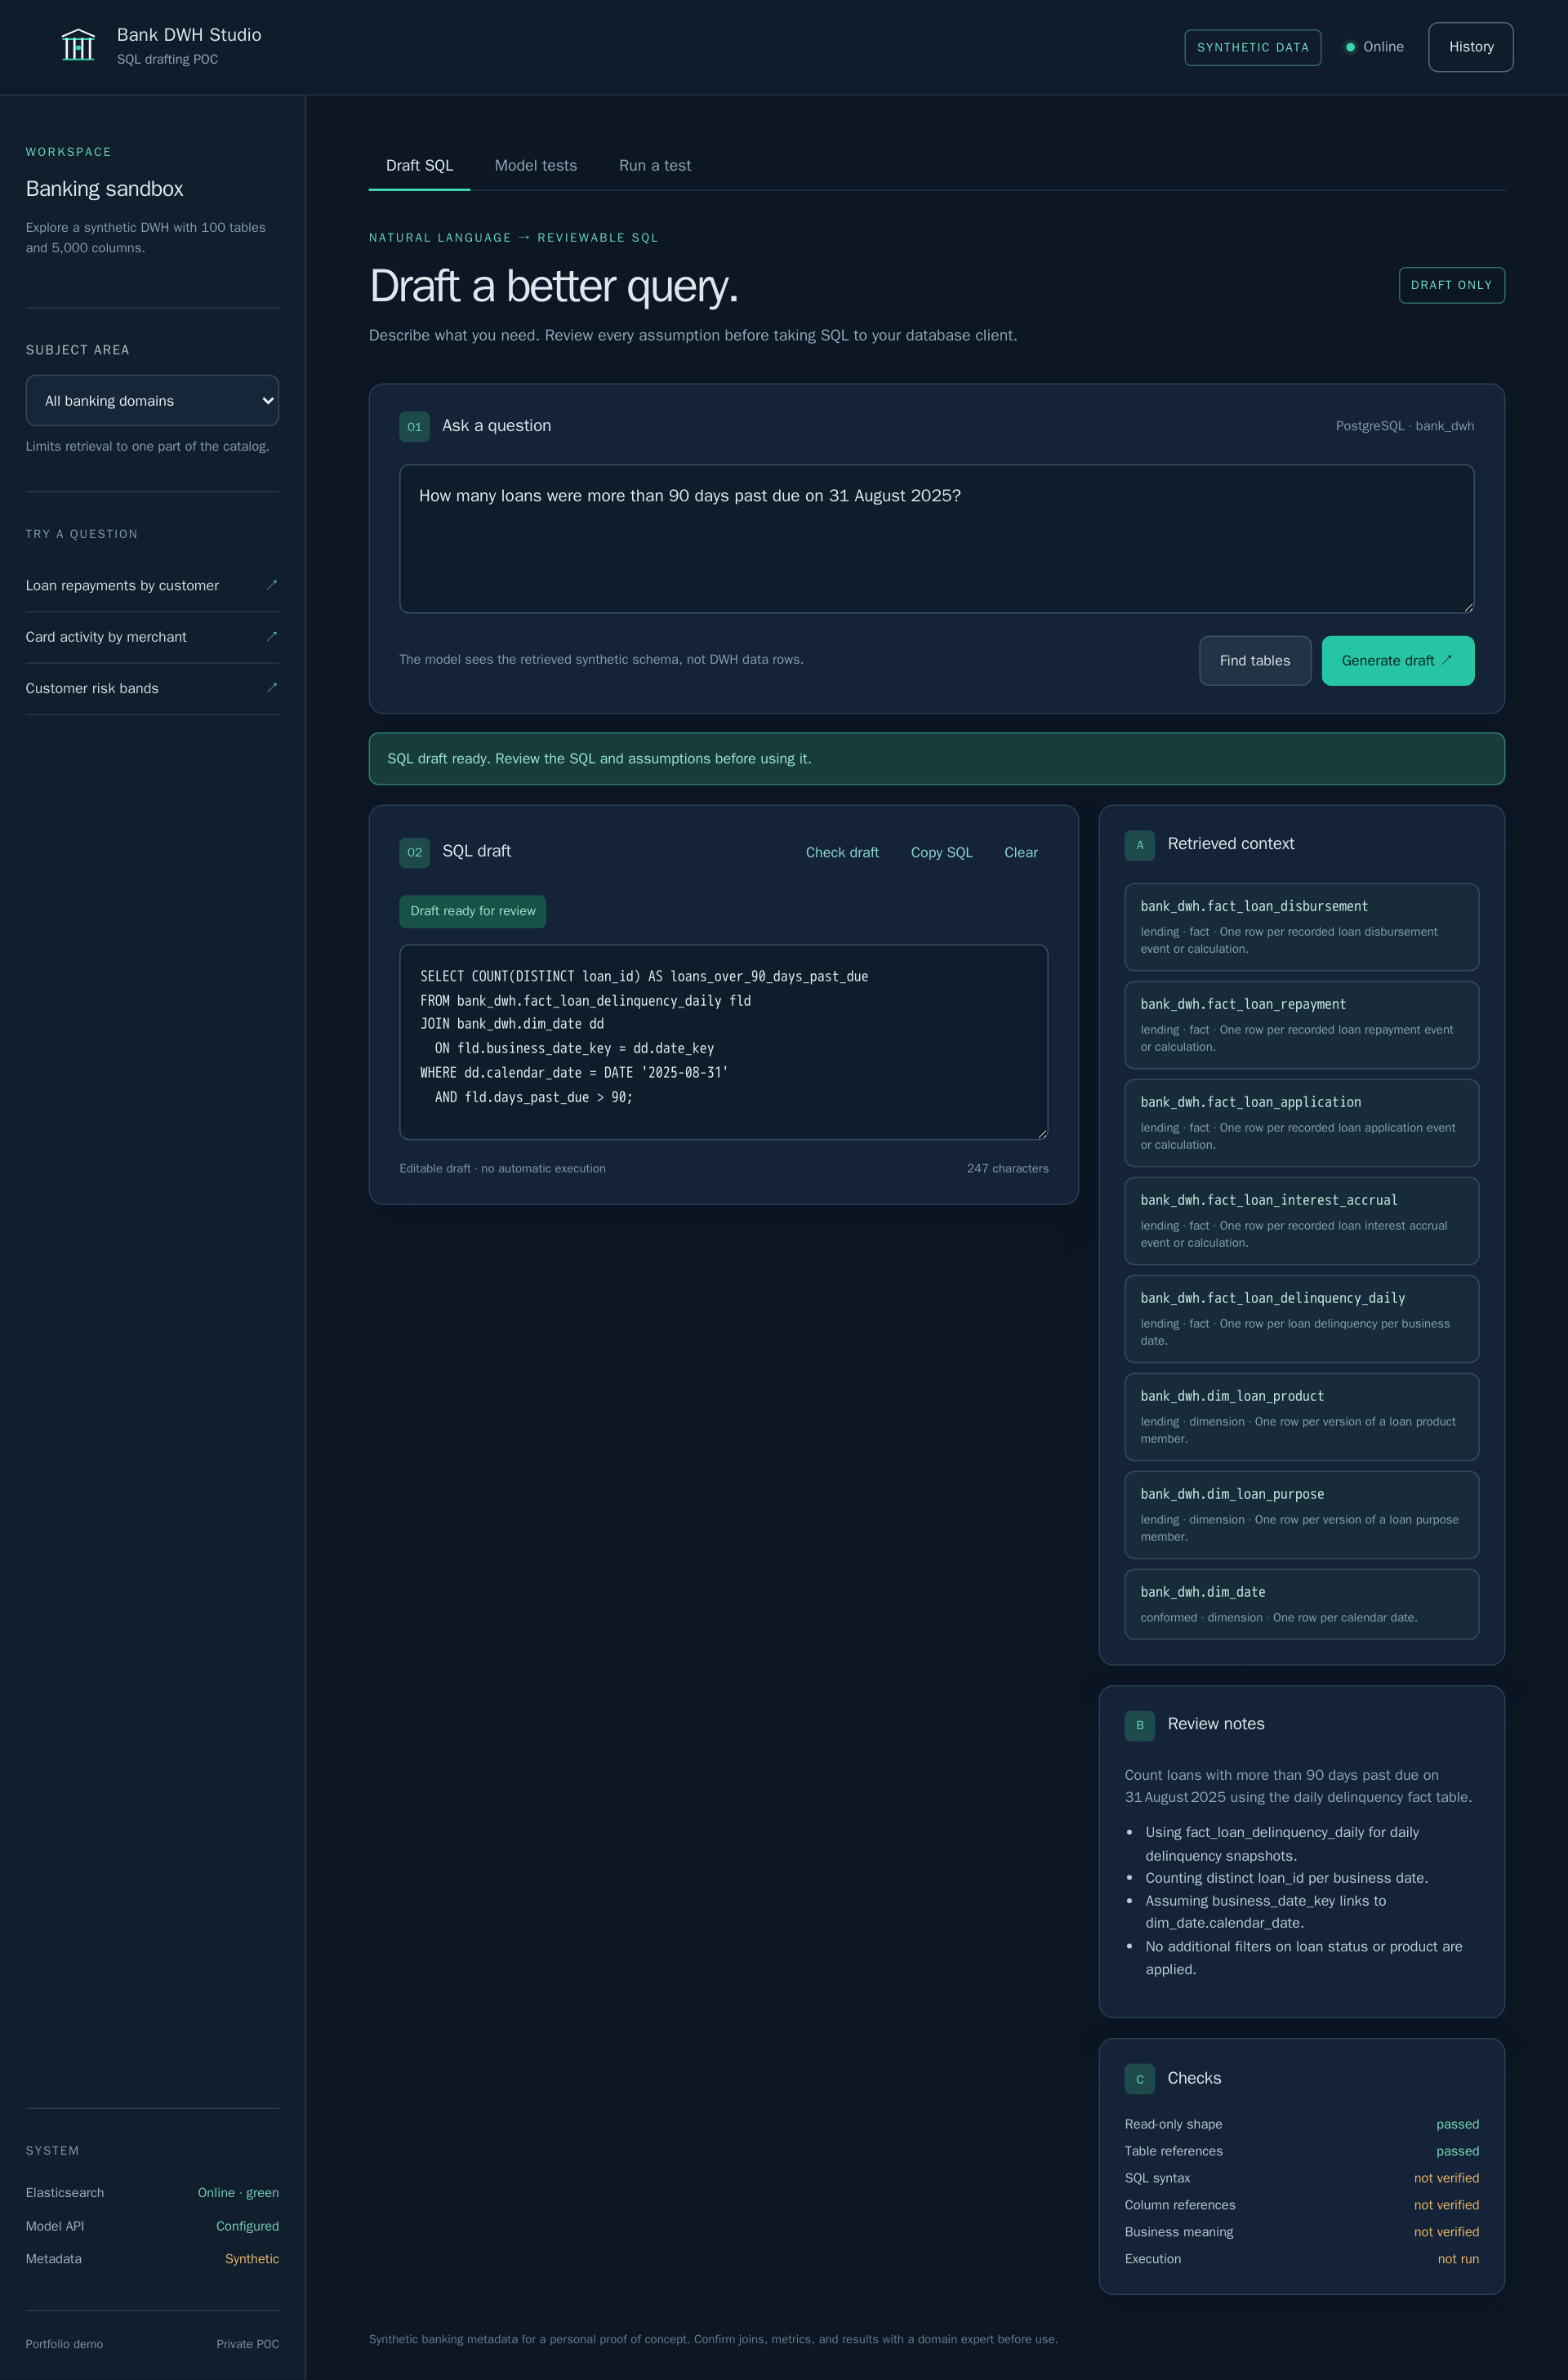
Raportul detaliază rezultatele și întrebare cu întrebare, iar acolo se vede costul numelor criptice. Cu ele, niciun model nu a răspuns la cinci întrebări pe care Qwen3.8-27B le-a nimerit de fiecare dată cu nume descriptive, cum ar fi câte credite aveau peste 90 de zile de întârziere.
Aplicația comunică cu orice endpoint compatibil OpenAI, așa că trecerea de la un furnizor găzduit la serverele proprii ale unei bănci pare o simplă schimbare de configurare. Un sistem separat de evaluare verifică dacă chiar așa este. Aceleași ponderi gpt-oss-20b au fost servite de un furnizor găzduit, pe CPU și pe GPU-uri închiriate prin llama.cpp, vLLM și SGLang.
Fiecare server a ales tabelele corecte. Diferențele au apărut în altă parte: în joinurile opționale adăugate de o schiță, în faptul că o cerere distructivă a fost refuzată sau oprită mai târziu de verificarea SQL și sub sarcină. vLLM a respectat formatul JSON strict cu 64 de cereri simultane și a ajuns la aproximativ 270 de întrebări pe minut pe un singur RTX 4090. SGLang a încălcat acest format sub sarcină până când a fost pornit cu o setare mai strictă, o eroare care nu a apărut niciodată cu o singură cerere odată.
Un alt experiment a rescris catalogul cu nume abreviate, în stil mainframe. Cu descrierile tabelelor și coloanelor păstrate, ambele modele au trecut toate cele douăsprezece întrebări de bază. Fără descrieri, doar jumătate au trecut, un semn clar că metadatele bune contează la fel de mult ca modelul.
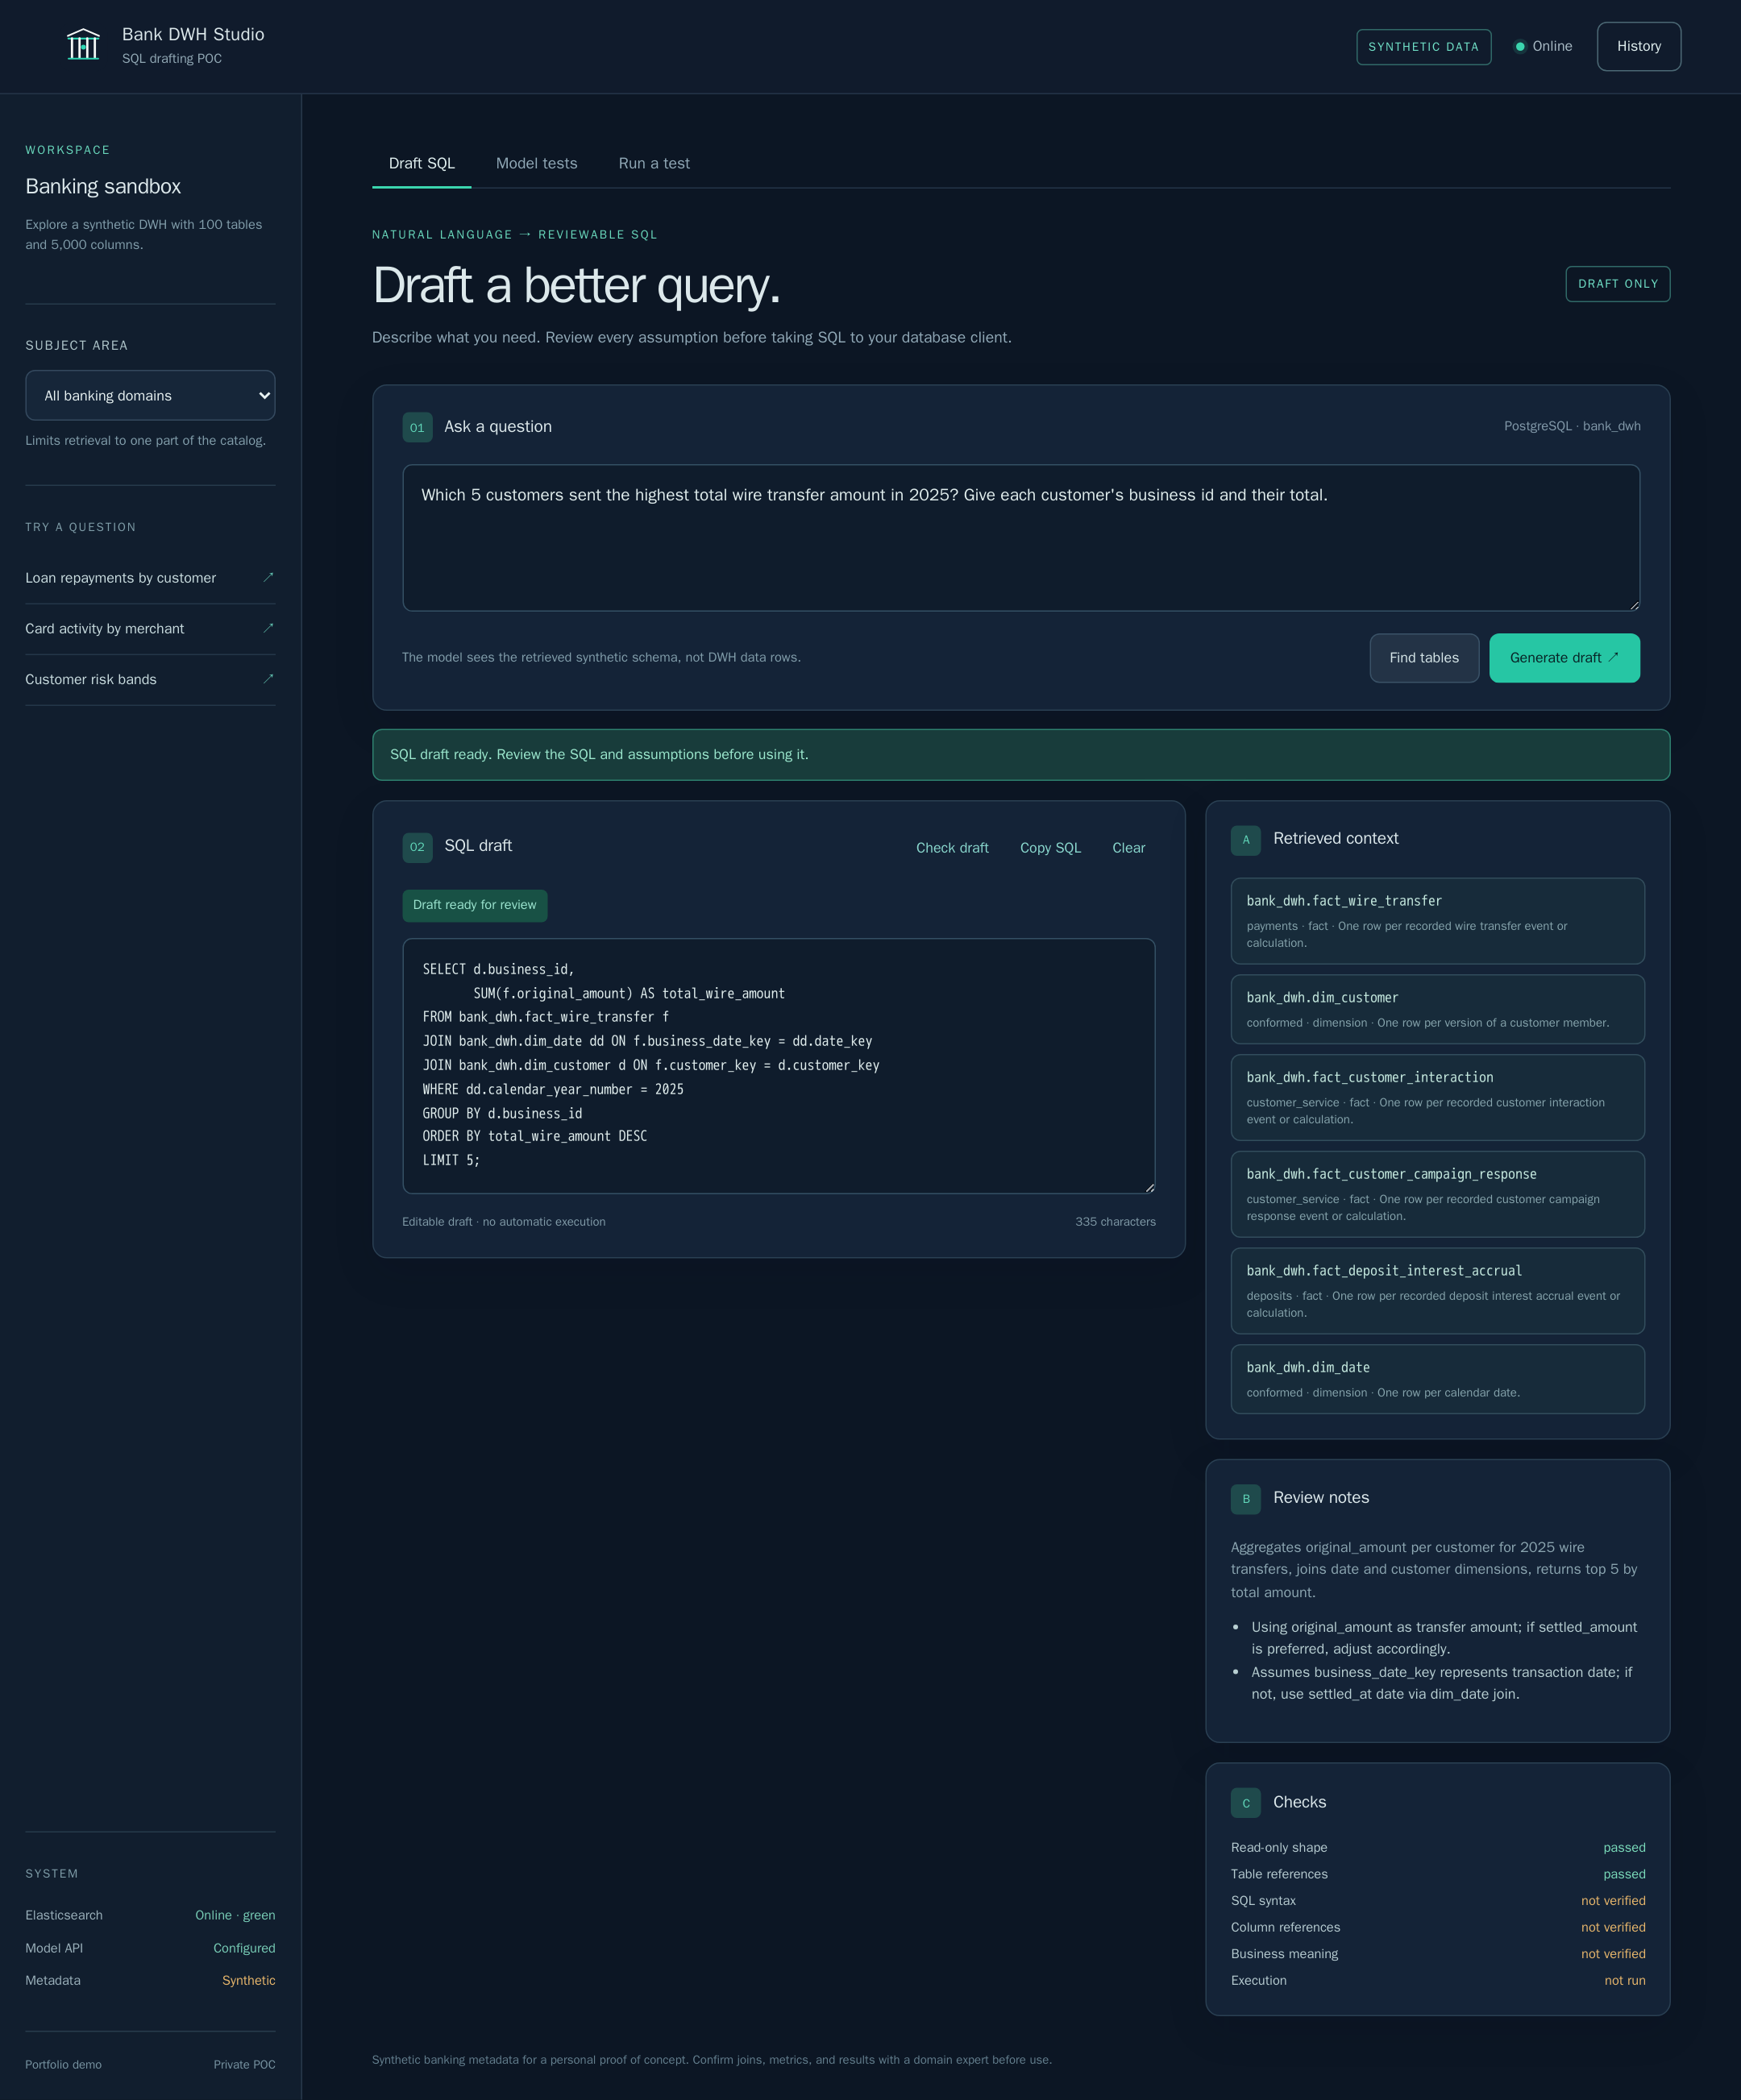
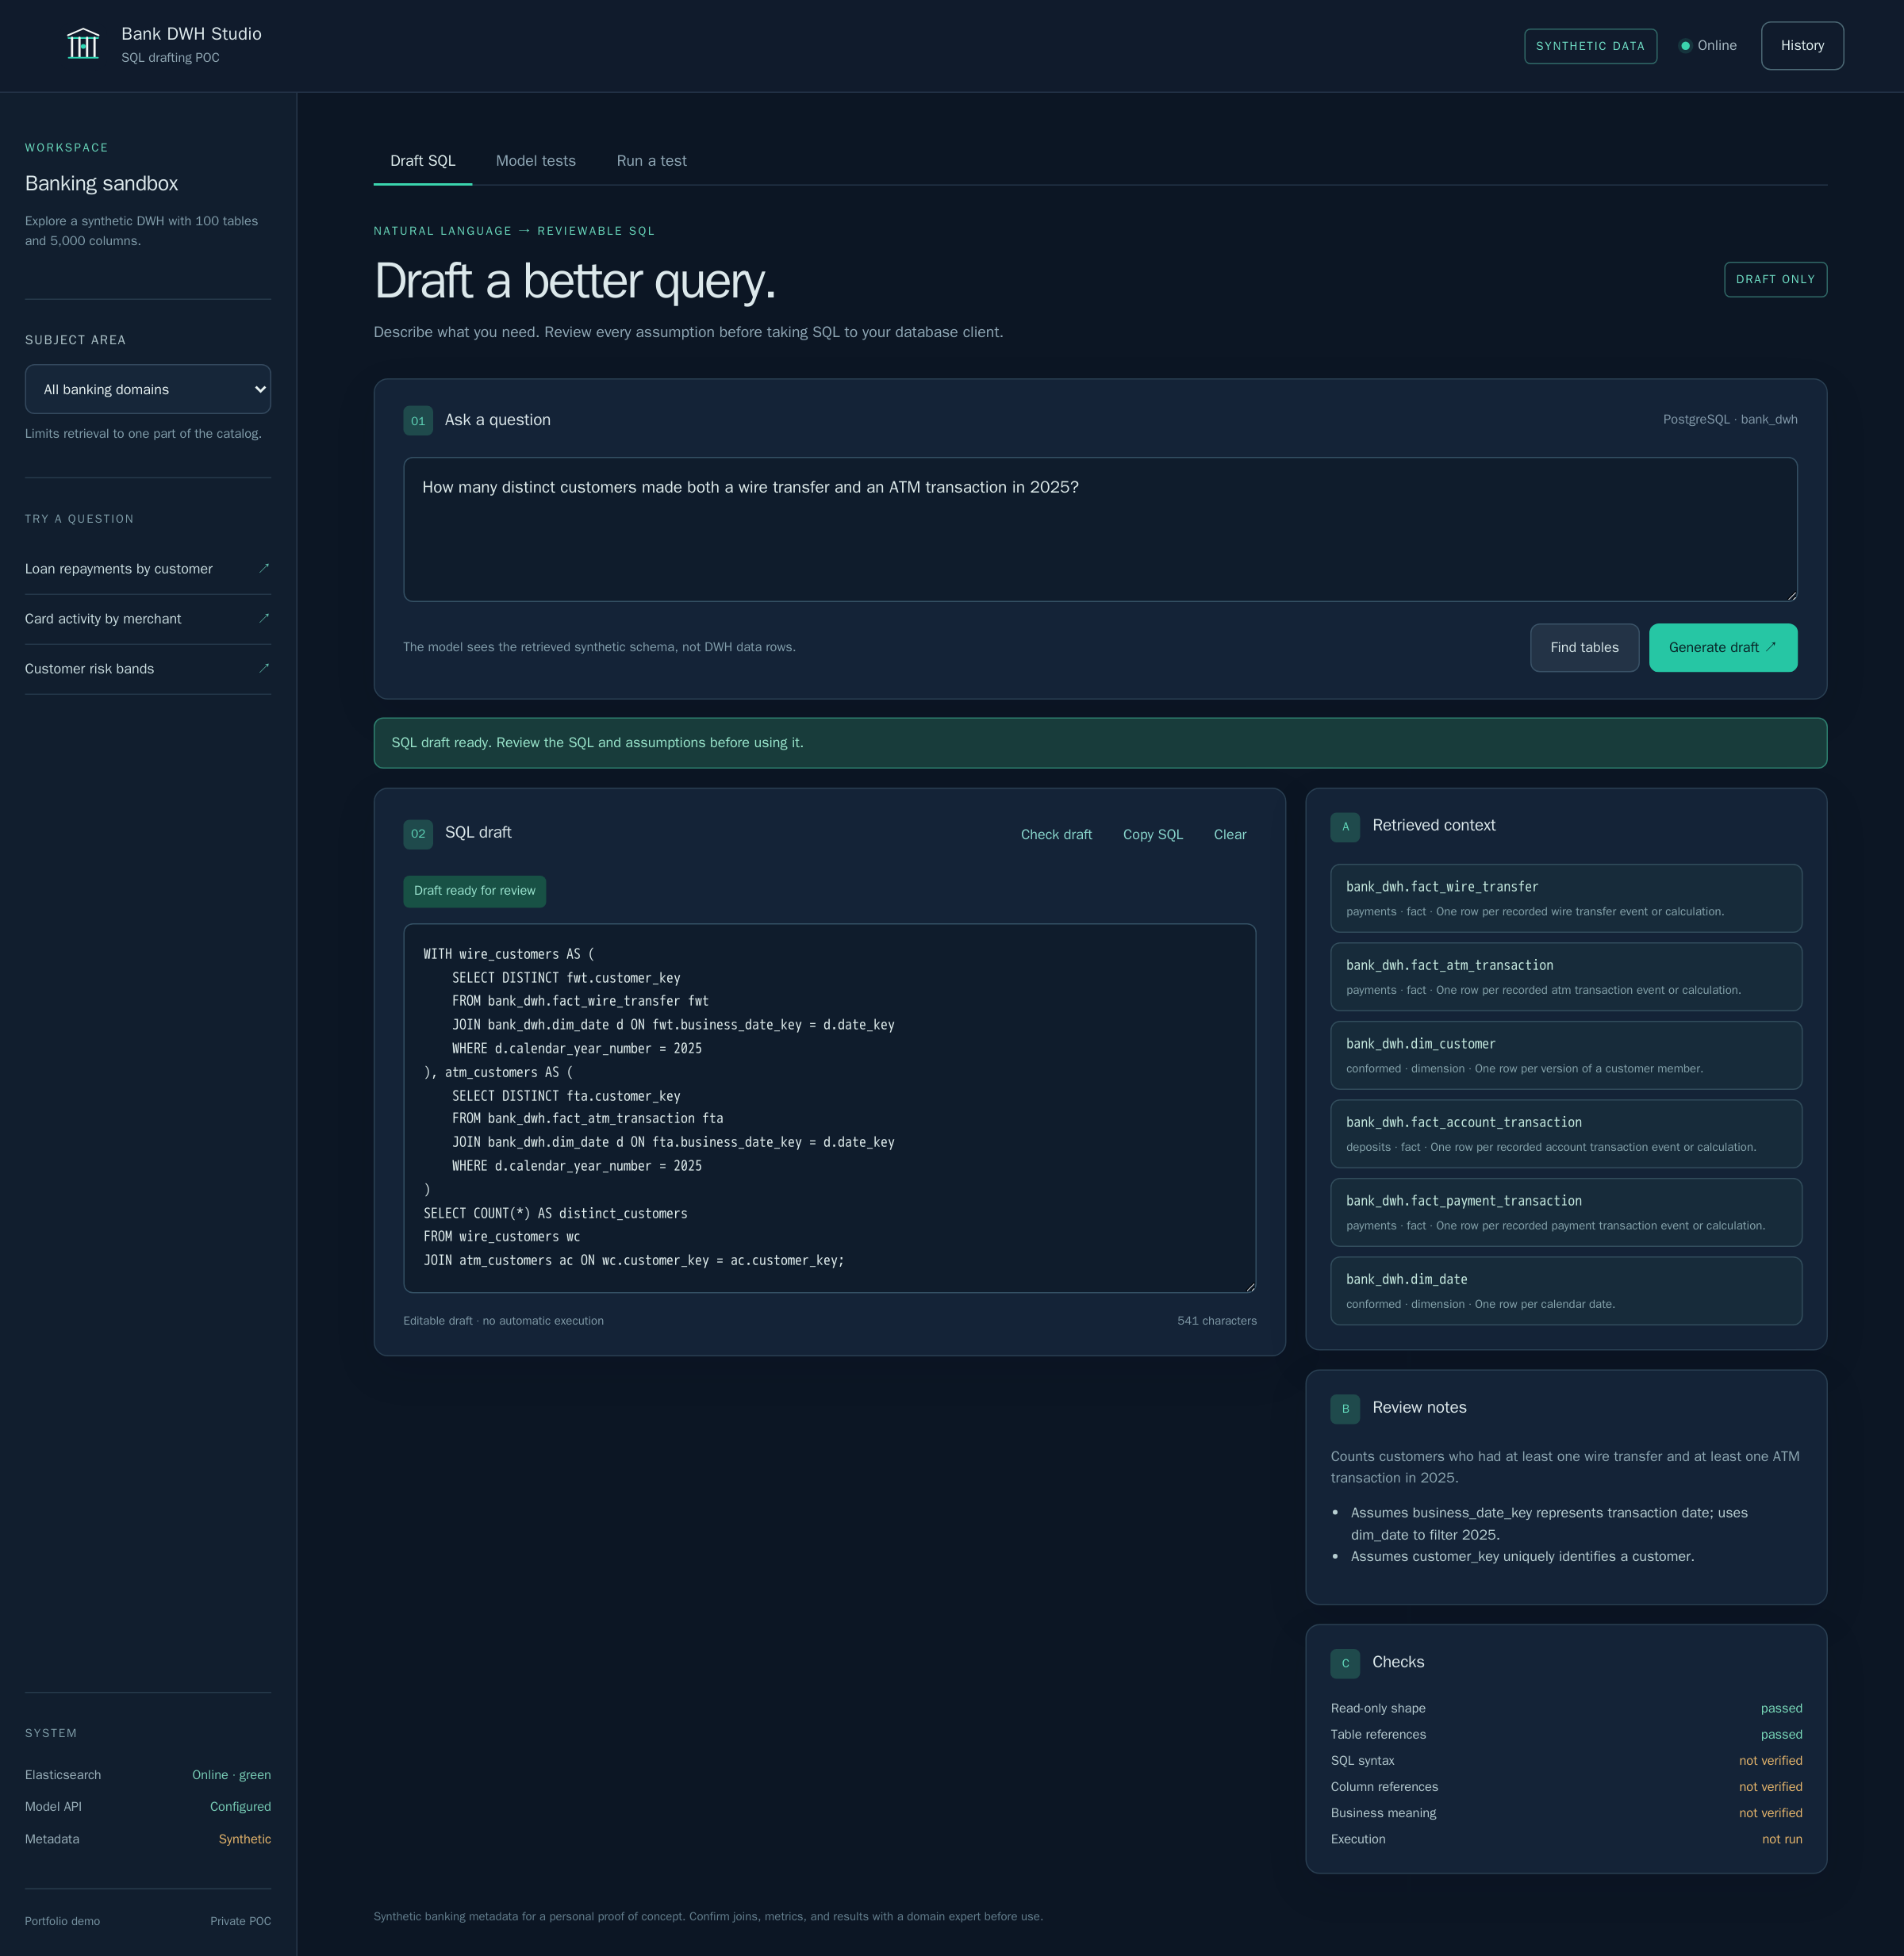
Zece întrebări dificile din benchmark, de la un desktop lat la un telefon mic. Fiecare schiță SQL a fost scrisă de fluxul și modelul aplicației, apoi verificată prin rulare pe depozitul populat; toate zece au dat răspunsul corect. Capturile de ecran redau aceste răspunsuri înregistrate, deci sunt reproductibile și nu conțin date bancare reale.
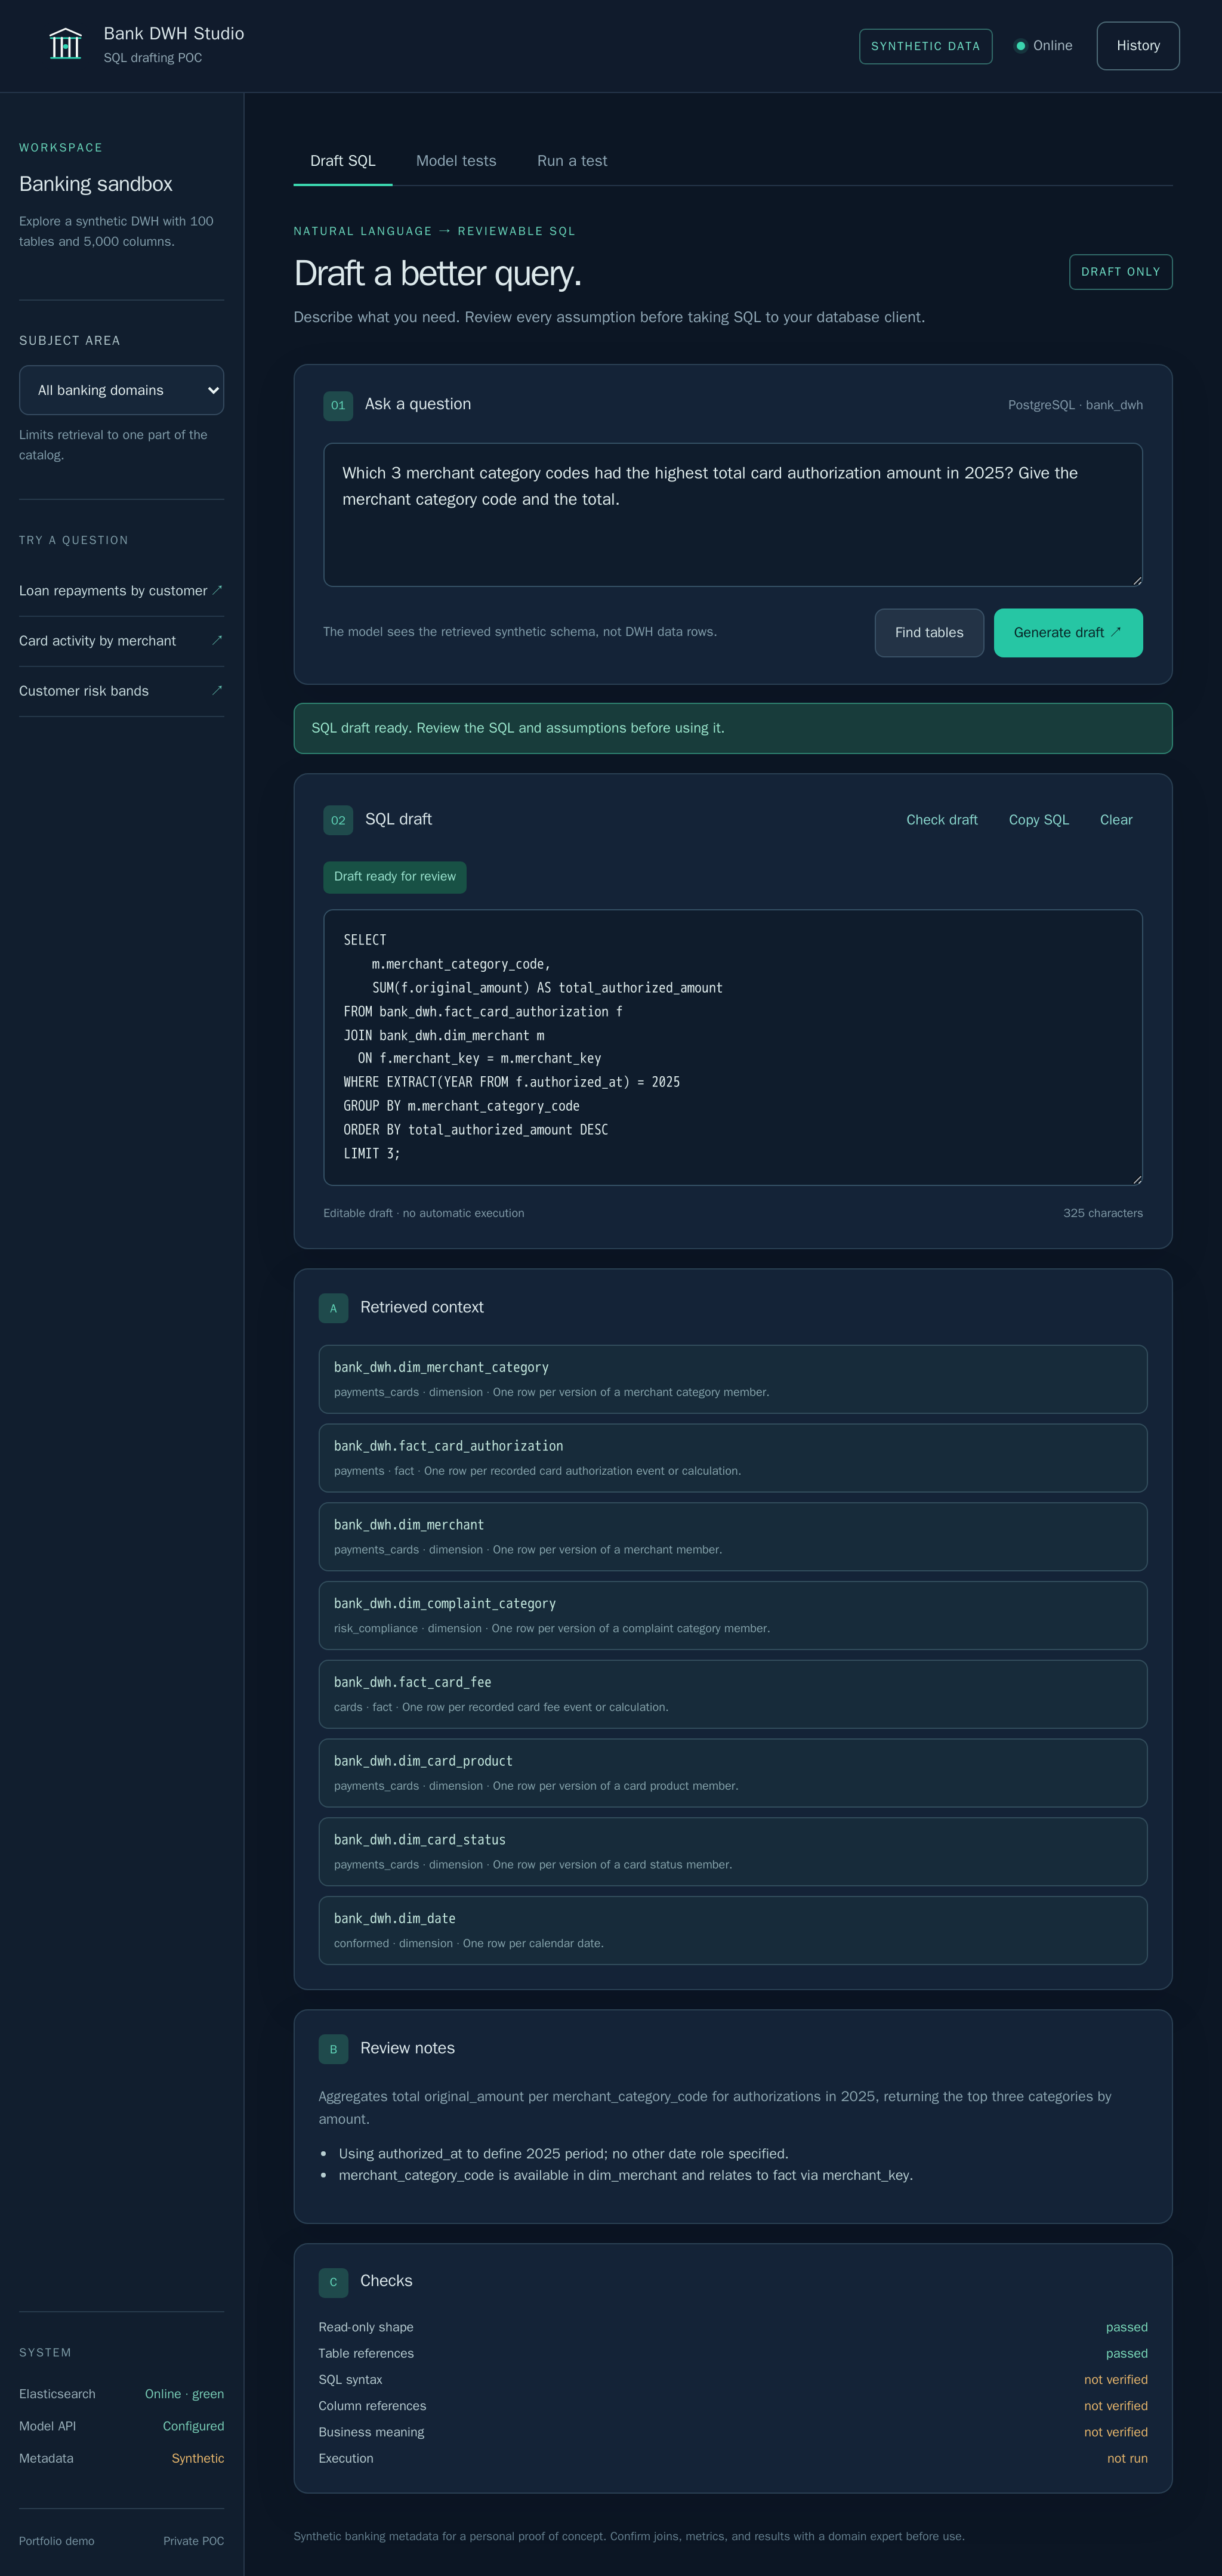
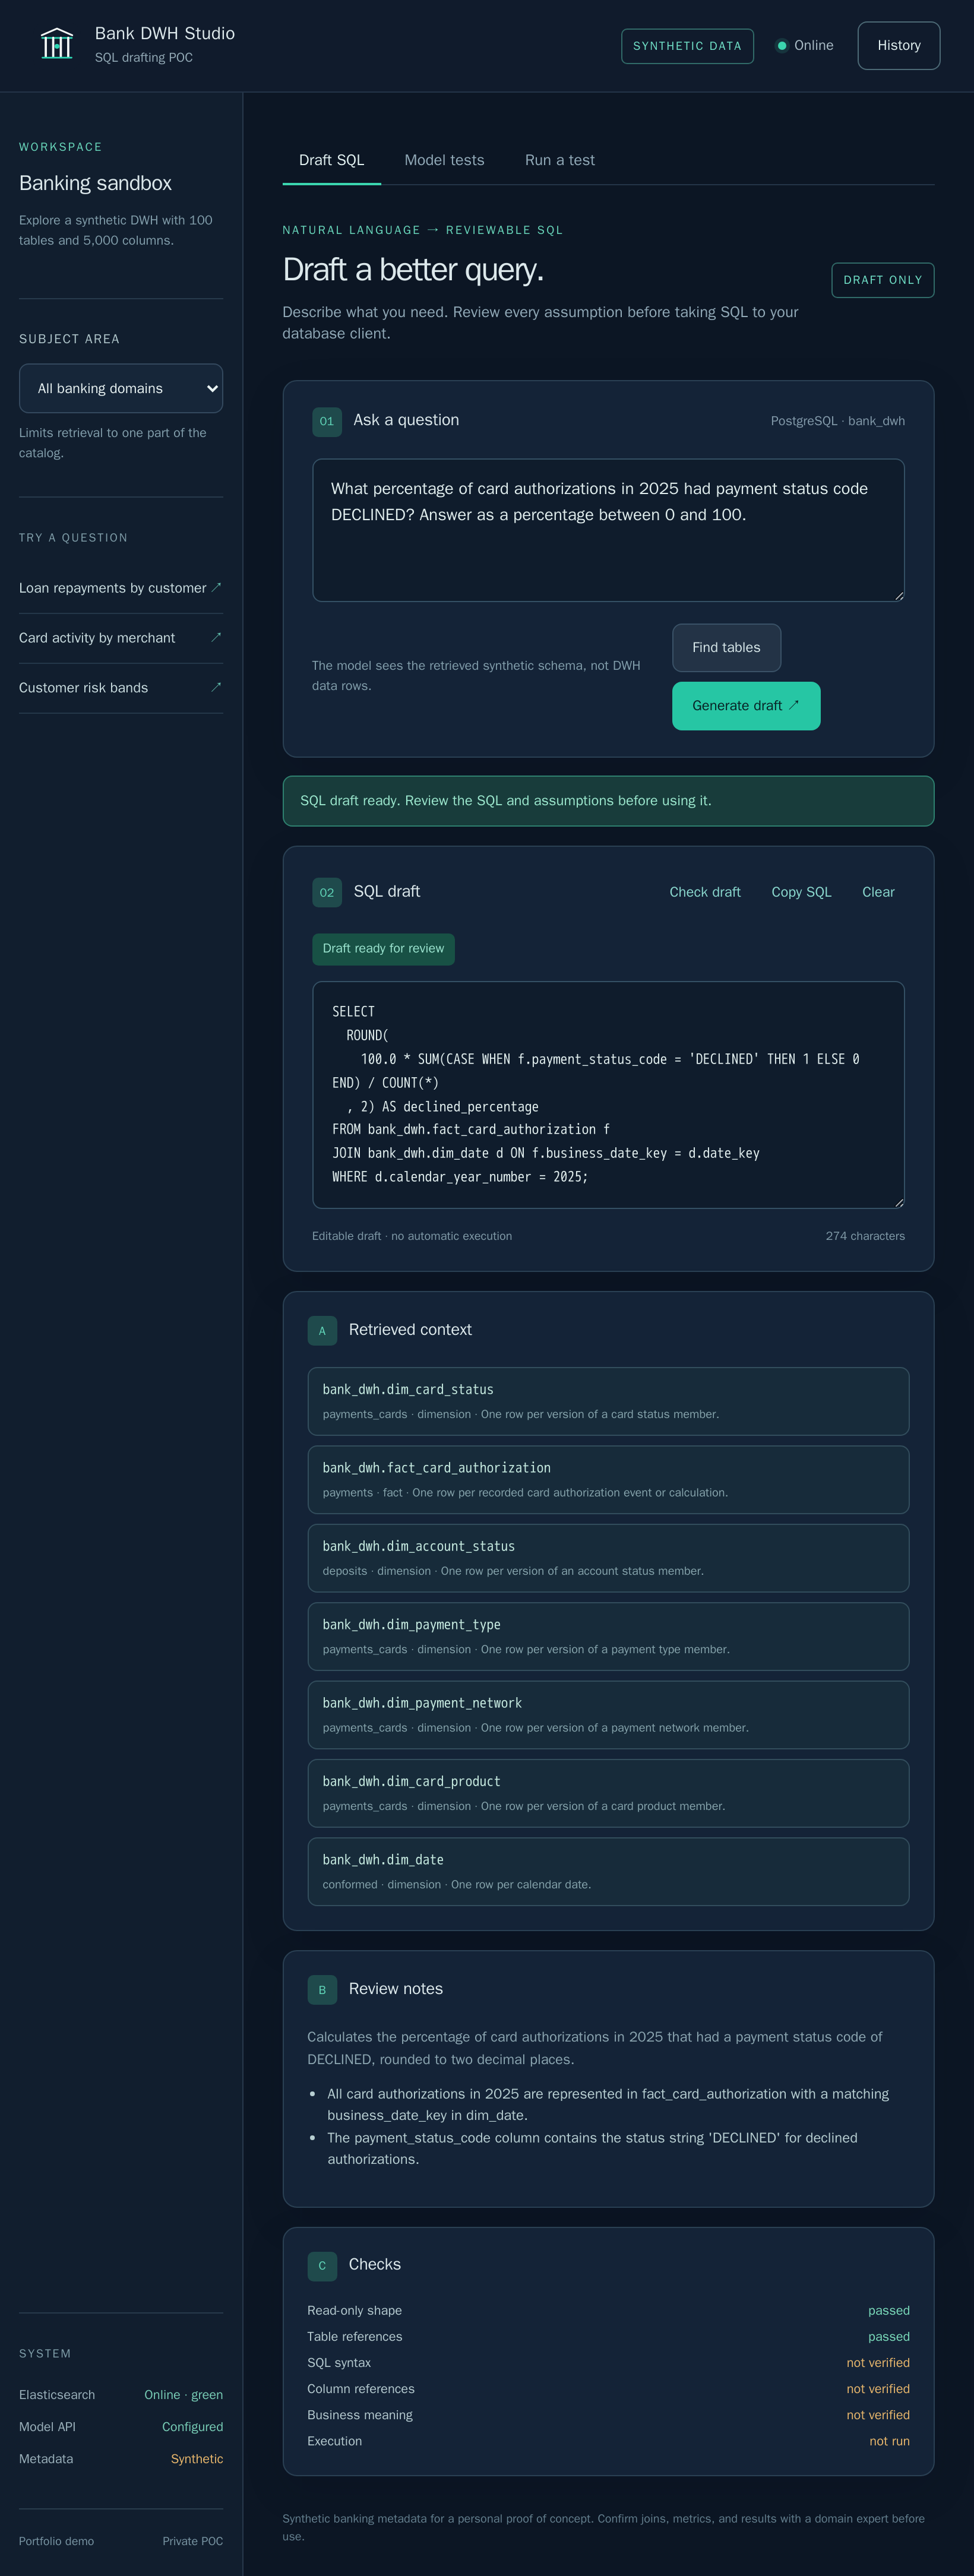
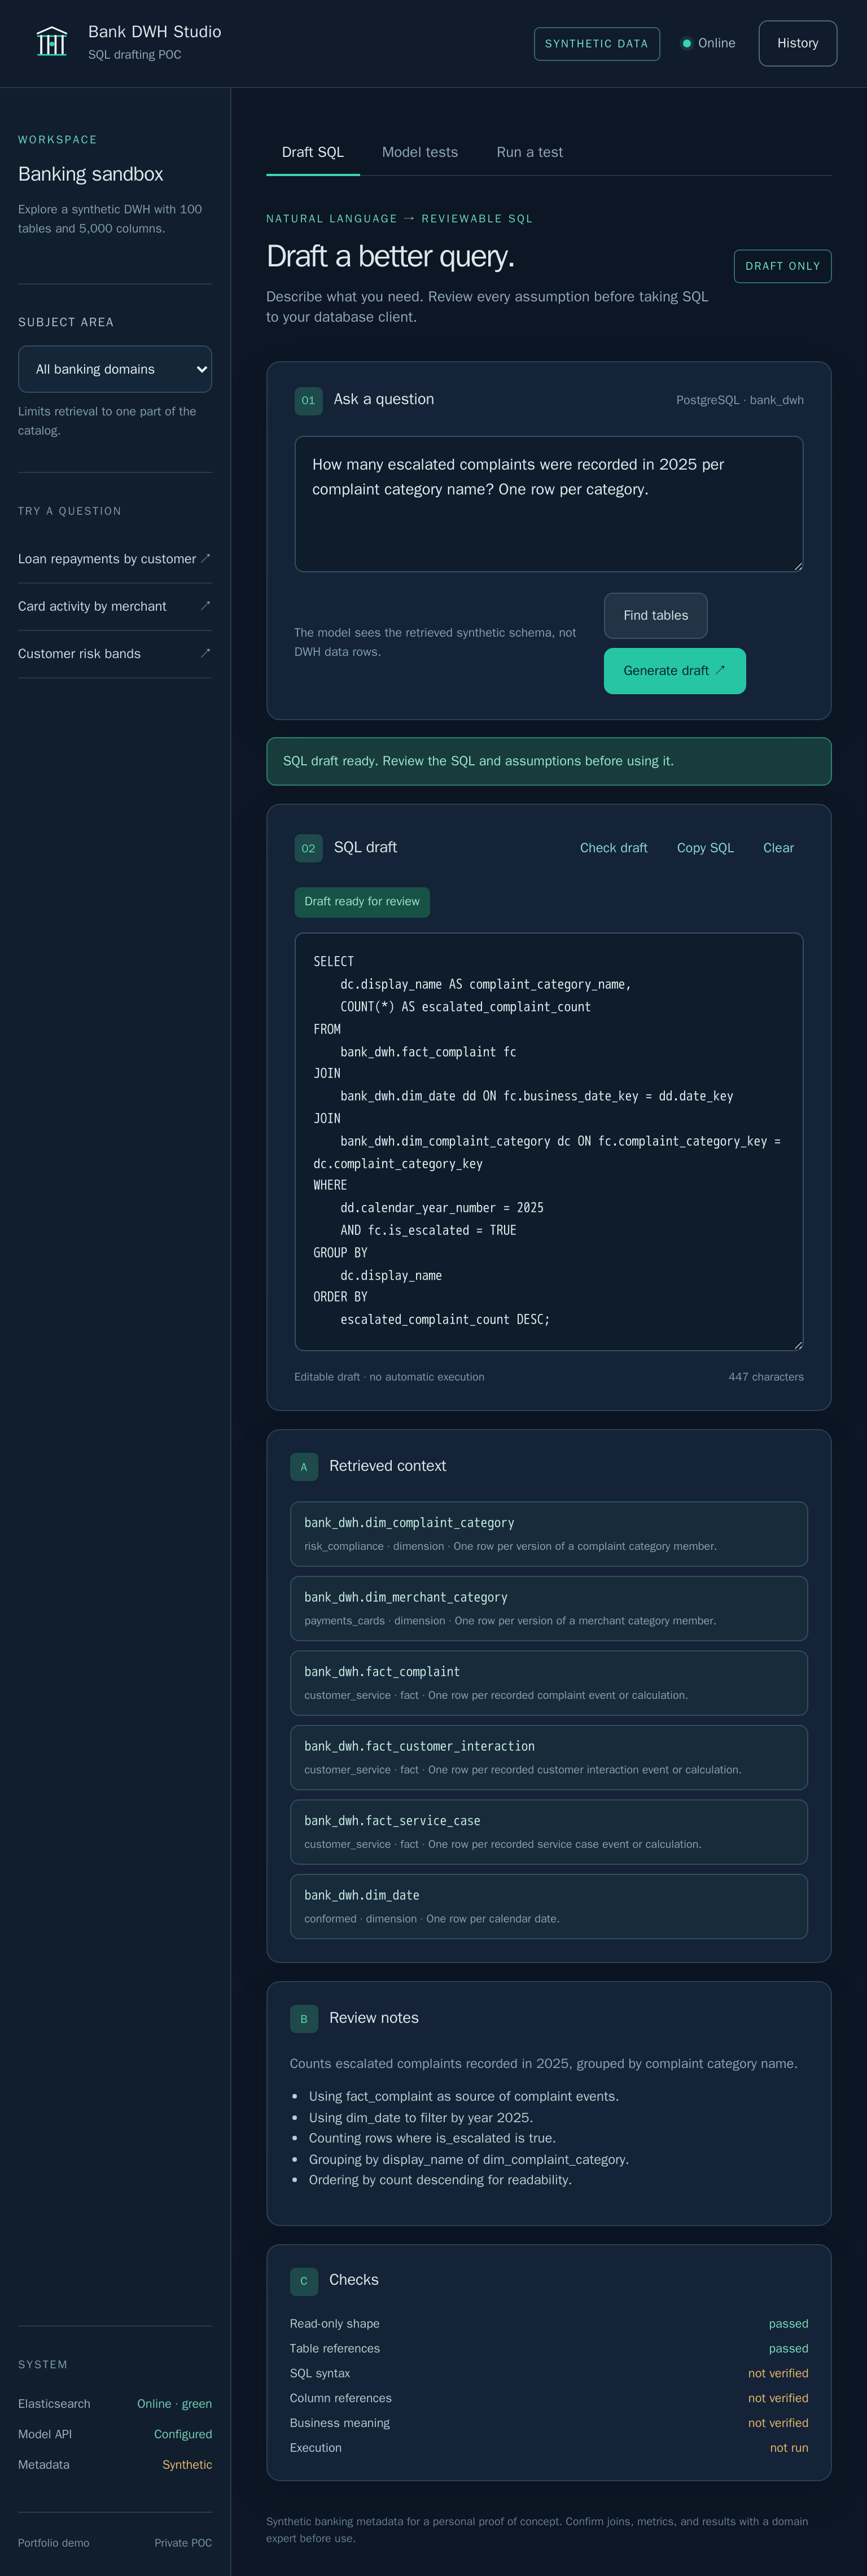
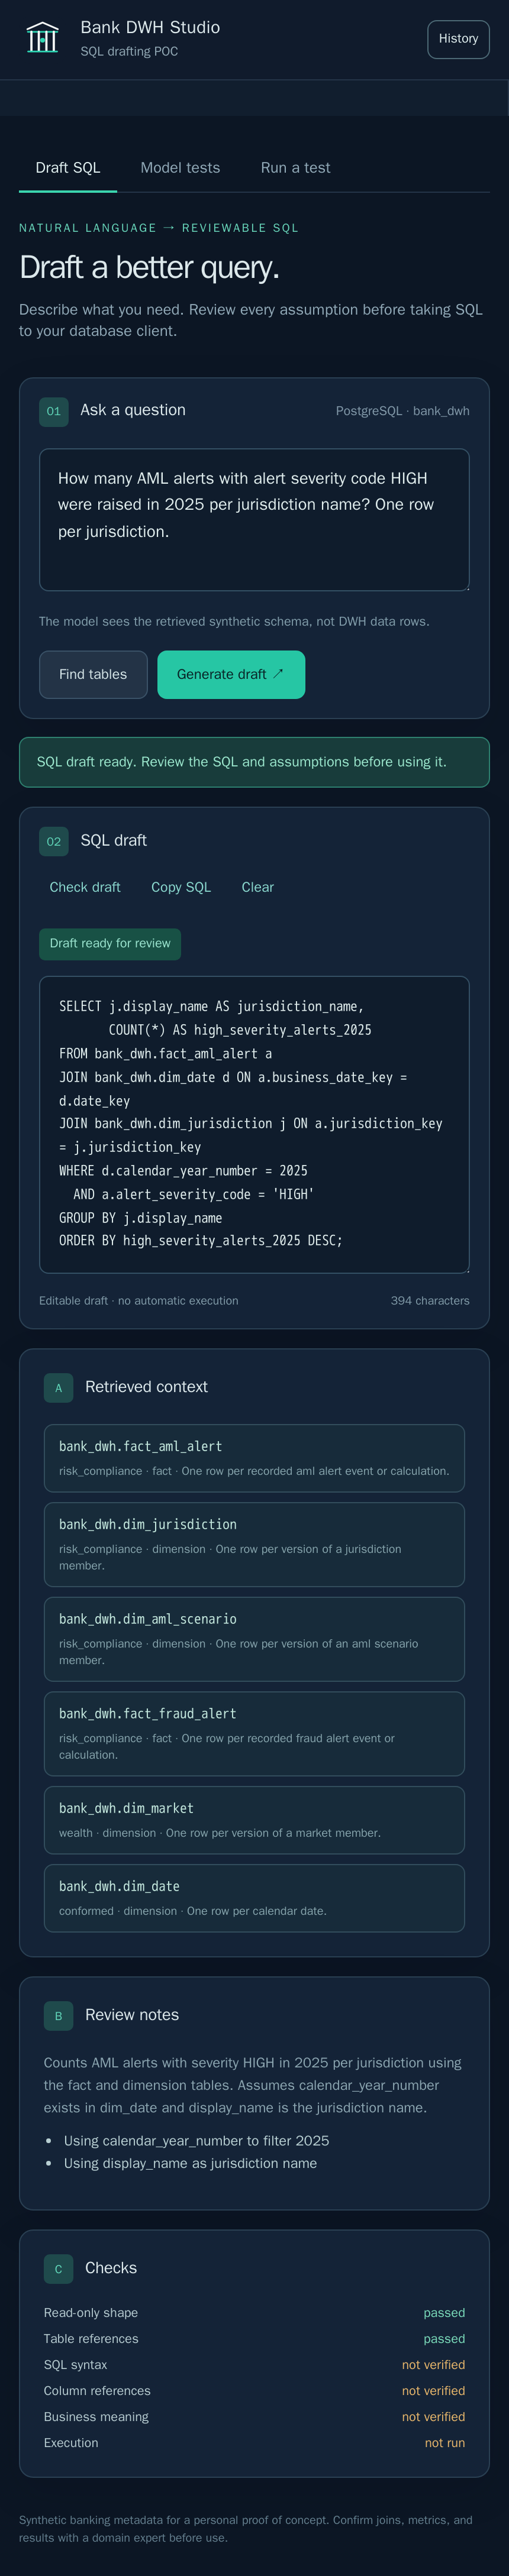
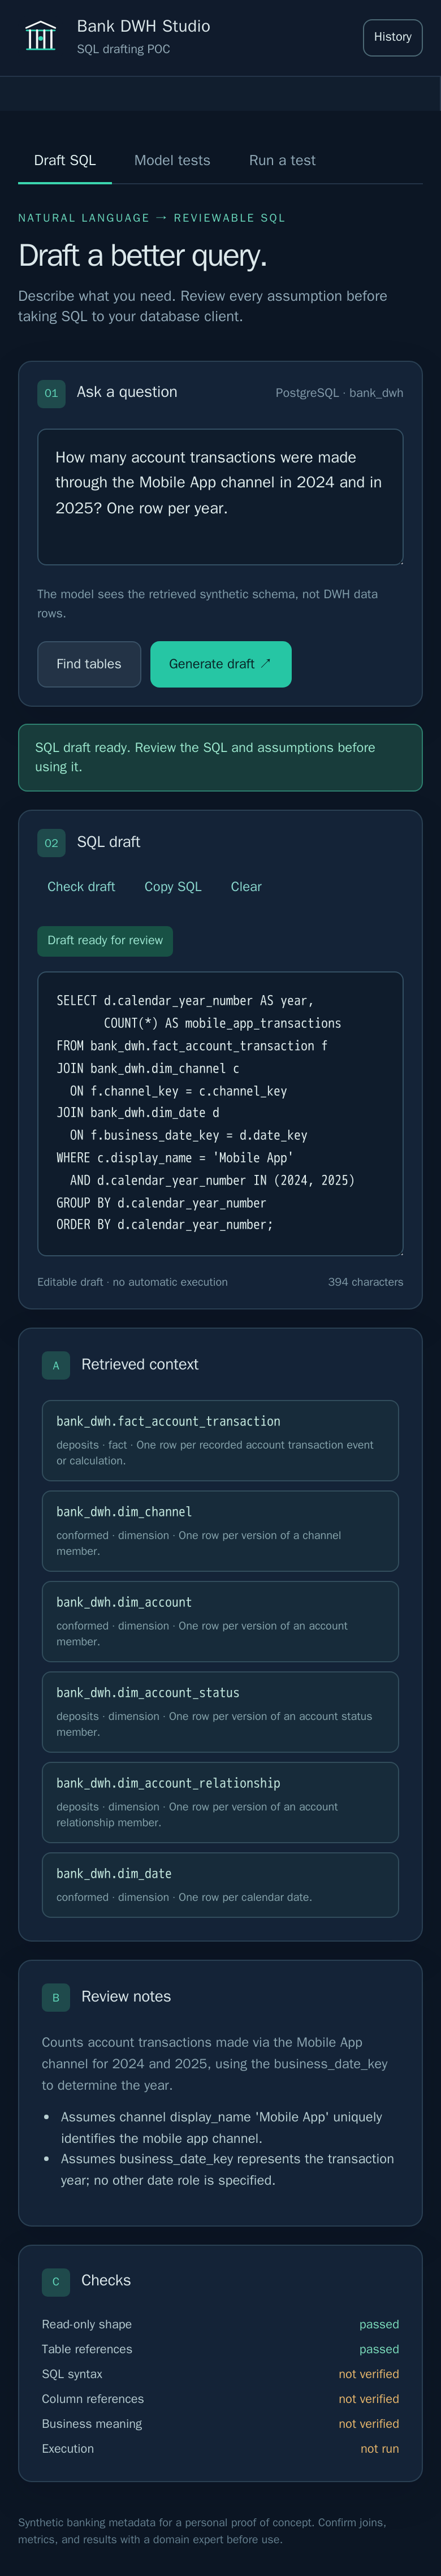
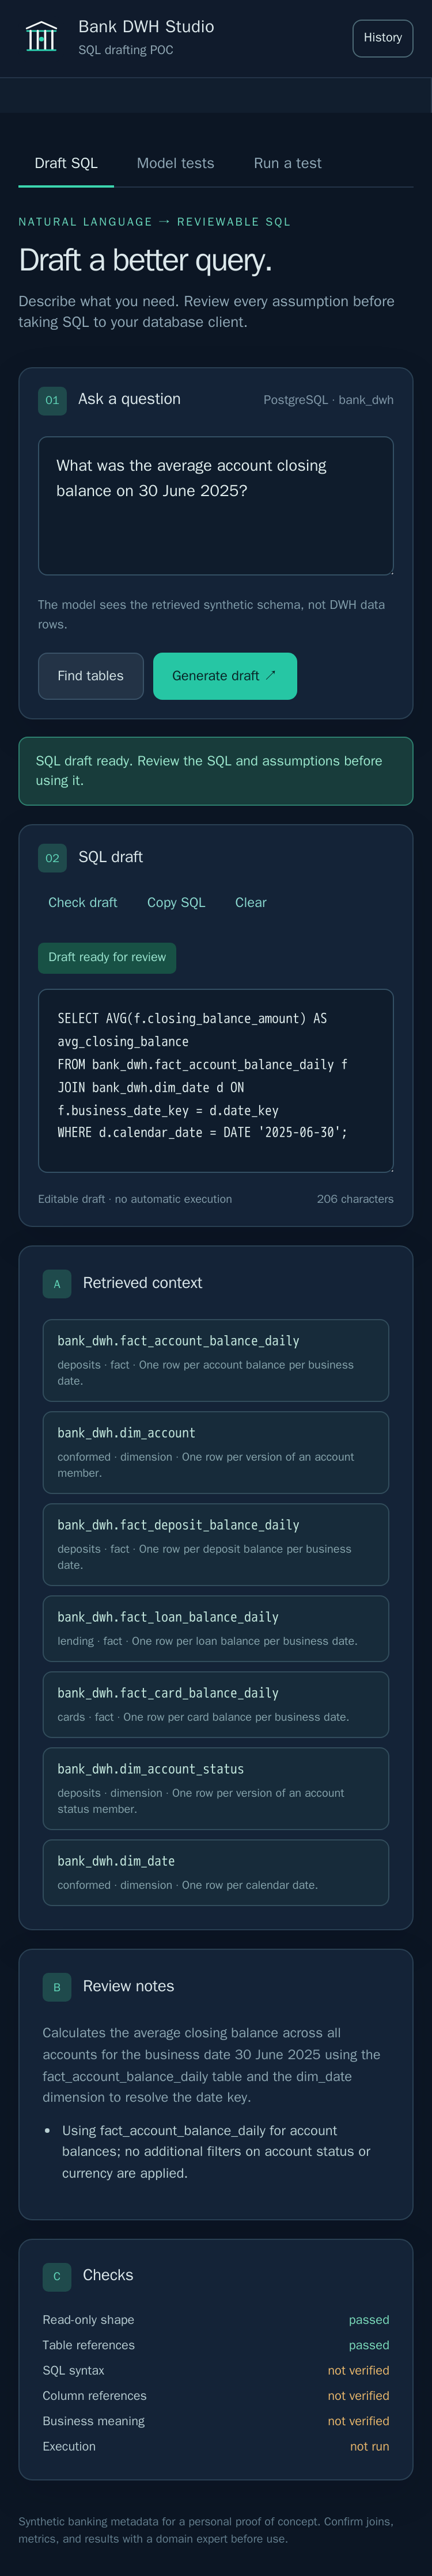
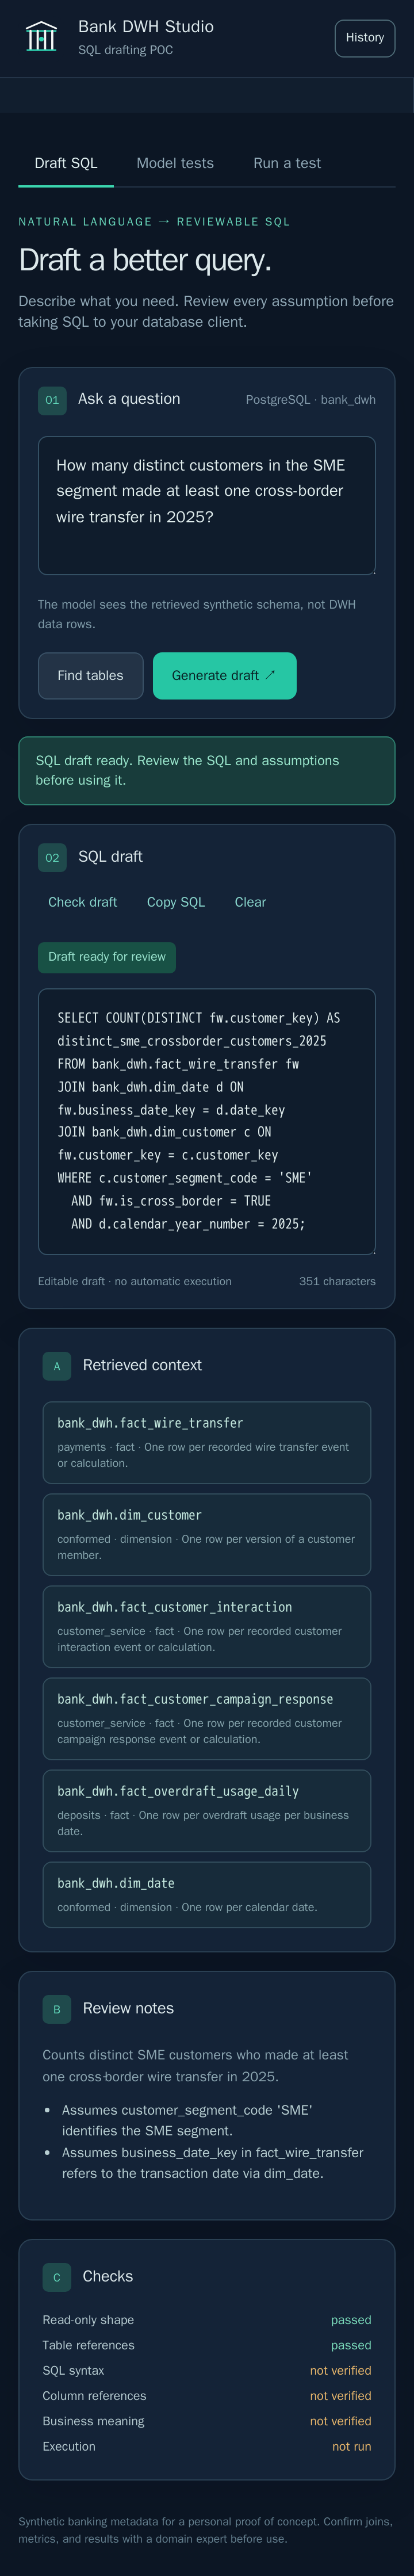
Aplicația scrie și testează schițe SQL, dar doar pe o copie sintetică a depozitului, ca un utilizator care poate doar să citească; nu se conectează niciodată la un depozit bancar real. Utilizatorii verifică în continuare rezultatul, apoi îl editează sau îl copiază și îl rulează în propriul client de baze de date. Browserul nu primește niciodată cheia API a modelului.
Verificările automate acoperă forma instrucțiunilor doar pentru citire și referințele la tabele cunoscute. Sintaxa SQL, referințele la coloane și semnificația de business necesită în continuare verificare umană. Toate numele, relațiile și indicatorii din depozitul inclus în proiect sunt date sintetice pentru testare, nu definiții bancare aprobate.
Dovada de concept publicată rulează un backend Node, Elasticsearch și depozitul PostgreSQL doar pentru citire ca containere fără root pe o instanță Oracle Ampere A1 și redactează SQL cu gpt-oss-20b printr-un furnizor găzduit. Depozitul de cod documentează și o arhitectură viitoare mai amplă, clar separată de POC-ul publicat, mai mic.
O mică consolă pentru gestionarea invitațiilor și dispozitivelor din aplicații web private.
Mica piesă care ajută aplicațiile web să funcționeze offline și să rămână la zi.
Arată cum circulă lucrurile. Creează și exportă diagrame direct în browser.