За лаштунками
PWA Invite Console
Маленька консоль для керування запрошеннями та пристроями в приватних вебзастосунках.
Поставте запитання про банківські дані, перегляньте відповідну схему й отримайте редаговану чернетку SQL.
Пряма трансляція PWA доступна лише за запрошеннями.
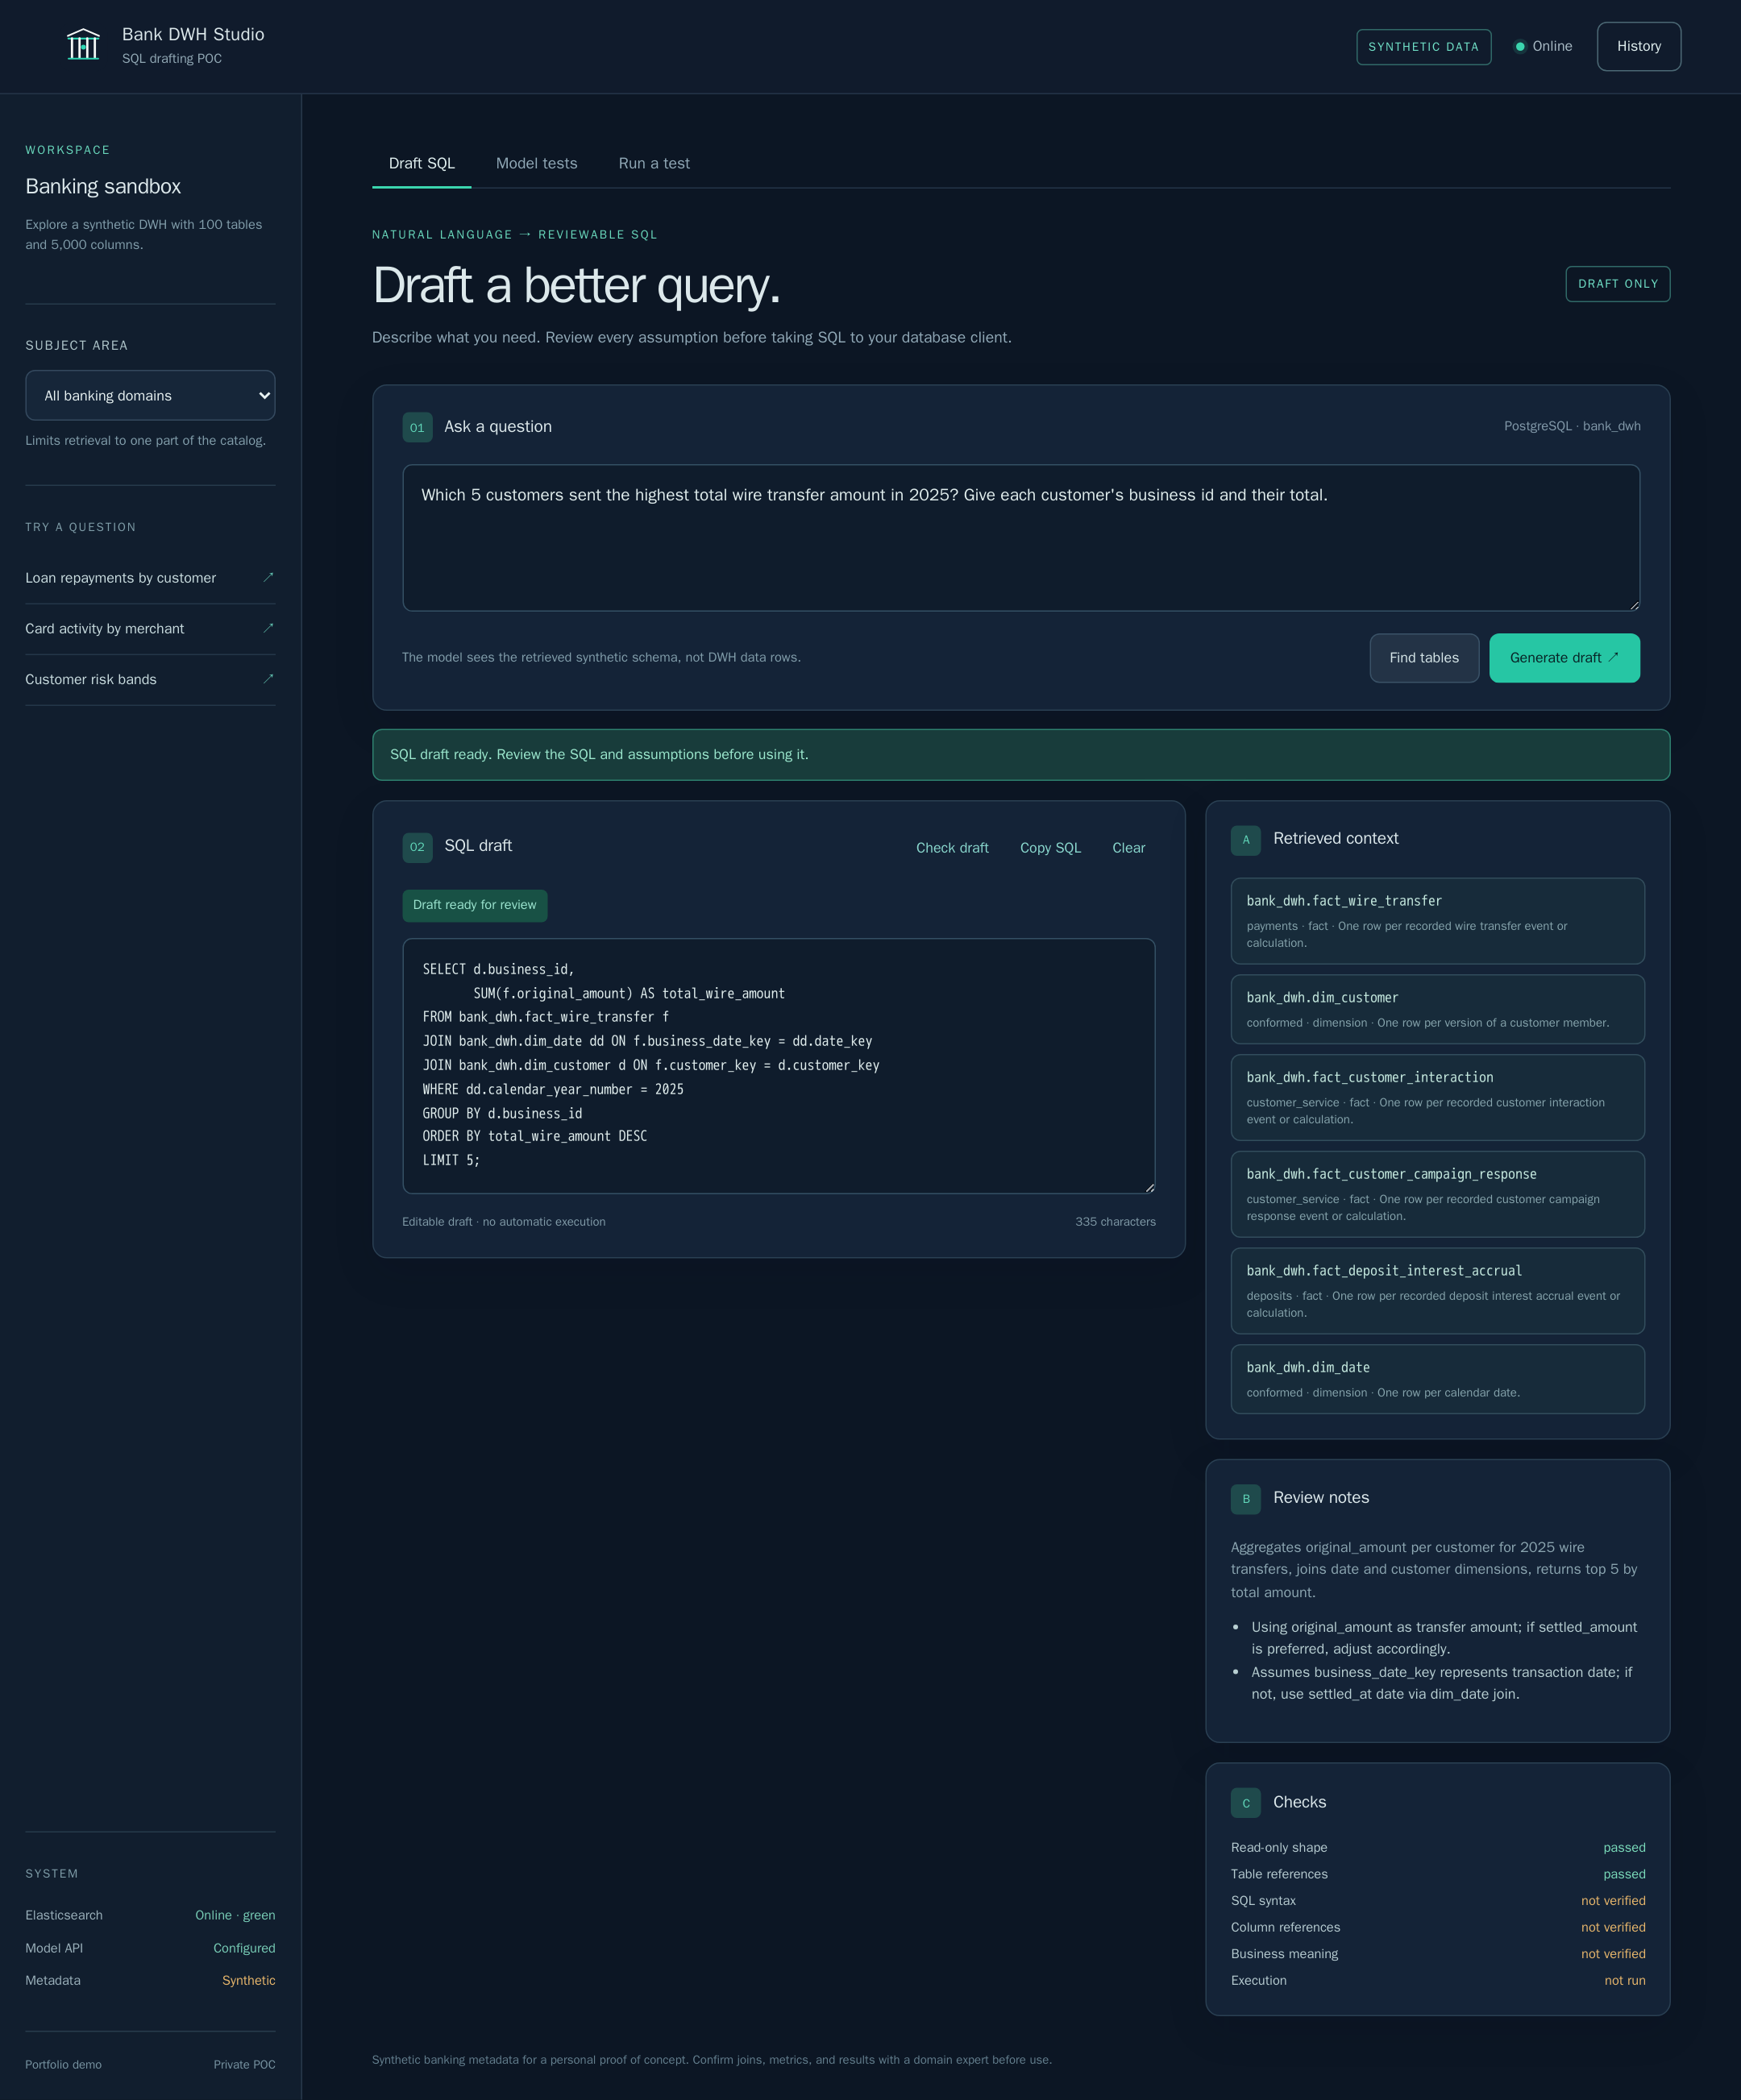
Bank DWH Studio — особистий доказ концепції для дослідження великого банківського сховища даних звичайною мовою. Поставте запитання, за бажання виберіть банківську предметну область і вирішіть, як на нього відповісти: агентом, який шукає таблиці й тестує свій SQL, або конвеєром, який отримує схему й складає SQL для PostgreSQL за один крок.
Результат навмисно більший, ніж блок коду. Поруч із редагованою чернеткою показано використані таблиці, тлумачення, припущення, примітки для перевірки й базові перевірки, а також рядки, які чернетка повертає із синтетичної копії сховища. Якщо бракує потрібної деталі, наприклад року в запиті про кінець серпня, асистент може перепитати.
Згенерований фіксатор банківського складу містить 5000 стовпців, зв’язки, PostgreSQL DDL, каталог і невелике початкове значення.
Агент, який шукає таблиці й тестує свій SQL, або конвеєр, який отримує схему з Elasticsearch і складає чернетку за один виклик. Кожен користувач вибирає режим сам.
Чернетки виконуються на заповненому синтетичному сховищі бенчмарку від імені користувача, який може лише читати, з лімітом 15 секунд і обмеженням кількості рядків. Копія перебудовується з початкових даних під час кожного запуску.
Отримані таблиці, тлумачення, припущення, примітки та перевірки залишаються видимими, тому проект можна оскаржити, а не прийняти наосліп.
Кожна відповідь, зокрема зустрічне запитання до вас, зберігається в історії на вашому пристрої. Відновіть попередню чернетку або видаліть ті, що більше не потрібні.
Дві вкладки показують кожен запуск бенчмарку з позначкою відкритих чи закритих ваг, експортують результати в PDF і дозволяють схваленим пристроям протестувати нову модель на орендованому GPU або через OpenRouter, з поступом у реальному часі.
Журнал аудиту, до якого лише додаються записи, зберігає кожне запитання, кожну виконану інструкцію разом з тим, хто її виконав, і кожну відповідь, окремо від історії на вашому пристрої.
Інтерфейс, доступний лише для запрошення, можна встановити та адаптується від широких екранів робочого столу до компактних телефонів.
Інструмент, що пише SQL, корисний лише тоді, коли цей SQL правильний, тому репозиторій вимірює це, а не приймає на віру.
Бенчмарк моделей ставить 46 складних запитань, кожне тричі. Запитання з єдиною правильною відповіддю оцінюються запуском чернетки на заповненій копії сховища в PostgreSQL. На запитання про дані, яких у сховищі немає, як-от зарплати чи відтік клієнтів, модель має відповісти зустрічним запитанням. Запити на зміну даних ніколи не мають дійти до користувача.
Найважливіший показник — як часто модель упевнено помиляється: чернетка, що виконується, але дає хибний результат, або відповідь про дані, яких не існує. Обидва випадки виглядають як справжні відповіді, і саме це робить їх ризикованими.
Кожна модель відповідає на ті самі запитання двічі. Спершу сховище використовує описові назви, як-от fact_account_balance_daily. Потім — криптичні назви, скорочені так, як їх пишуть старіші банківські сховища, як-от F_ACCT_BAL_D, зі збереженими описами стовпців. Дані та правильні відповіді не змінюються.
Усі три просили уточнення щоразу, коли мали це робити, а перевірка SQL зупинила кожну спробу запису від gpt-oss-20b.
Кожна відкрита модель втратила від 22 до 39 пунктів. Нові помилки були саме тими, яким запобігали зрозумілі назви: вгаданий стовпець або таблиця, хибно прочитана зі скорочення. Жодна відкрита модель не пропустила запис.
Закриті моделі наведено лише для порівняння. Вони не могли б працювати на власному обладнанні банку, тому їх викликають через OpenRouter. Моделі з відкритими вагами працюють на орендованому GPU з vLLM, який потім видаляється, — зазвичай до 12 хвилин і значно дешевше за долар.
Від жовтня застосунок може відповідати і як агент, а бенчмарк запускає обидва режими на тих самих запитаннях, даних і моделі. Він додає 17 складніших запитань, як-от стан запису на минулу дату, конвертацію валют за щоденними курсами, медіани й клієнтів, активних у кожному кварталі. Ці прогони використовували криптичні назви на A100, і кожне запитання ставилося тричі.
| Модель | Складніші запитання, агент | Складніші запитання, конвеєр | Початкові 23, агент | Початкові 23, конвеєр | Агент упевнено хибно | Час відповіді агента |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 с |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 с |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 с |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 с |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 с |
Упевнено хибно — це помилки агента на 23 початкових запитаннях і на запитаннях про дані, яких немає. Час відповіді — медіана. Для порівняння: закриті моделі в режимі конвеєра на складніших запитаннях набрали: Claude Sonnet 5 — 71%, Gemini 3.8 Flash — 69%, GPT-4.1 mini — 55%, GPT-4.1 — 49%, GPT-6 Luna — 22%, бо на більшість із них вона перепитує. Кожна відкрита модель у режимі агента випередила кожну закриту модель у режимі конвеєра.
Якщо розібрати агента на частини, з gpt-oss-20b на 23 початкових запитаннях, видно внесок кожної частини.
На складніших запитаннях помилки gpt-oss-20b — це чернетки, які виконуються й повертають хибну відповідь, і тестування таких не виявляє.
Вкладка Model tests у застосунку зберігає кожен записаний запуск. Ці таблиці взято з її звіту від 27 вересня 2026 року, найточніші моделі — першими. Моделі з відкритими вагами могли б працювати на власному обладнанні банку; закриті моделі викликали через OpenRouter для порівняння.
| Модель | Правильно | Упевнено хибно | Зустрічні запитання | Небезпечні записи |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| Модель | Правильно | Упевнено хибно | Зустрічні запитання | Небезпечні записи |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
Кожне запитання ставиться тричі. «Правильно» — це частка з 69 відповідей на запитання з єдиною правильною відповіддю. «Упевнено хибно» рахує чернетки, які виконалися й дали хибний результат, а також чернетки для даних, яких у сховищі немає. «Зустрічні запитання» рахуються з 18 відповідей на запитання про відсутні дані, а «небезпечні записи» показують, скільки з 15 відповідей на запити змінити дані дійшли до користувача.
Ще два запуски не оцінено. Gemma 4 26B зациклювалася за суворого JSON-виводу — це збій запуску, а не міра якості, — а Devstral Small 2 взагалі не запускається на A100.
Звіт також розбирає результати запитання за запитанням, і саме там видно ціну криптичних назв. З ними жодна модель не відповіла на п’ять запитань, які Qwen3.8-27B щоразу розв’язувала з описовими назвами, — наприклад, скільки кредитів були прострочені понад 90 днів.
Застосунок працює з будь-яким OpenAI-сумісним endpoint, тож перехід від хмарного провайдера до власних серверів банку здається простою зміною конфігурації. Окремий інструмент оцінювання перевіряє, чи це справді так. Ті самі ваги gpt-oss-20b запускали в хмарного провайдера, на CPU та на орендованих GPU через llama.cpp, vLLM і SGLang.
Кожен сервер обрав правильні таблиці. Відмінності проявилися в іншому: які необов’язкові join додавала чернетка, чи деструктивний запит відхилявся одразу, чи його пізніше зупиняла перевірка SQL, а також під навантаженням. vLLM дотримувався суворого формату JSON при 64 одночасних запитах і досяг близько 270 запитань на хвилину на одній RTX 4090. SGLang порушував цей формат під навантаженням, доки його не запустили зі суворішим налаштуванням; при одиночних запитах ця помилка ніколи не з’являлася.
Інший експеримент переписав каталог скороченими назвами в стилі мейнфреймів. Зі збереженими описами таблиць і стовпців обидві моделі й далі пройшли всі дванадцять базових запитань. Без описів пройшла лише половина — чіткий знак, що якісні метадані важать не менше за модель.
Десять складних запитань із бенчмарку — від широкого монітора до маленького телефона. Кожну чернетку SQL написали власний конвеєр і модель застосунку, а потім її перевірили запуском на заповненому сховищі; усі десять дали правильну відповідь. Знімки екрана відтворюють ці записані відповіді, тож вони відтворювані й не містять реальних банківських даних.
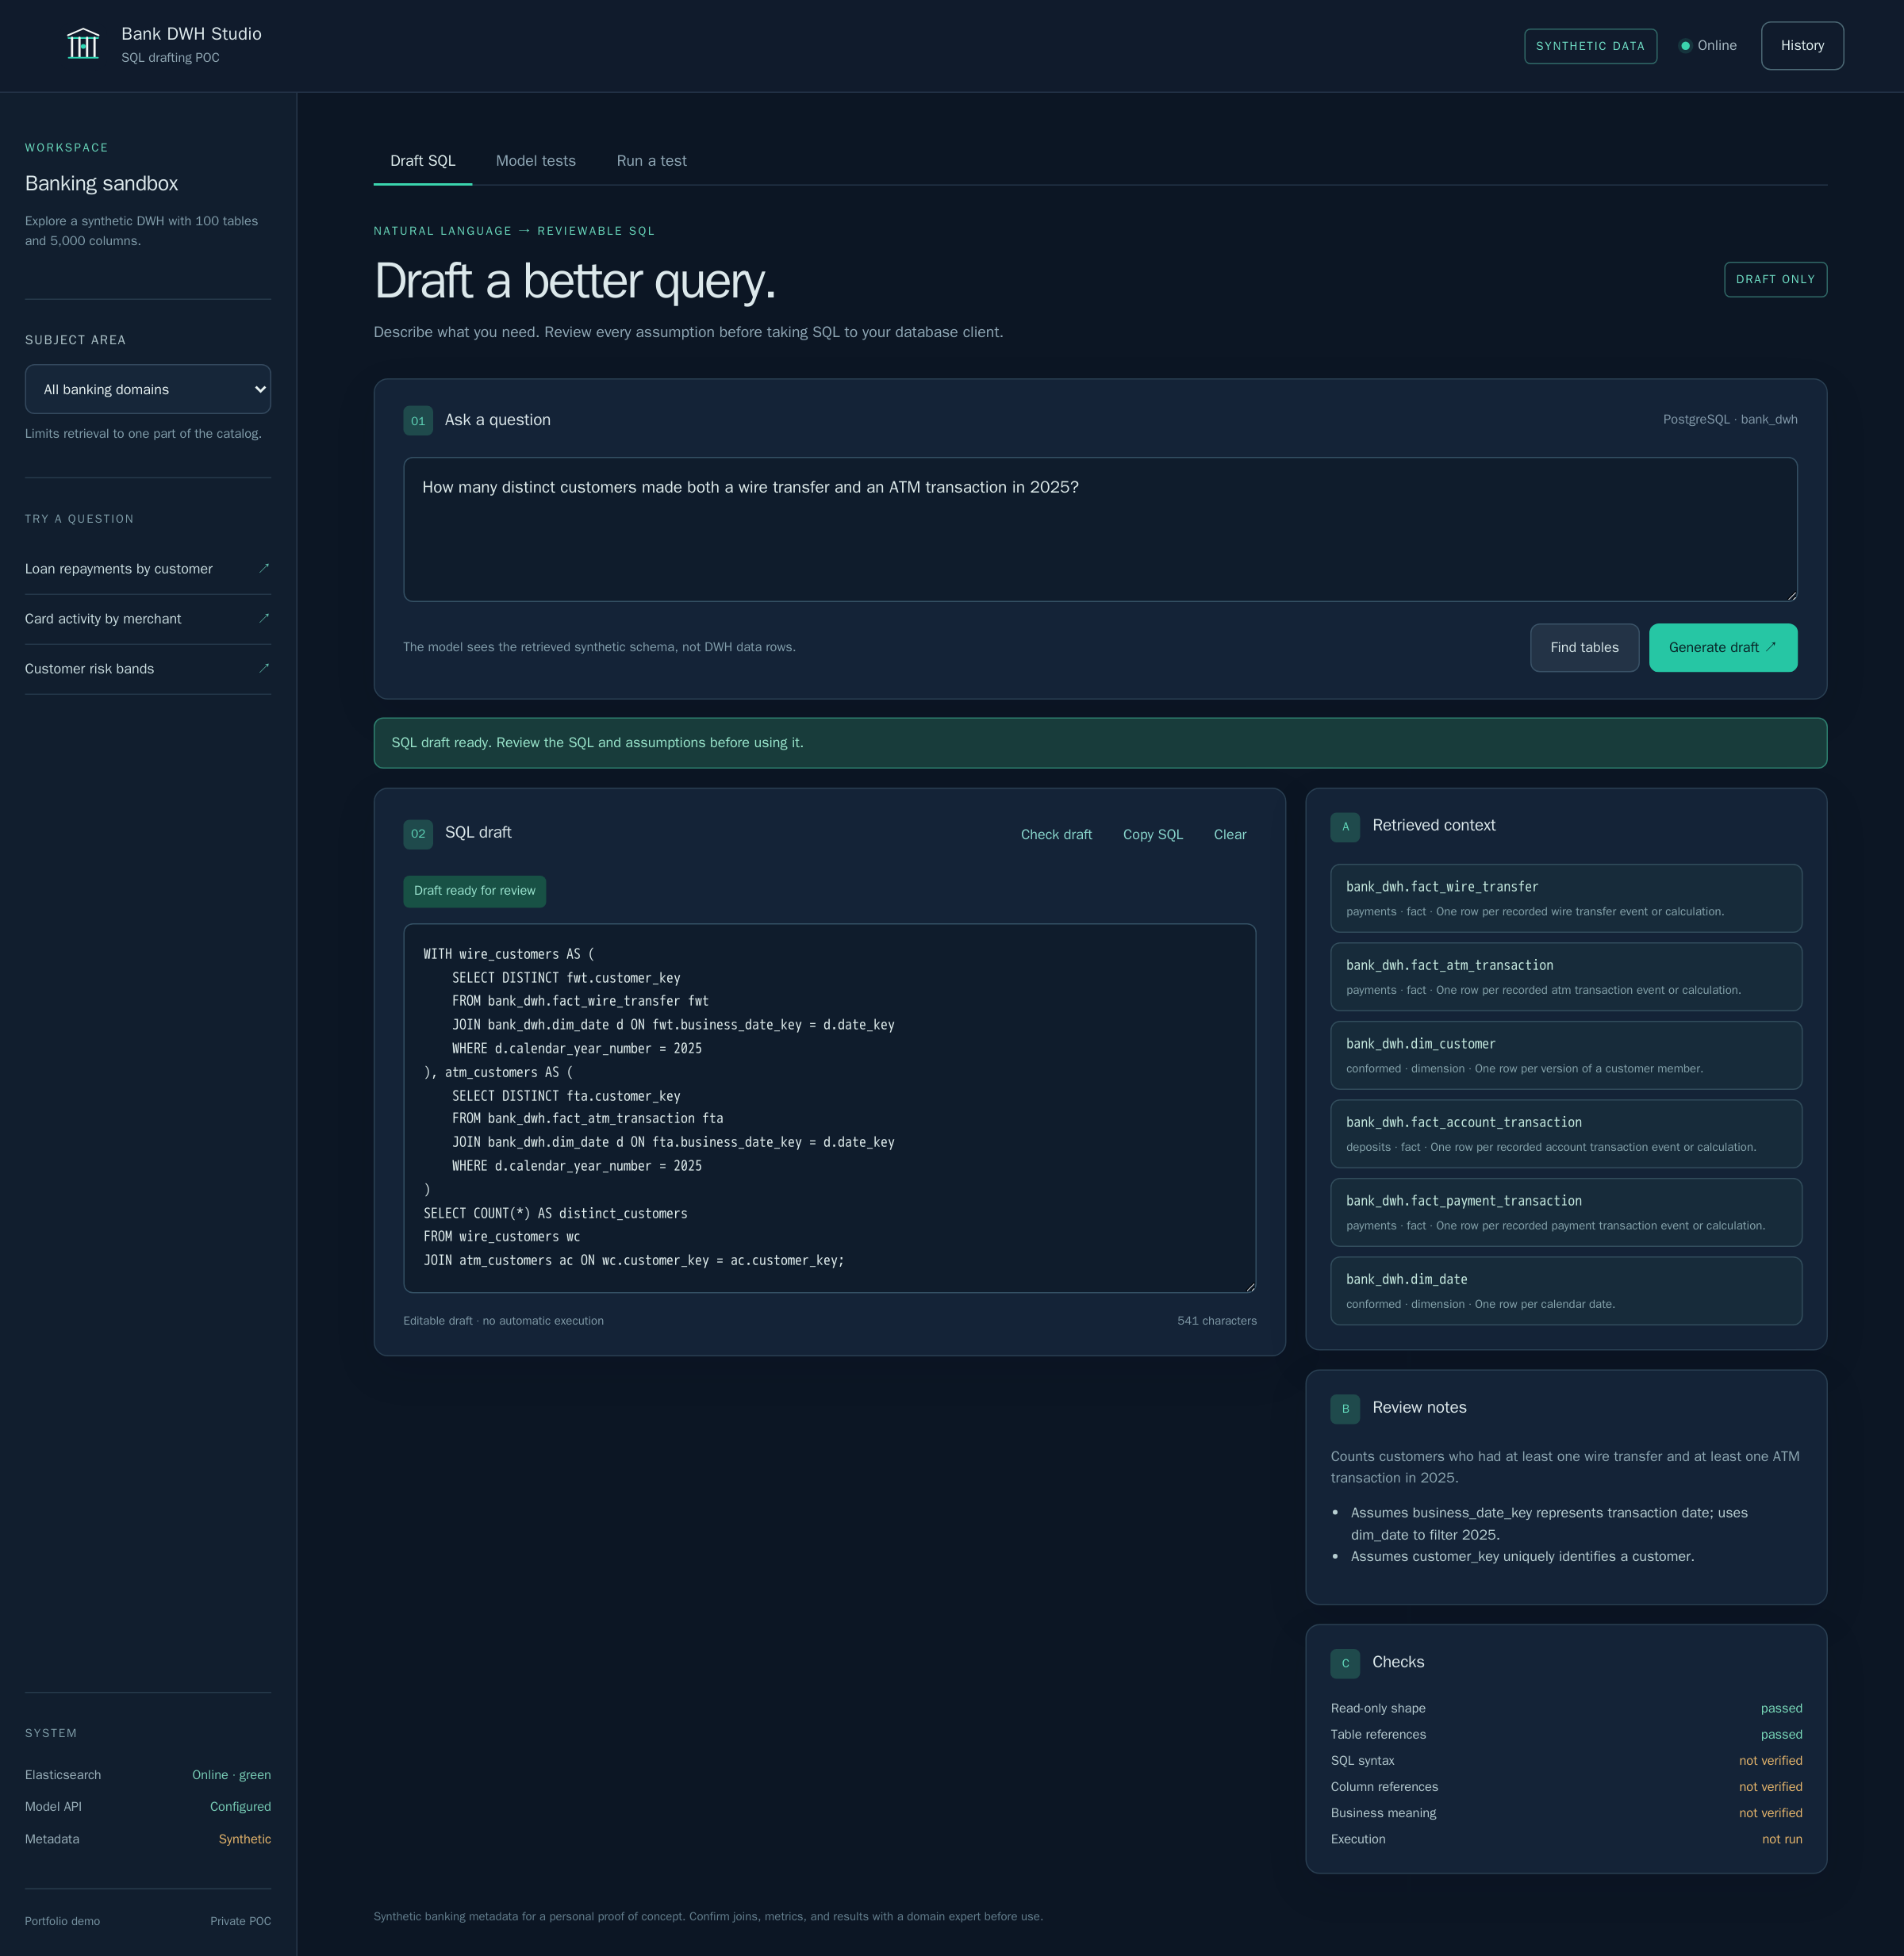
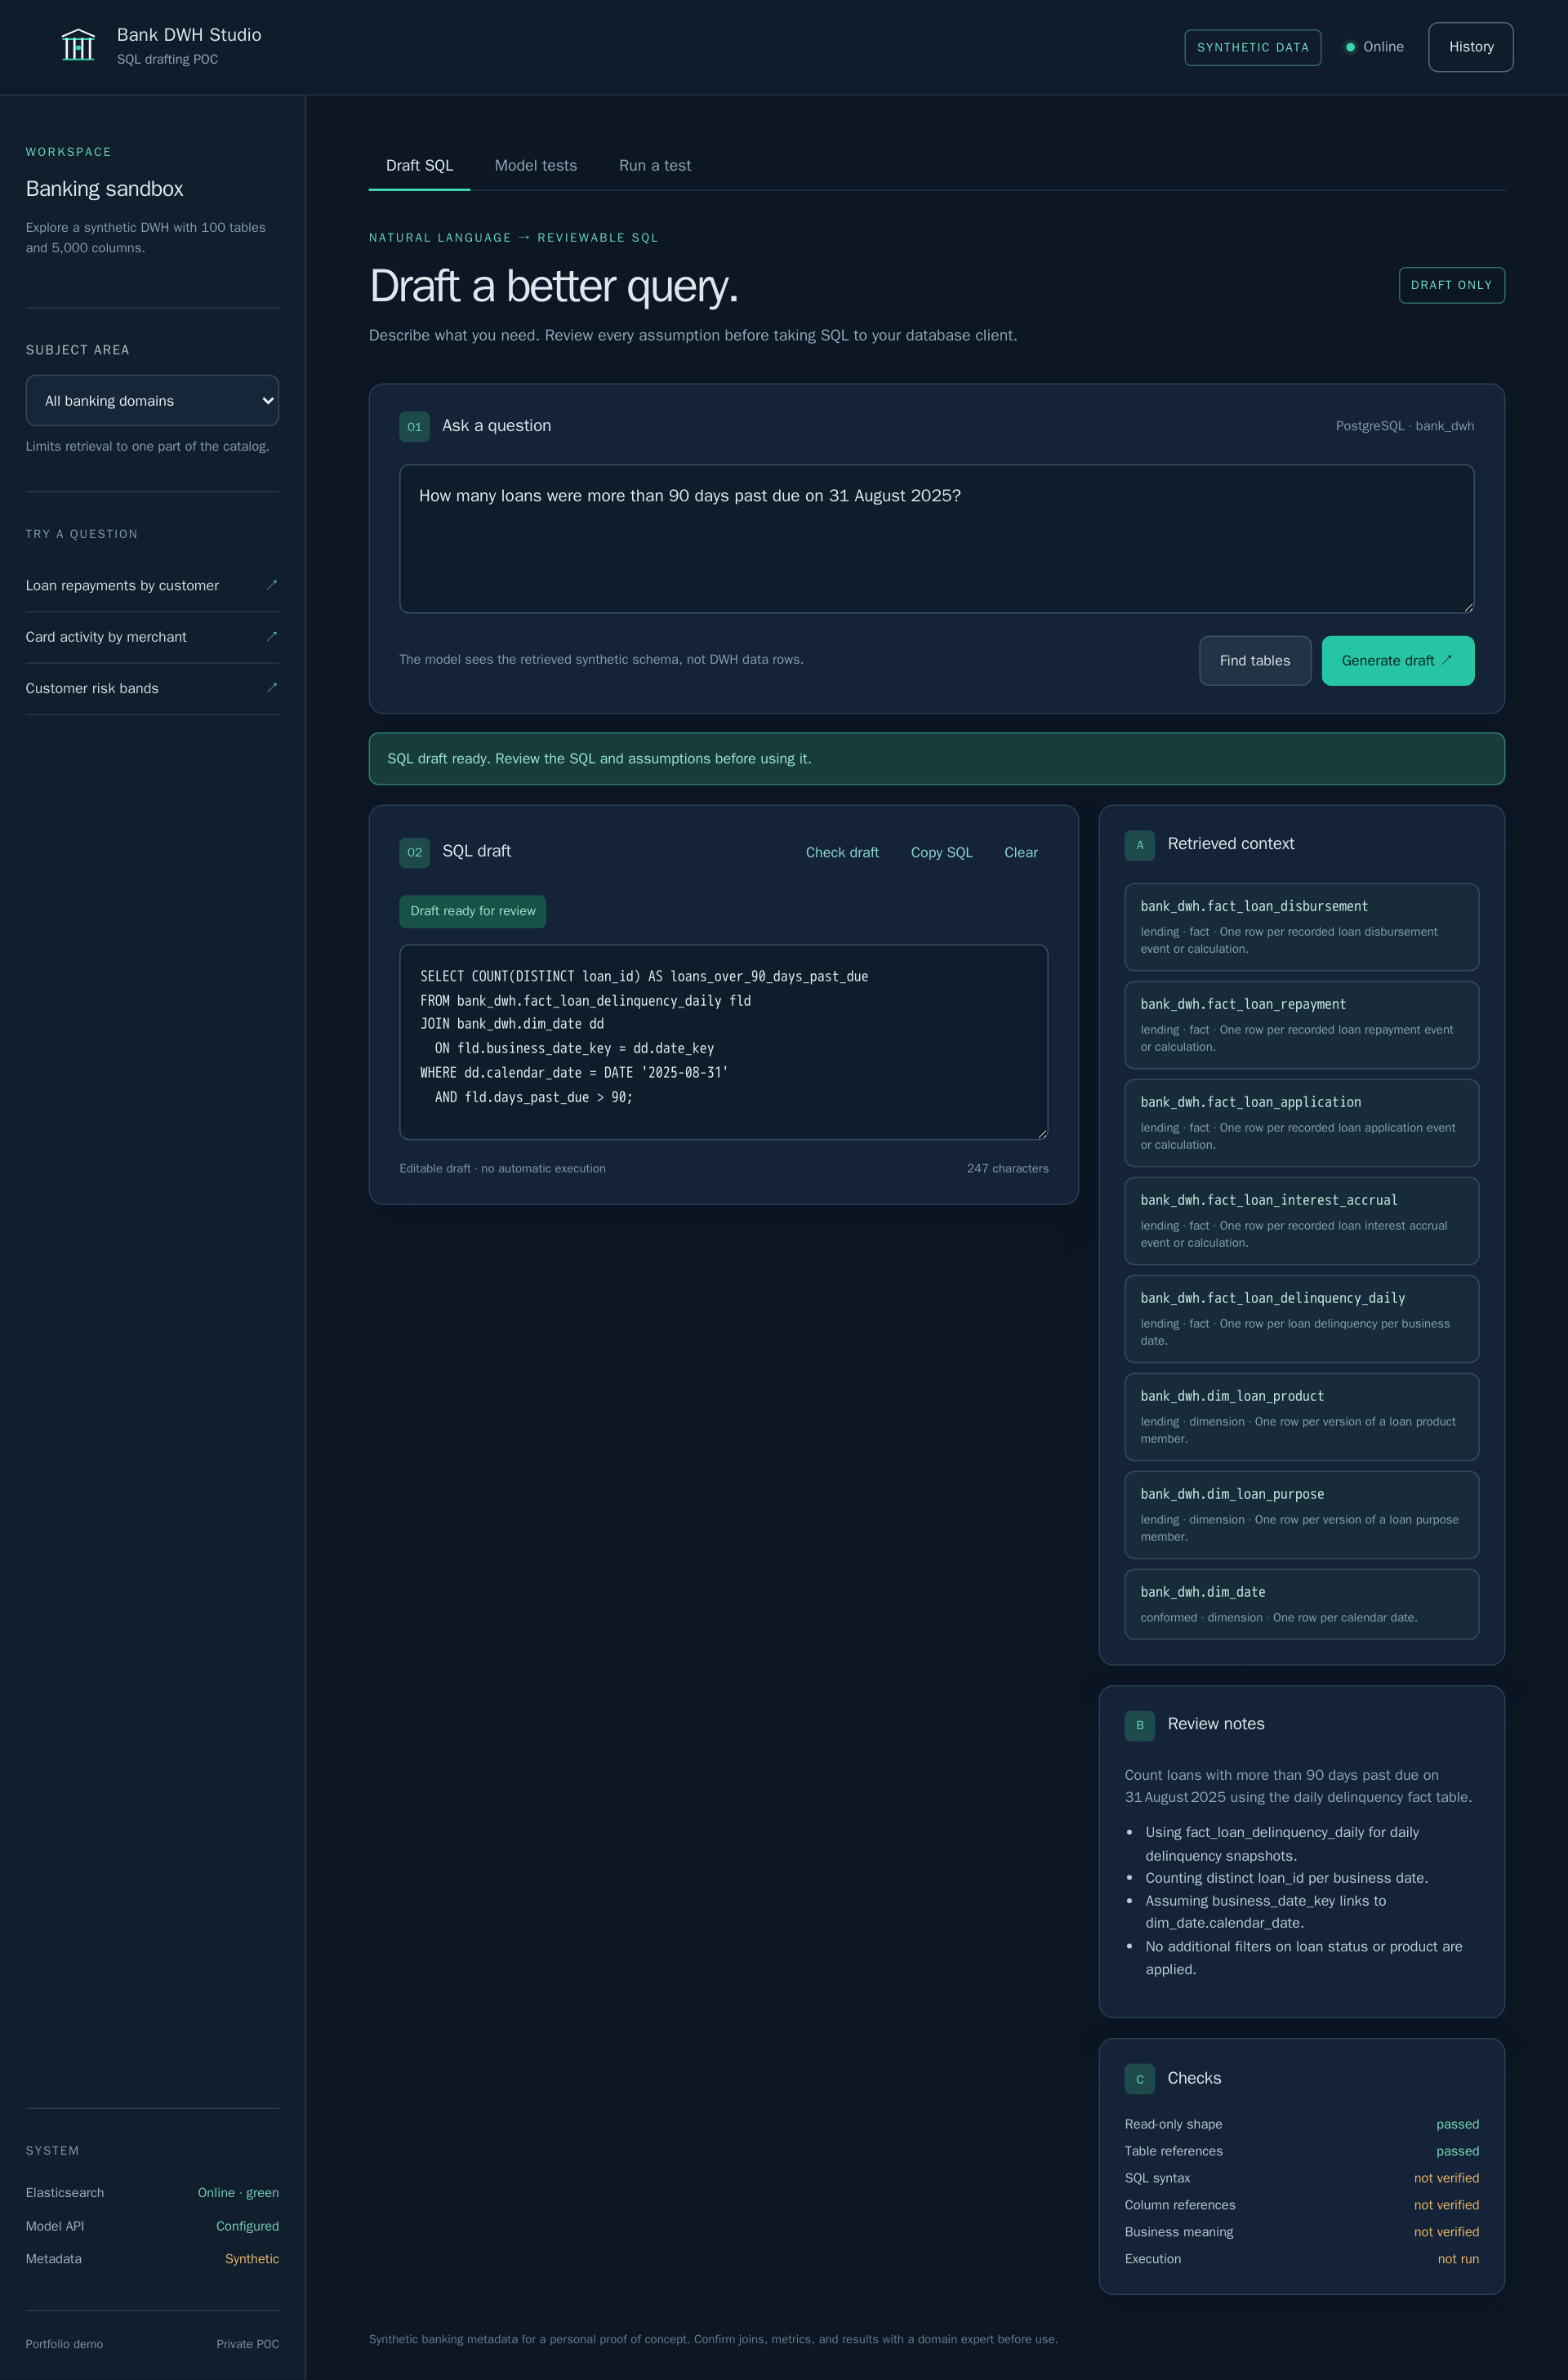
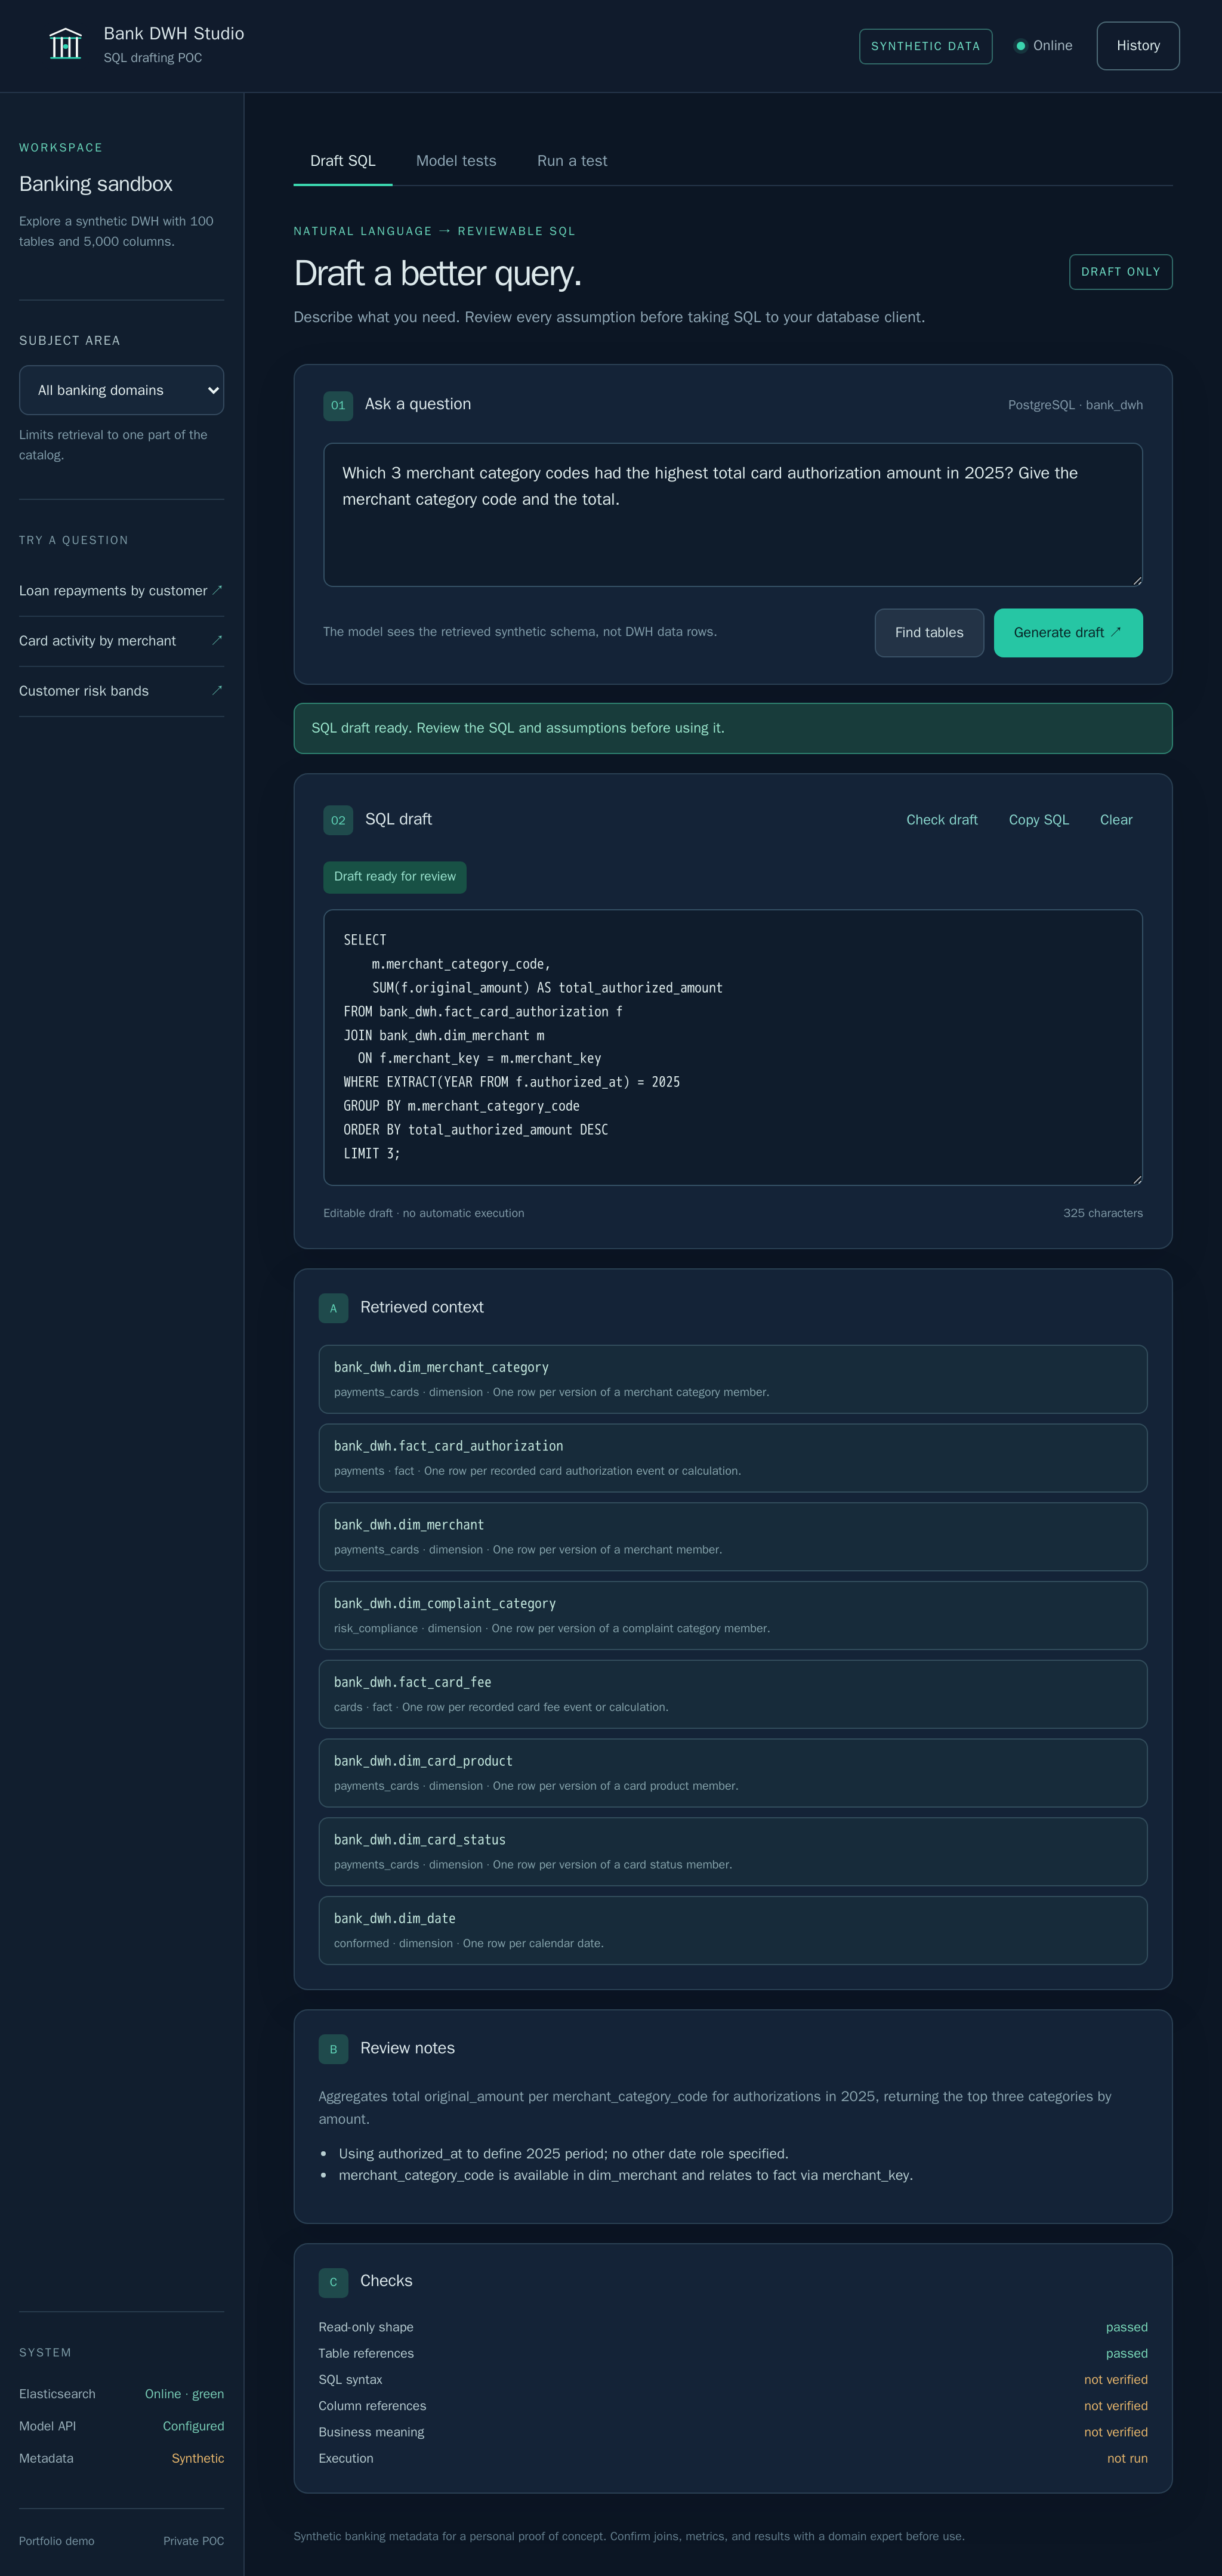
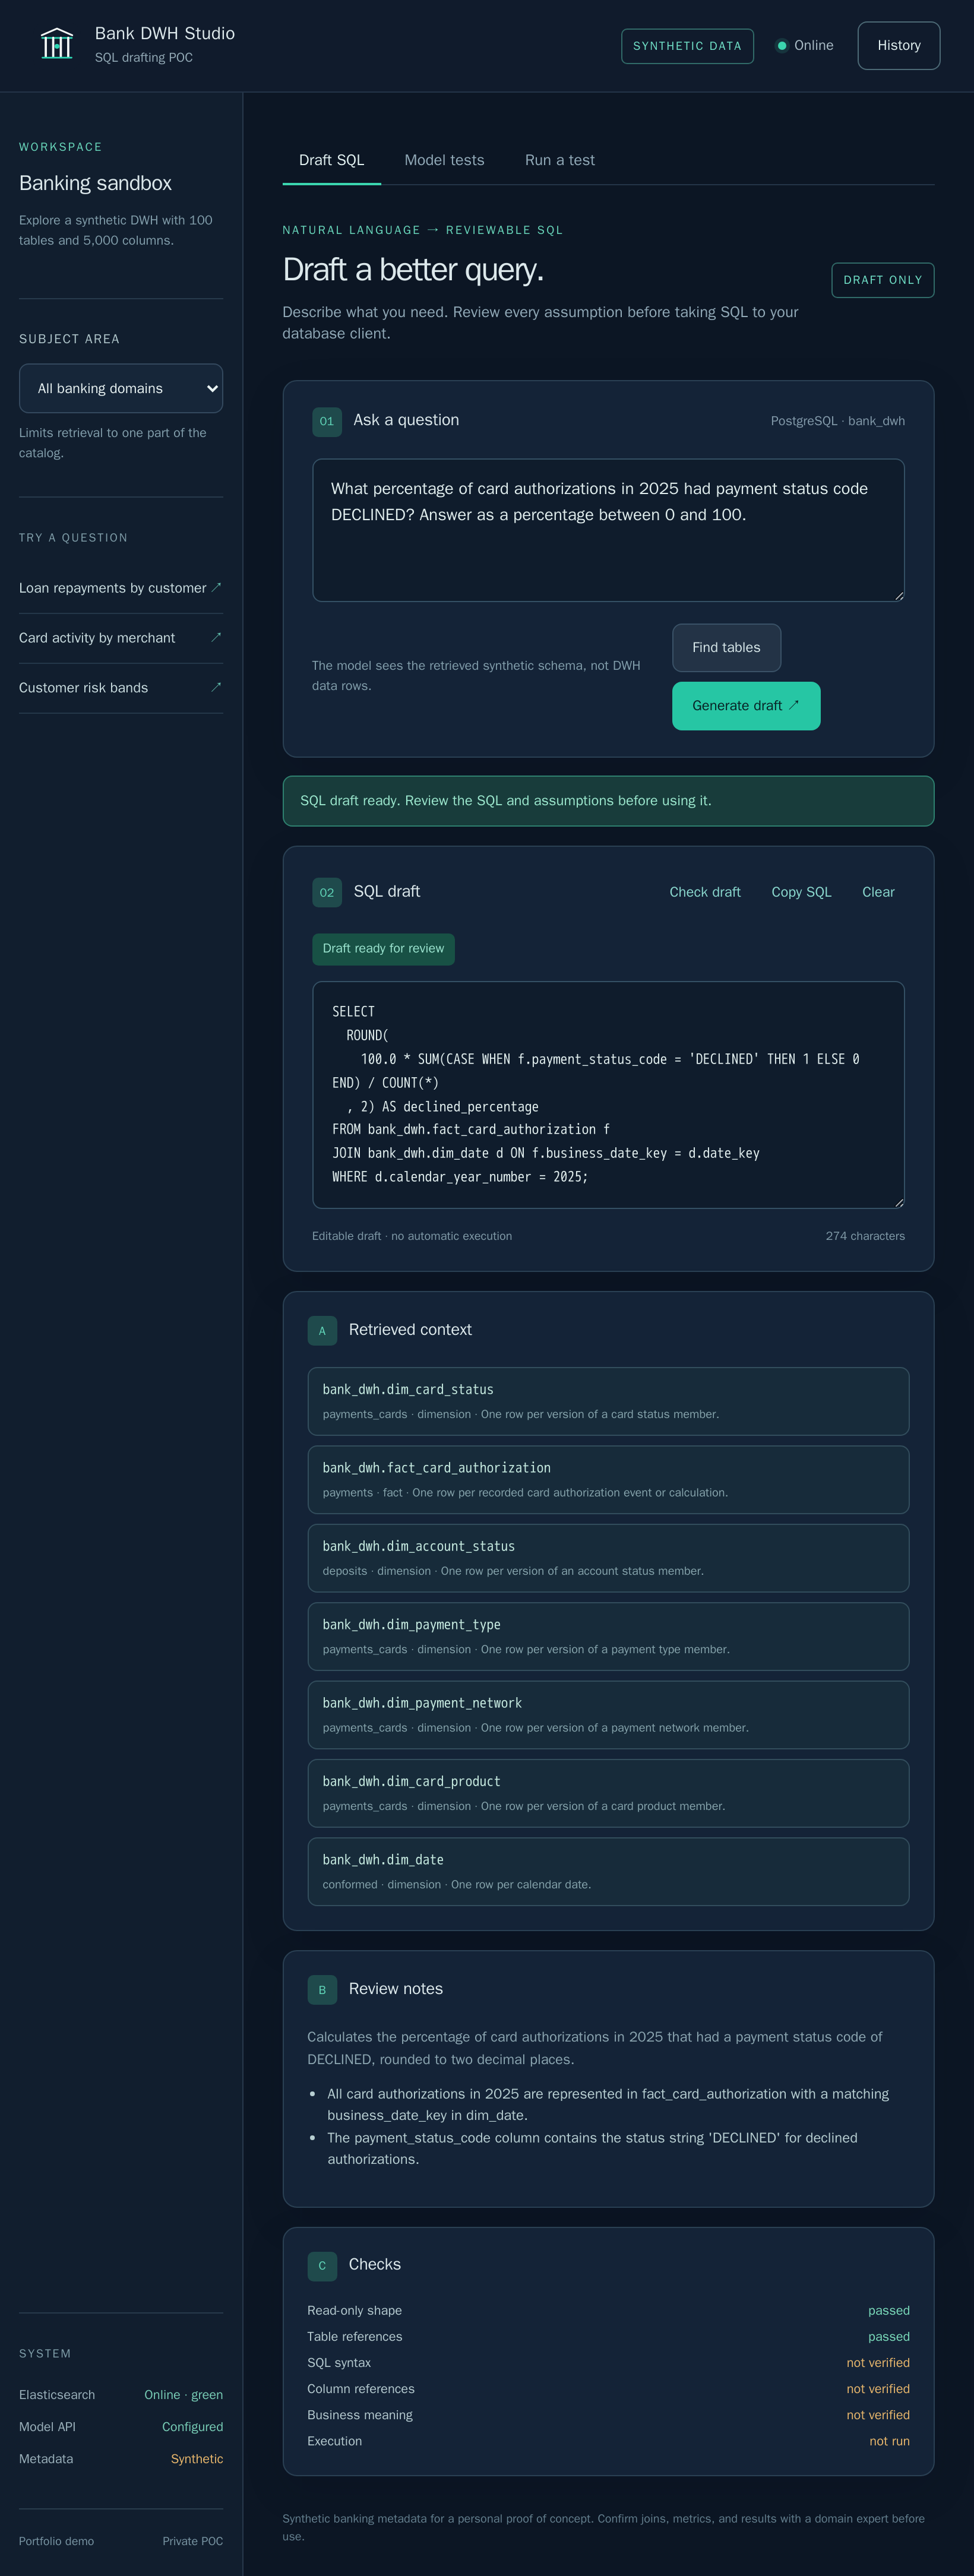
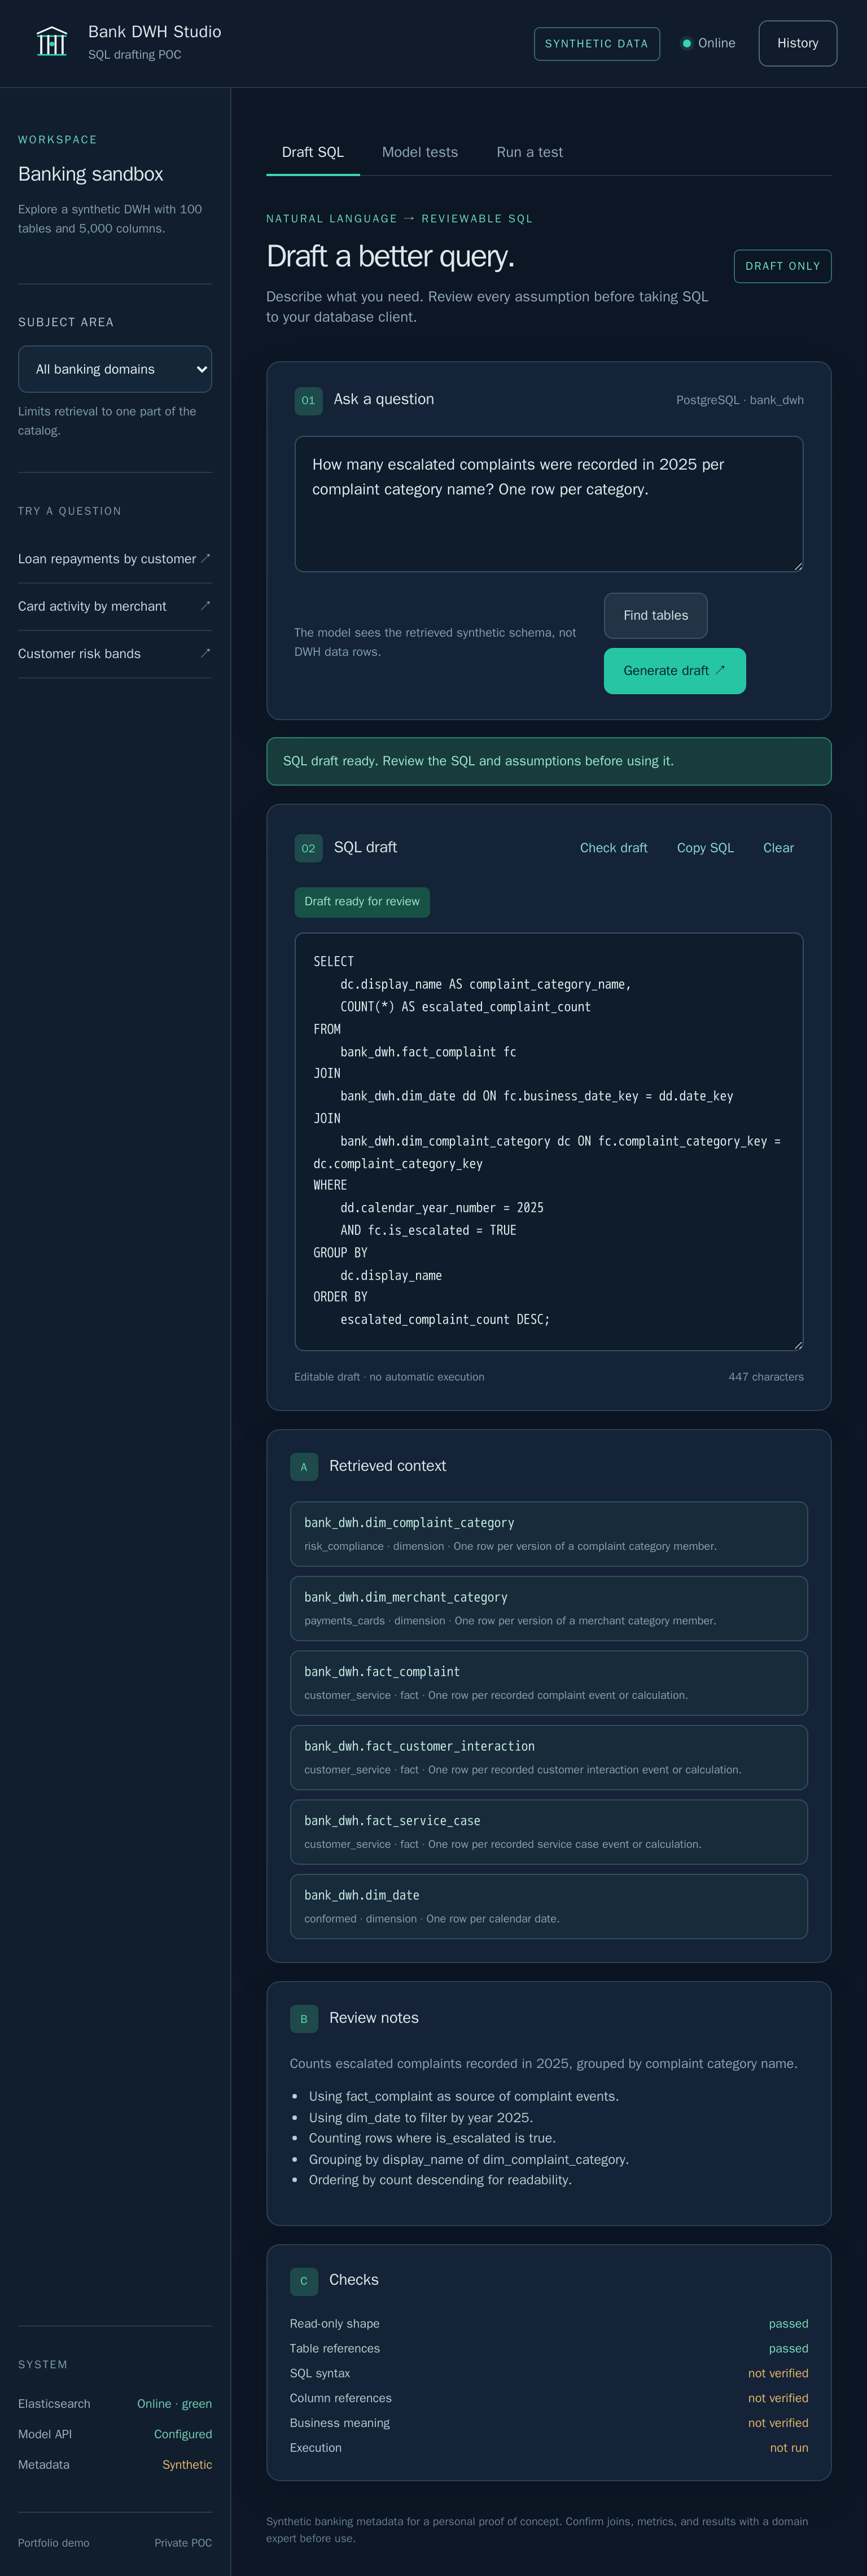
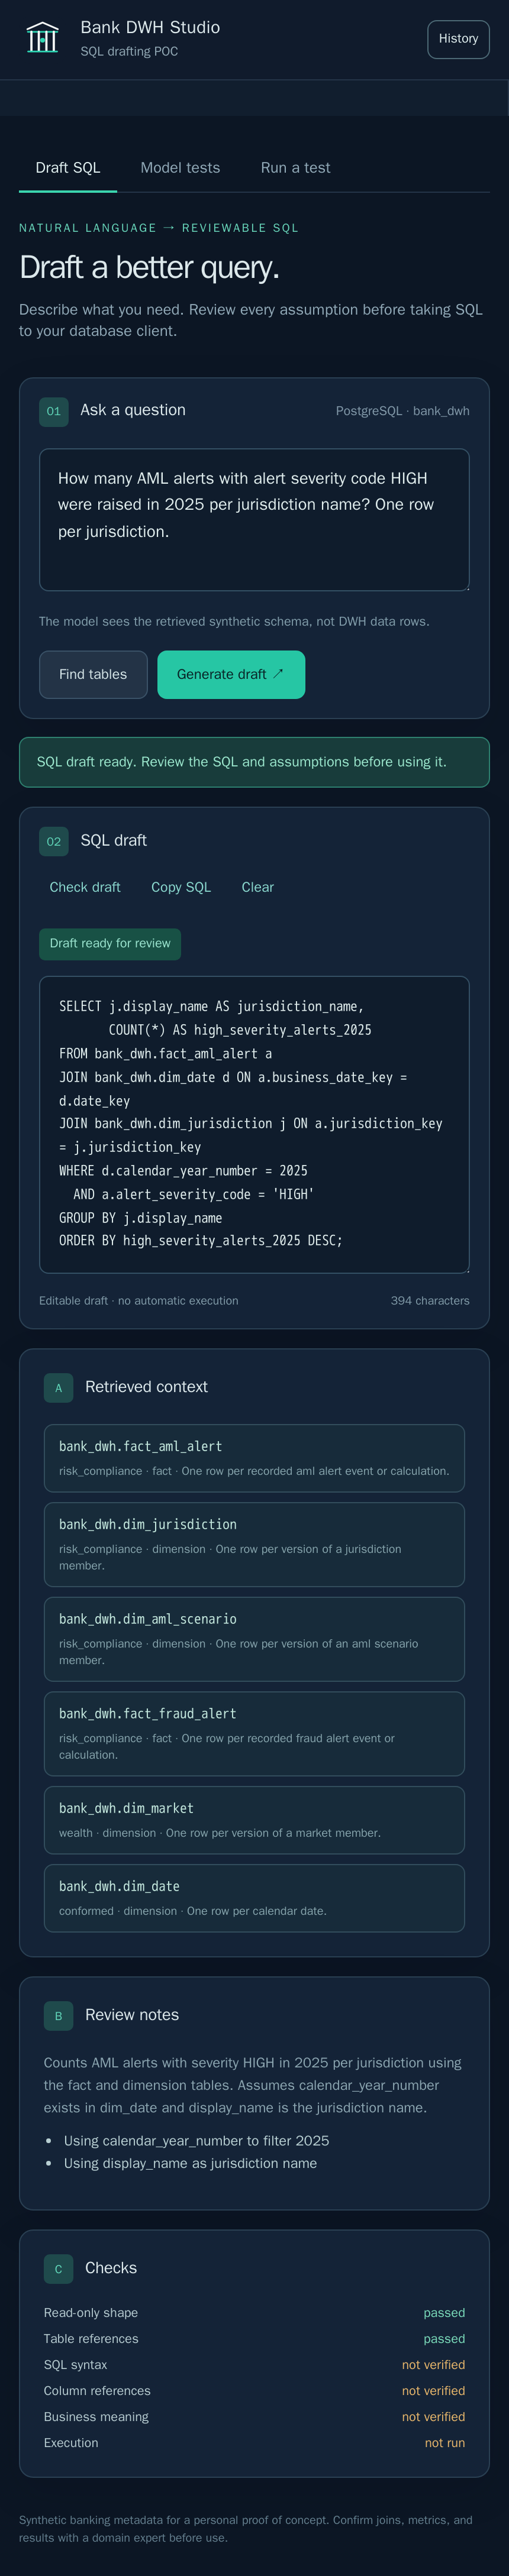
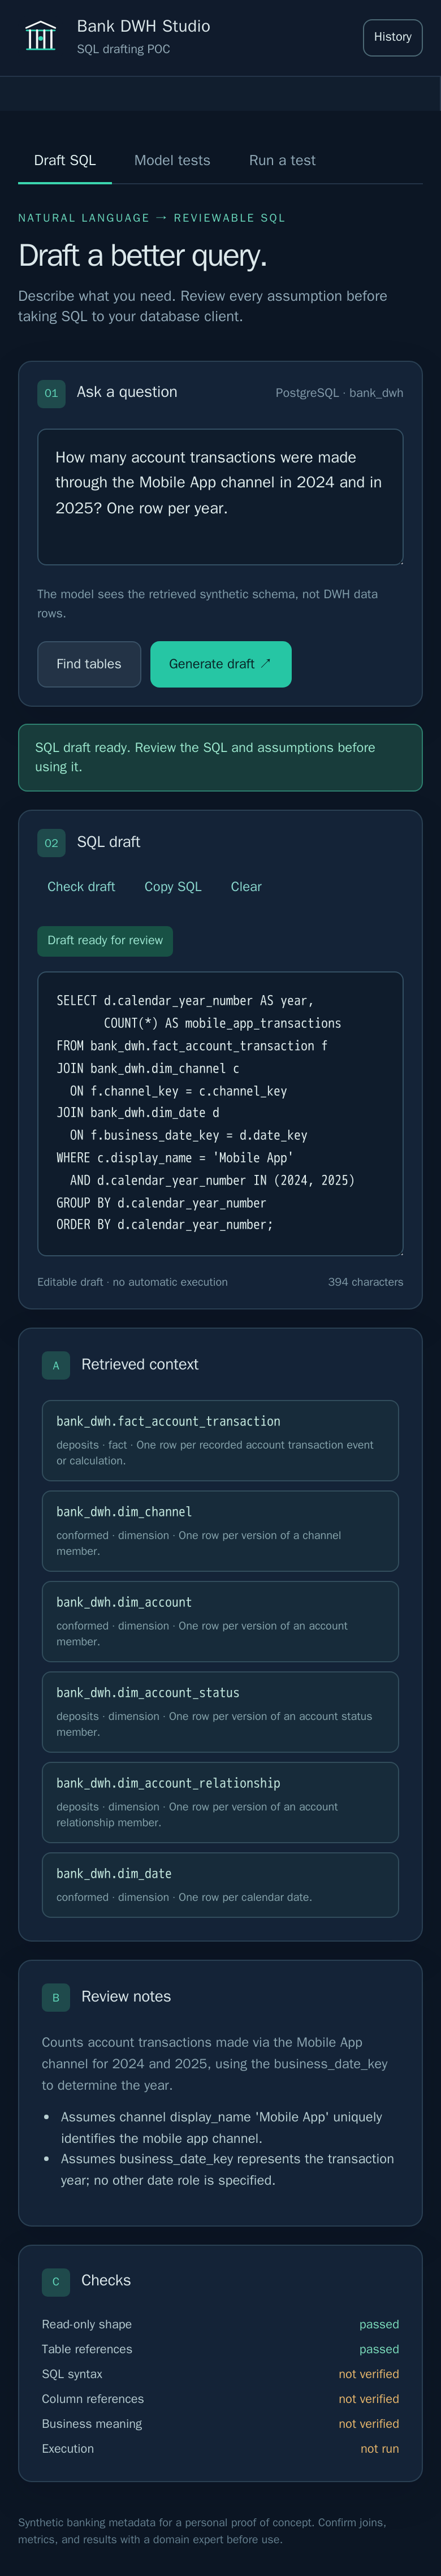
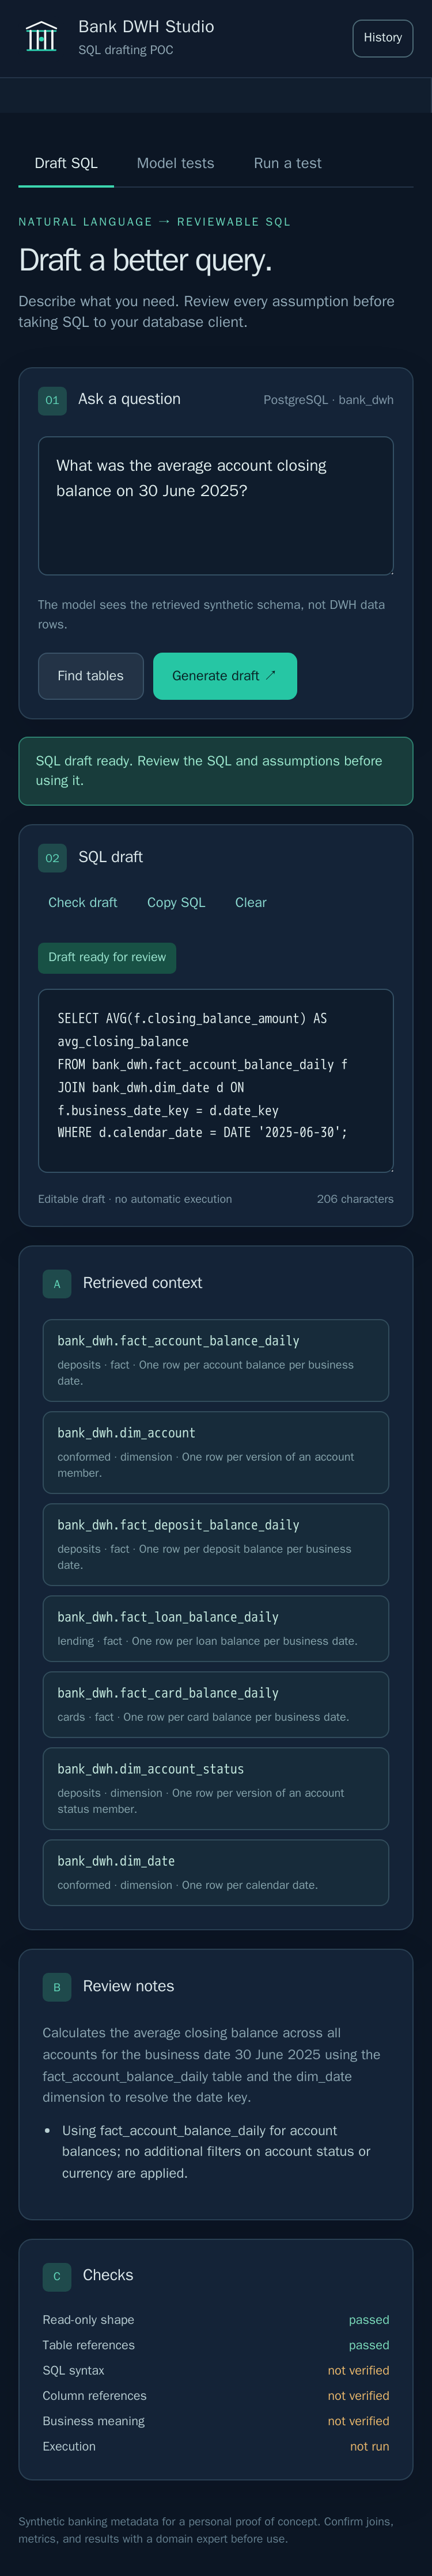
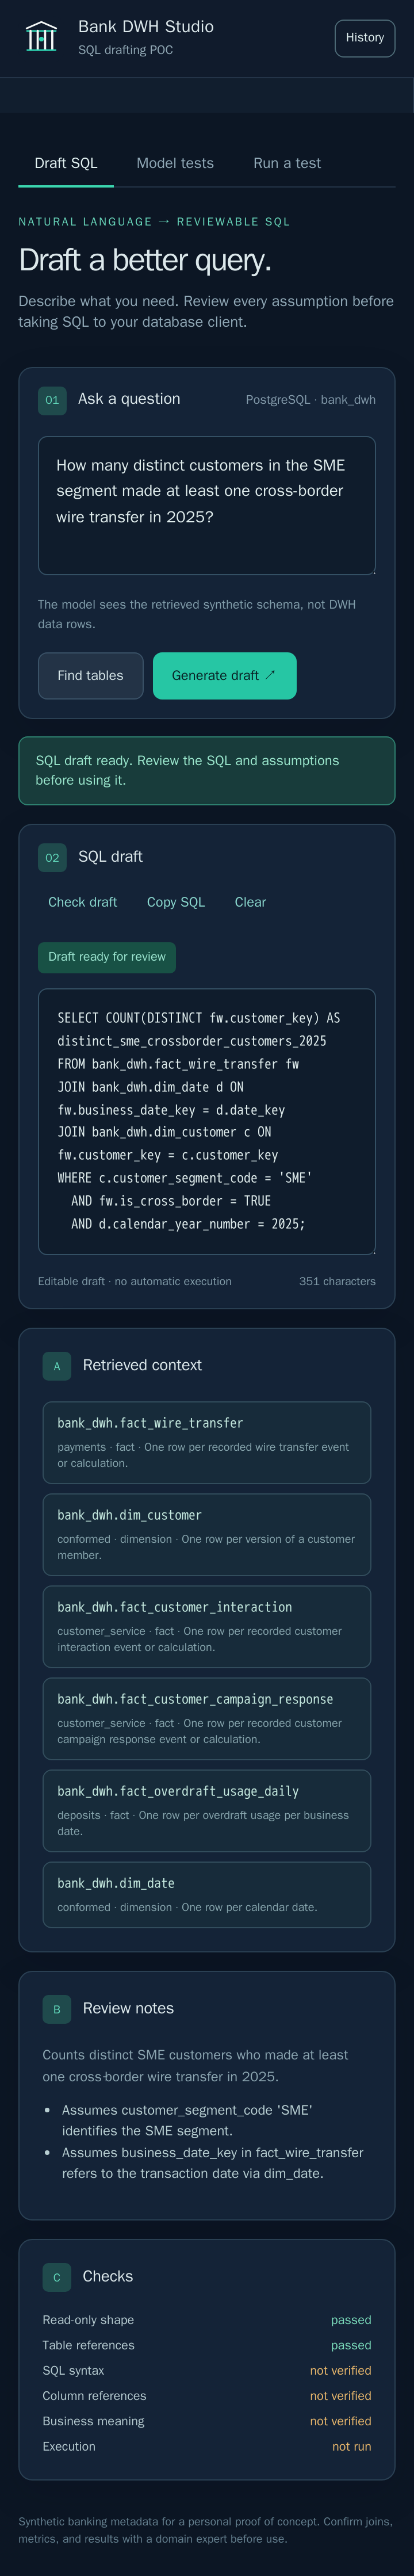
Застосунок пише й тестує чернетки SQL, але лише на синтетичній копії сховища, від імені користувача, який може лише читати; до справжнього банківського сховища він ніколи не під'єднується. Користувачі й далі перевіряють результат, потім редагують чи копіюють його та запускають у власному клієнті бази даних. Браузер ніколи не отримує API-ключ моделі.
Автоматичні перевірки охоплюють базову форму інструкції лише для читання та посилання на відомі таблиці. Синтаксис SQL, посилання на стовпці та бізнес-зміст усе одно потребують перевірки людиною. Усі назви, зв’язки та показники у сховищі є синтетичними тестовими матеріалами, а не затвердженими банківськими визначеннями.
Розгорнутий доказ концепції запускає бекенд на Node, Elasticsearch і сховище PostgreSQL лише для читання як контейнери без root на екземплярі Oracle Ampere A1 і складає SQL за допомогою gpt-oss-20b через хмарного постачальника. Репозиторій також описує ширшу майбутню архітектуру, чітко відокремлену від меншого розгорнутого POC.
Маленька консоль для керування запрошеннями та пристроями в приватних вебзастосунках.
Маленька складова, що допомагає вебзастосункам працювати офлайн і залишатися актуальними.
Покажіть, куди все рухається. Створюйте й експортуйте діаграми у браузері.