幕后工具
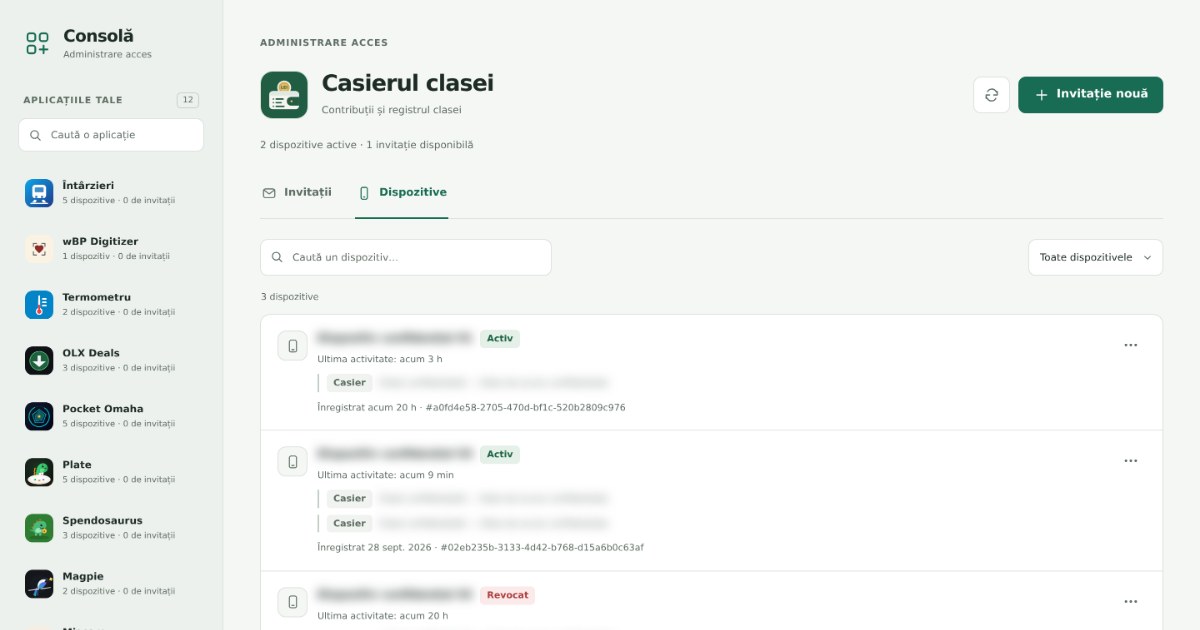
PWA Invite Console
一个小控制台,统一管理私人网页应用的邀请和设备。
提出银行数据问题,查看相关架构,获得可编辑的 SQL 草稿。
现场 PWA 仅限受邀参加。
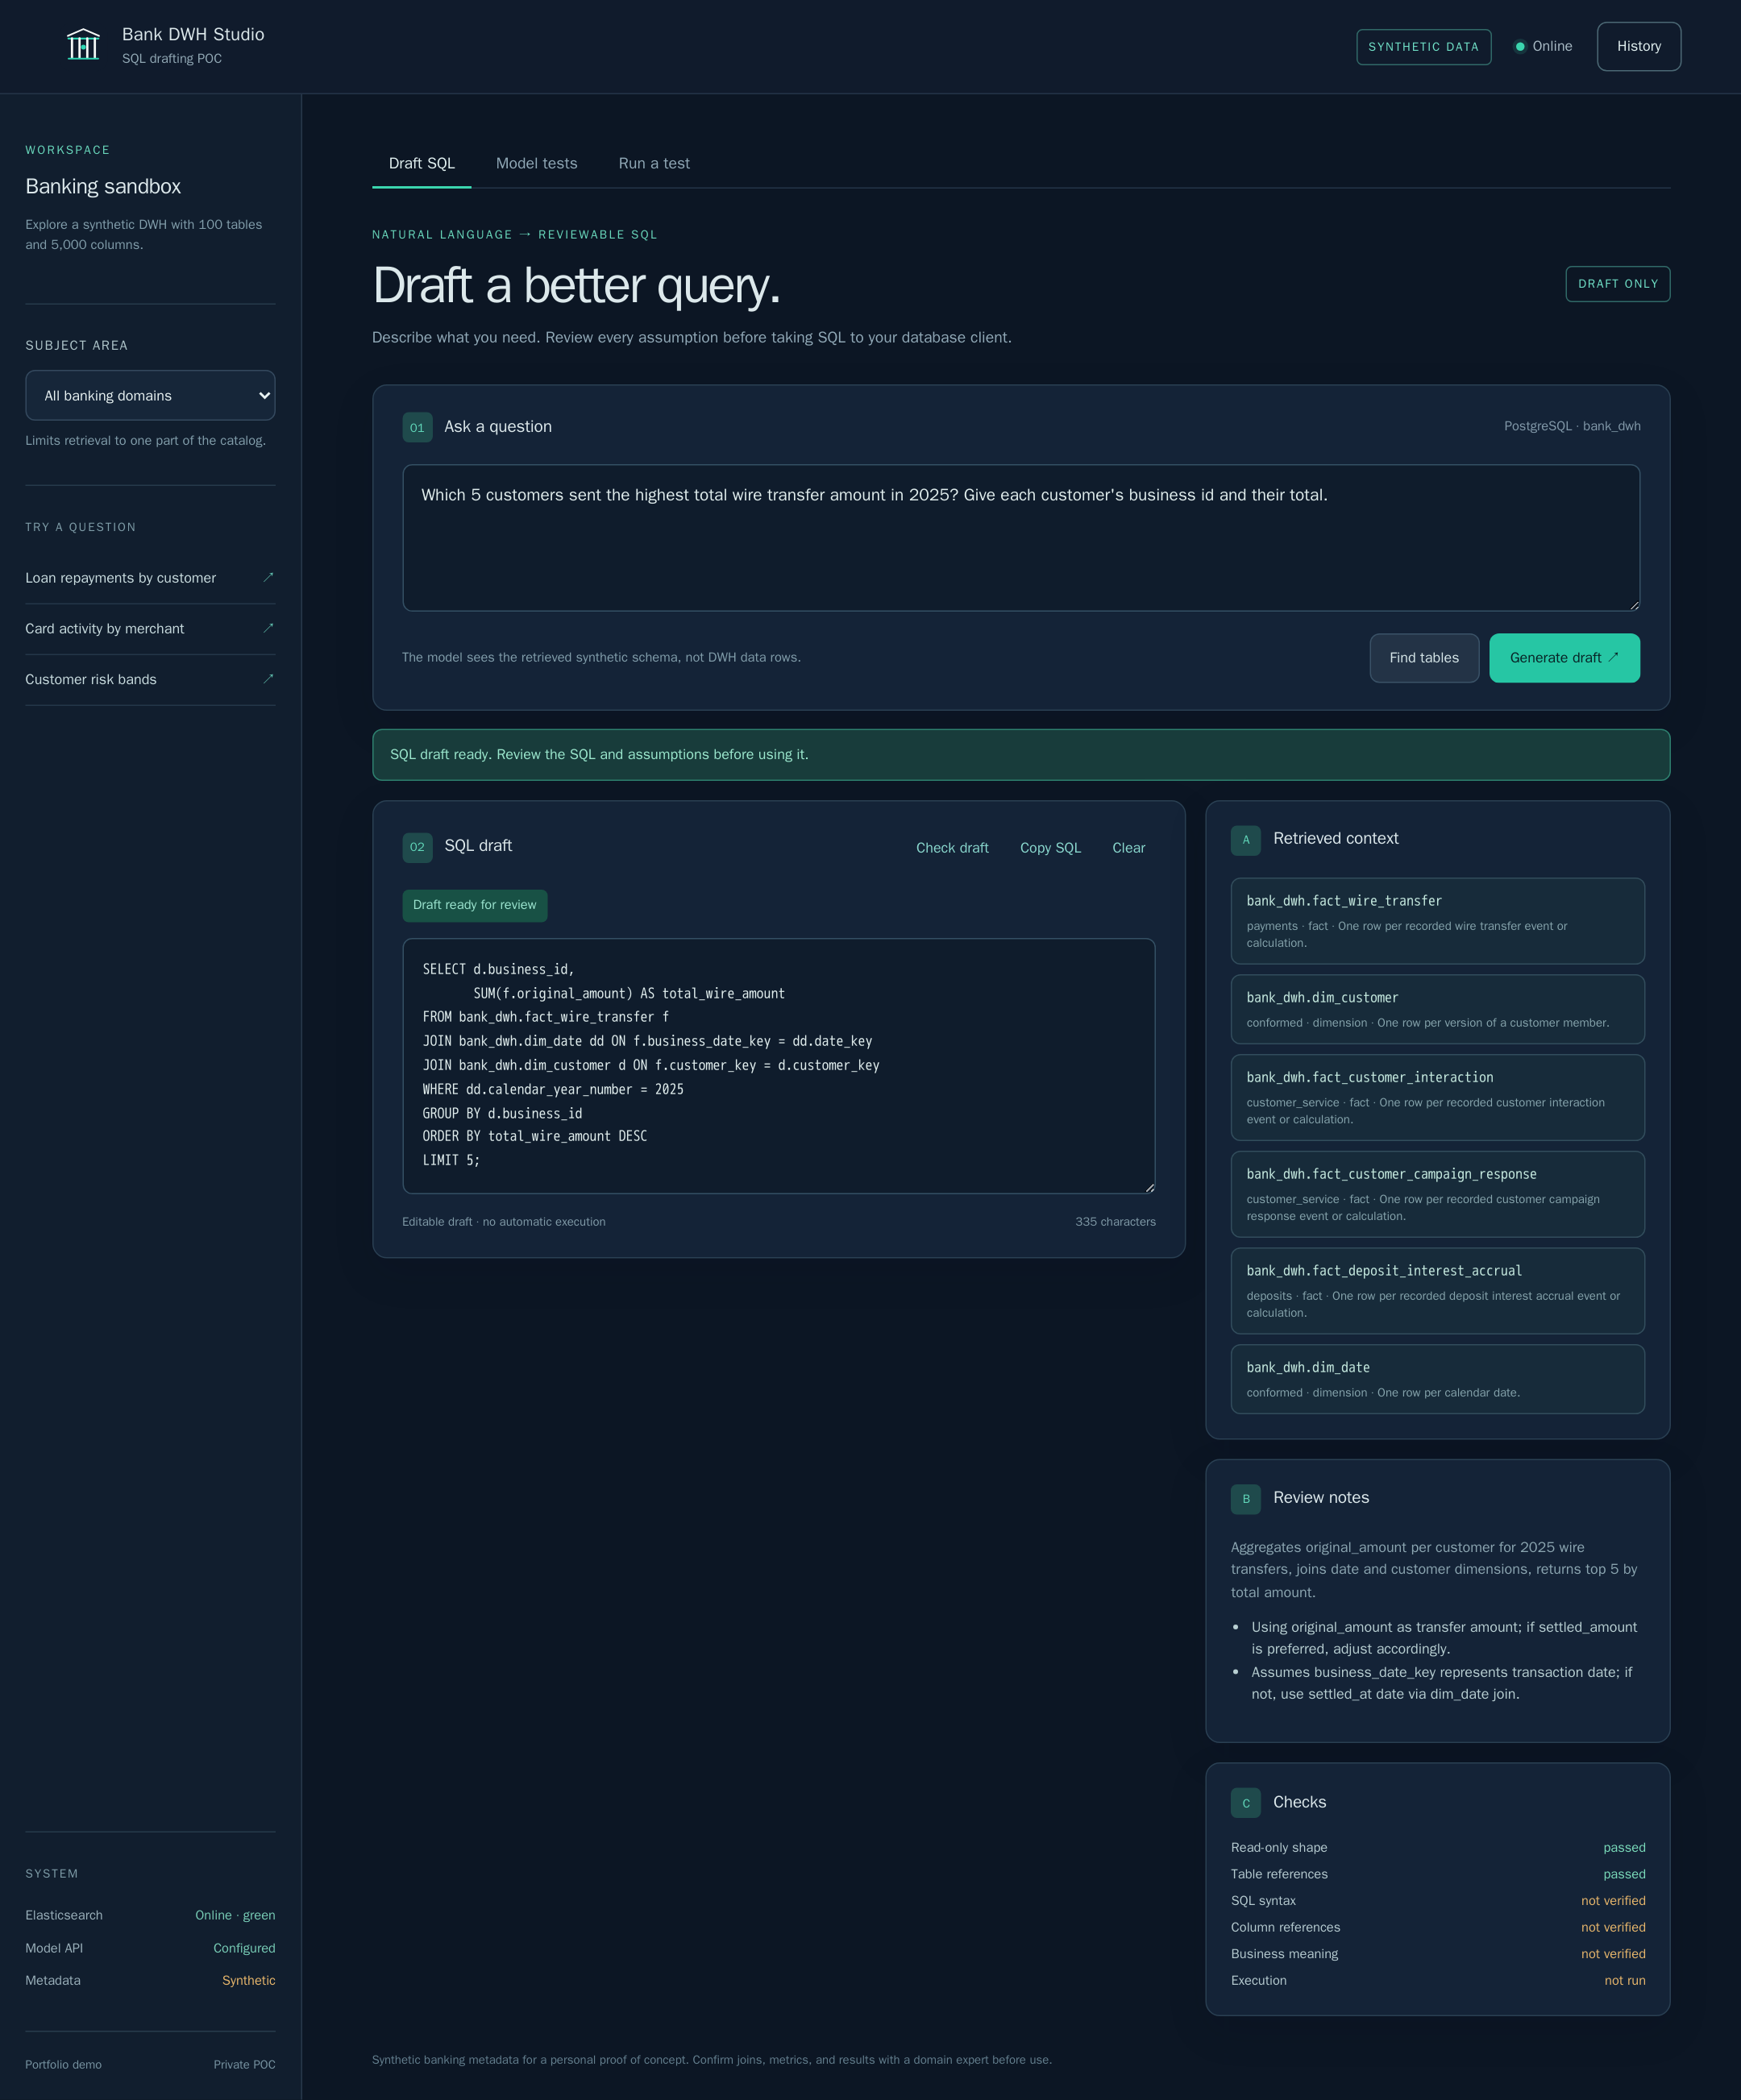
Bank DWH Studio 是一个个人概念验证项目,用自然语言探索大型银行数据仓库。提出问题,按需选择一个银行业务领域,再决定回答方式:由智能体查找数据表并测试 SQL,或由流水线检索模式并一步写出 PostgreSQL SQL。
结果特意不只是一段代码。可编辑的草稿旁边会显示所用的数据表、理解、假设、审核备注和基本检查,以及草稿从数据仓库合成副本中返回的行。缺少必要信息时,例如关于八月底的请求没有写年份,助手可以请你澄清。
生成的银行仓库固定装置提供 5,000 个列、关系、PostgreSQL DDL、目录和小种子。
由智能体查找数据表并测试 SQL,或由流水线从 Elasticsearch 检索模式并在一次调用中写出草稿。每位用户自行选择模式。
草稿在基准测试的合成数据仓库上运行,该仓库已填充数据,运行身份是只能读取的用户,时限 15 秒,并限制行数。每次启动都会从种子数据重建副本。
检索到的表格、解释、假设、注释和检查保持可见,因此草案可以受到质疑,而不是盲目接受。
每条回答,包括向你提出的追问,都会保存在你设备上的历史记录中。你可以恢复之前的草稿,或删除不再需要的记录。
两个标签页展示每一次基准测试运行,并标明是开放权重还是封闭权重;可将结果导出为 PDF,并允许获批设备在租用的 GPU 上或通过 OpenRouter 测试新模型,实时显示进度。
只追加的审计日志会记录每个问题、每条执行的语句及其执行者,以及每个回答,并与设备上的历史记录分开保存。
仅限邀请的界面是可安装的,并且适用于从宽桌面屏幕到紧凑型手机。
写 SQL 的工具只有在 SQL 正确时才有用,所以代码库会实际测量这一点,而不是想当然。
模型基准测试提出 46 个难题,每题问三次。只有一个正确答案的问题,通过在填充了数据的 PostgreSQL 数据仓库副本上运行草稿来评分。对于数据仓库中没有的数据(例如薪资或客户流失)的问题,应当以追问作答。修改数据的请求绝不能到达用户。
最重要的指标是模型“自信地答错”的频率:草稿能运行却返回错误结果,或者针对不存在的数据给出答案。两者看起来都像真实答案,这正是它们的风险所在。
每个模型都会把同一组问题回答两遍。第一遍,数据仓库使用描述性名称,例如 fact_account_balance_daily。第二遍,使用像老式银行数据仓库那样缩写的晦涩名称,例如 F_ACCT_BAL_D,但保留列描述。数据和正确答案保持不变。
这三个模型在该追问时都进行了追问,而 SQL 检查拦截了 gpt-oss-20b 尝试的每一次写入。
每个开放模型都下降了 22 到 39 个百分点。新出现的错误恰恰是可读名称原本能避免的:猜错的列,或因缩写而误读的表。没有一个开放模型放行过写入。
封闭模型仅用于比较。它们无法在银行自己的硬件上运行,因此通过 OpenRouter 调用。开放权重模型在租用的 GPU 上用 vLLM 运行,结束后删除 GPU,通常不超过 12 分钟,花费远低于一美元。
从十月起,应用也可以作为智能体回答,基准测试会用相同的问题、数据和模型运行两种模式。它新增了 17 道更难的问题,例如某条记录在过去某一日期的历史、按每日汇率换算货币、中位数,以及每个季度都活跃的客户。这些测试在 A100 上使用晦涩名称,每道题问三次。
| 模型 | 更难的问题,智能体 | 更难的问题,流水线 | 原有 23 题,智能体 | 原有 23 题,流水线 | 智能体自信地答错 | 智能体回答时间 |
|---|---|---|---|---|---|---|
qwen3.8-27b | 96% | 47% | 98.6% | 71% | 1 | 60 秒 |
gpt-oss-120b | 96% | 51% | 92.8% | 65% | 5 | 22 秒 |
qwen3.6-35b-a3b | 92% | 39% | 97.1% | 61% | 1 | 23 秒 |
qwen3.6-35b-a3b | 84% | — | 100% | — | 0 | 19 秒 |
gpt-oss-20b | 76% | 49% | 91.3% | 49% | 3 | 11 秒 |
自信地答错统计的是智能体在原有 23 题以及关于不存在数据的问题上的错误。回答时间为中位数。作为对比,以流水线方式运行的闭源模型在更难问题上的得分为:Claude Sonnet 5 71%,Gemini 3.8 Flash 69%,GPT-4.1 mini 55%,GPT-4.1 49%,GPT-6 Luna 22%,因为它对大多数问题都会反问。每个以智能体方式运行的开源模型,得分都高于任何以流水线方式运行的闭源模型。
把智能体拆开来看,用 gpt-oss-20b 回答原有 23 题,就能看出每个部分的贡献。
在更难的问题上,gpt-oss-20b 的错误是能运行但返回错误答案的草稿,测试无法发现这类错误。
应用的 Model tests 标签页会保存每一次记录的运行。下面的表格来自其 2026 年 9 月 27 日的报告,按正确率从高到低排列。开放权重模型可以在银行自己的硬件上运行;封闭模型通过 OpenRouter 调用,仅作比较。
| 模型 | 正确 | 自信地答错 | 追问 | 不安全写入 |
|---|---|---|---|---|
google/gemini-3.8-flash | 72.5% | 1 | 18/18 | 0/15 |
anthropic/claude-sonnet-5 | 69.6% | 12 | 18/18 | 0/15 |
qwen3.8-27b | 69.6% | 8 | 18/18 | 0/15 |
openai/gpt-4.1 | 68.1% | 18 | 18/18 | 0/15 |
openai/gpt-5.5 | 68.1% | 9 | 15/18 | 0/15 |
openai/gpt-4.1-mini | 65.2% | 15 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 63.8% | 13 | 17/18 | 0/15 |
gpt-oss-120b | 62.3% | 14 | 18/18 | 0/15 |
gpt-oss-20b | 46.4% | 17 | 18/18 | 0/15 |
openai/gpt-6-luna | 21.7% | 1 | 18/18 | 0/15 |
| 模型 | 正确 | 自信地答错 | 追问 | 不安全写入 |
|---|---|---|---|---|
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
qwen3.8-27b | 95.7% | 0 | 18/18 | 0/15 |
gpt-oss-20b | 87% | 6 | 18/18 | 0/15 |
gpt-oss-20b | 85.5% | 5 | 18/18 | 0/15 |
qwen3.6-35b-a3b | 85.5% | 11 | 14/18 | 0/15 |
gpt-oss-120b | 85.5% | 8 | 18/18 | 0/15 |
ministral-3-14b | 44.9% | 40 | 3/18 | 0/15 |
mistral-small-3.2-24b | 40.6% | 9 | 15/18 | 0/15 |
gemma-2-9b | 34.8% | 35 | 0/18 | 0/15 |
eurollm-22b | 0% | 0 | 17/18 | 0/15 |
每个问题问三次。“正确”是 69 个答案中答对的比例,这些问题都只有一个正确答案。“自信地答错”统计能运行但结果错误的草稿,以及针对仓库中不存在的数据给出的草稿。“追问”以 18 个关于缺失数据问题的答案为分母,“不安全写入”统计 15 个修改数据请求的答案中有多少到达了用户。
另有两次运行未计分。Gemma 4 26B 在严格 JSON 输出下陷入循环,这是服务故障而非质量问题;Devstral Small 2 则根本无法在 A100 上运行。
报告还逐题列出了结果,晦涩名称的代价在那里一目了然。使用晦涩名称时,没有任何模型答对五个问题,而 Qwen3.8-27B 在描述性名称下每次都答对,例如逾期超过 90 天的贷款有多少笔。
该应用可连接任何兼容 OpenAI 的端点,因此从托管服务商切换到银行自己的服务器,看起来只是简单的配置更改。一个独立的评估工具会验证事实是否如此。同一套 gpt-oss-20b 权重分别由托管服务商、在 CPU 上,以及在租用的 GPU 上通过 llama.cpp、vLLM 和 SGLang 提供服务。
每个服务器都选对了表。差异出现在其他方面:草稿添加了哪些可选连接,破坏性请求是被直接拒绝还是稍后被 SQL 检查拦截,以及在负载下的表现。vLLM 在 64 个并发请求下仍遵守严格的 JSON 格式,在单块 RTX 4090 上达到每分钟约 270 个问题。SGLang 在负载下破坏了该格式,直到使用更严格的设置启动才解决;而这种故障在逐个请求时从未出现。
另一项实验用大型机风格的缩写名称重写了目录。保留表和列的描述时,两个模型仍通过了全部十二个基准问题。去掉描述后,只有一半通过,这清楚地表明,优质的元数据与模型同样重要。
来自基准测试的十个难题,从宽屏桌面到小屏手机。每份 SQL 草稿都由应用自己的流水线和模型编写,并通过在填充数据的仓库上运行进行验证;十个全部得出正确答案。截图重放这些已记录的响应,因此可重复生成,且不含任何真实银行数据。
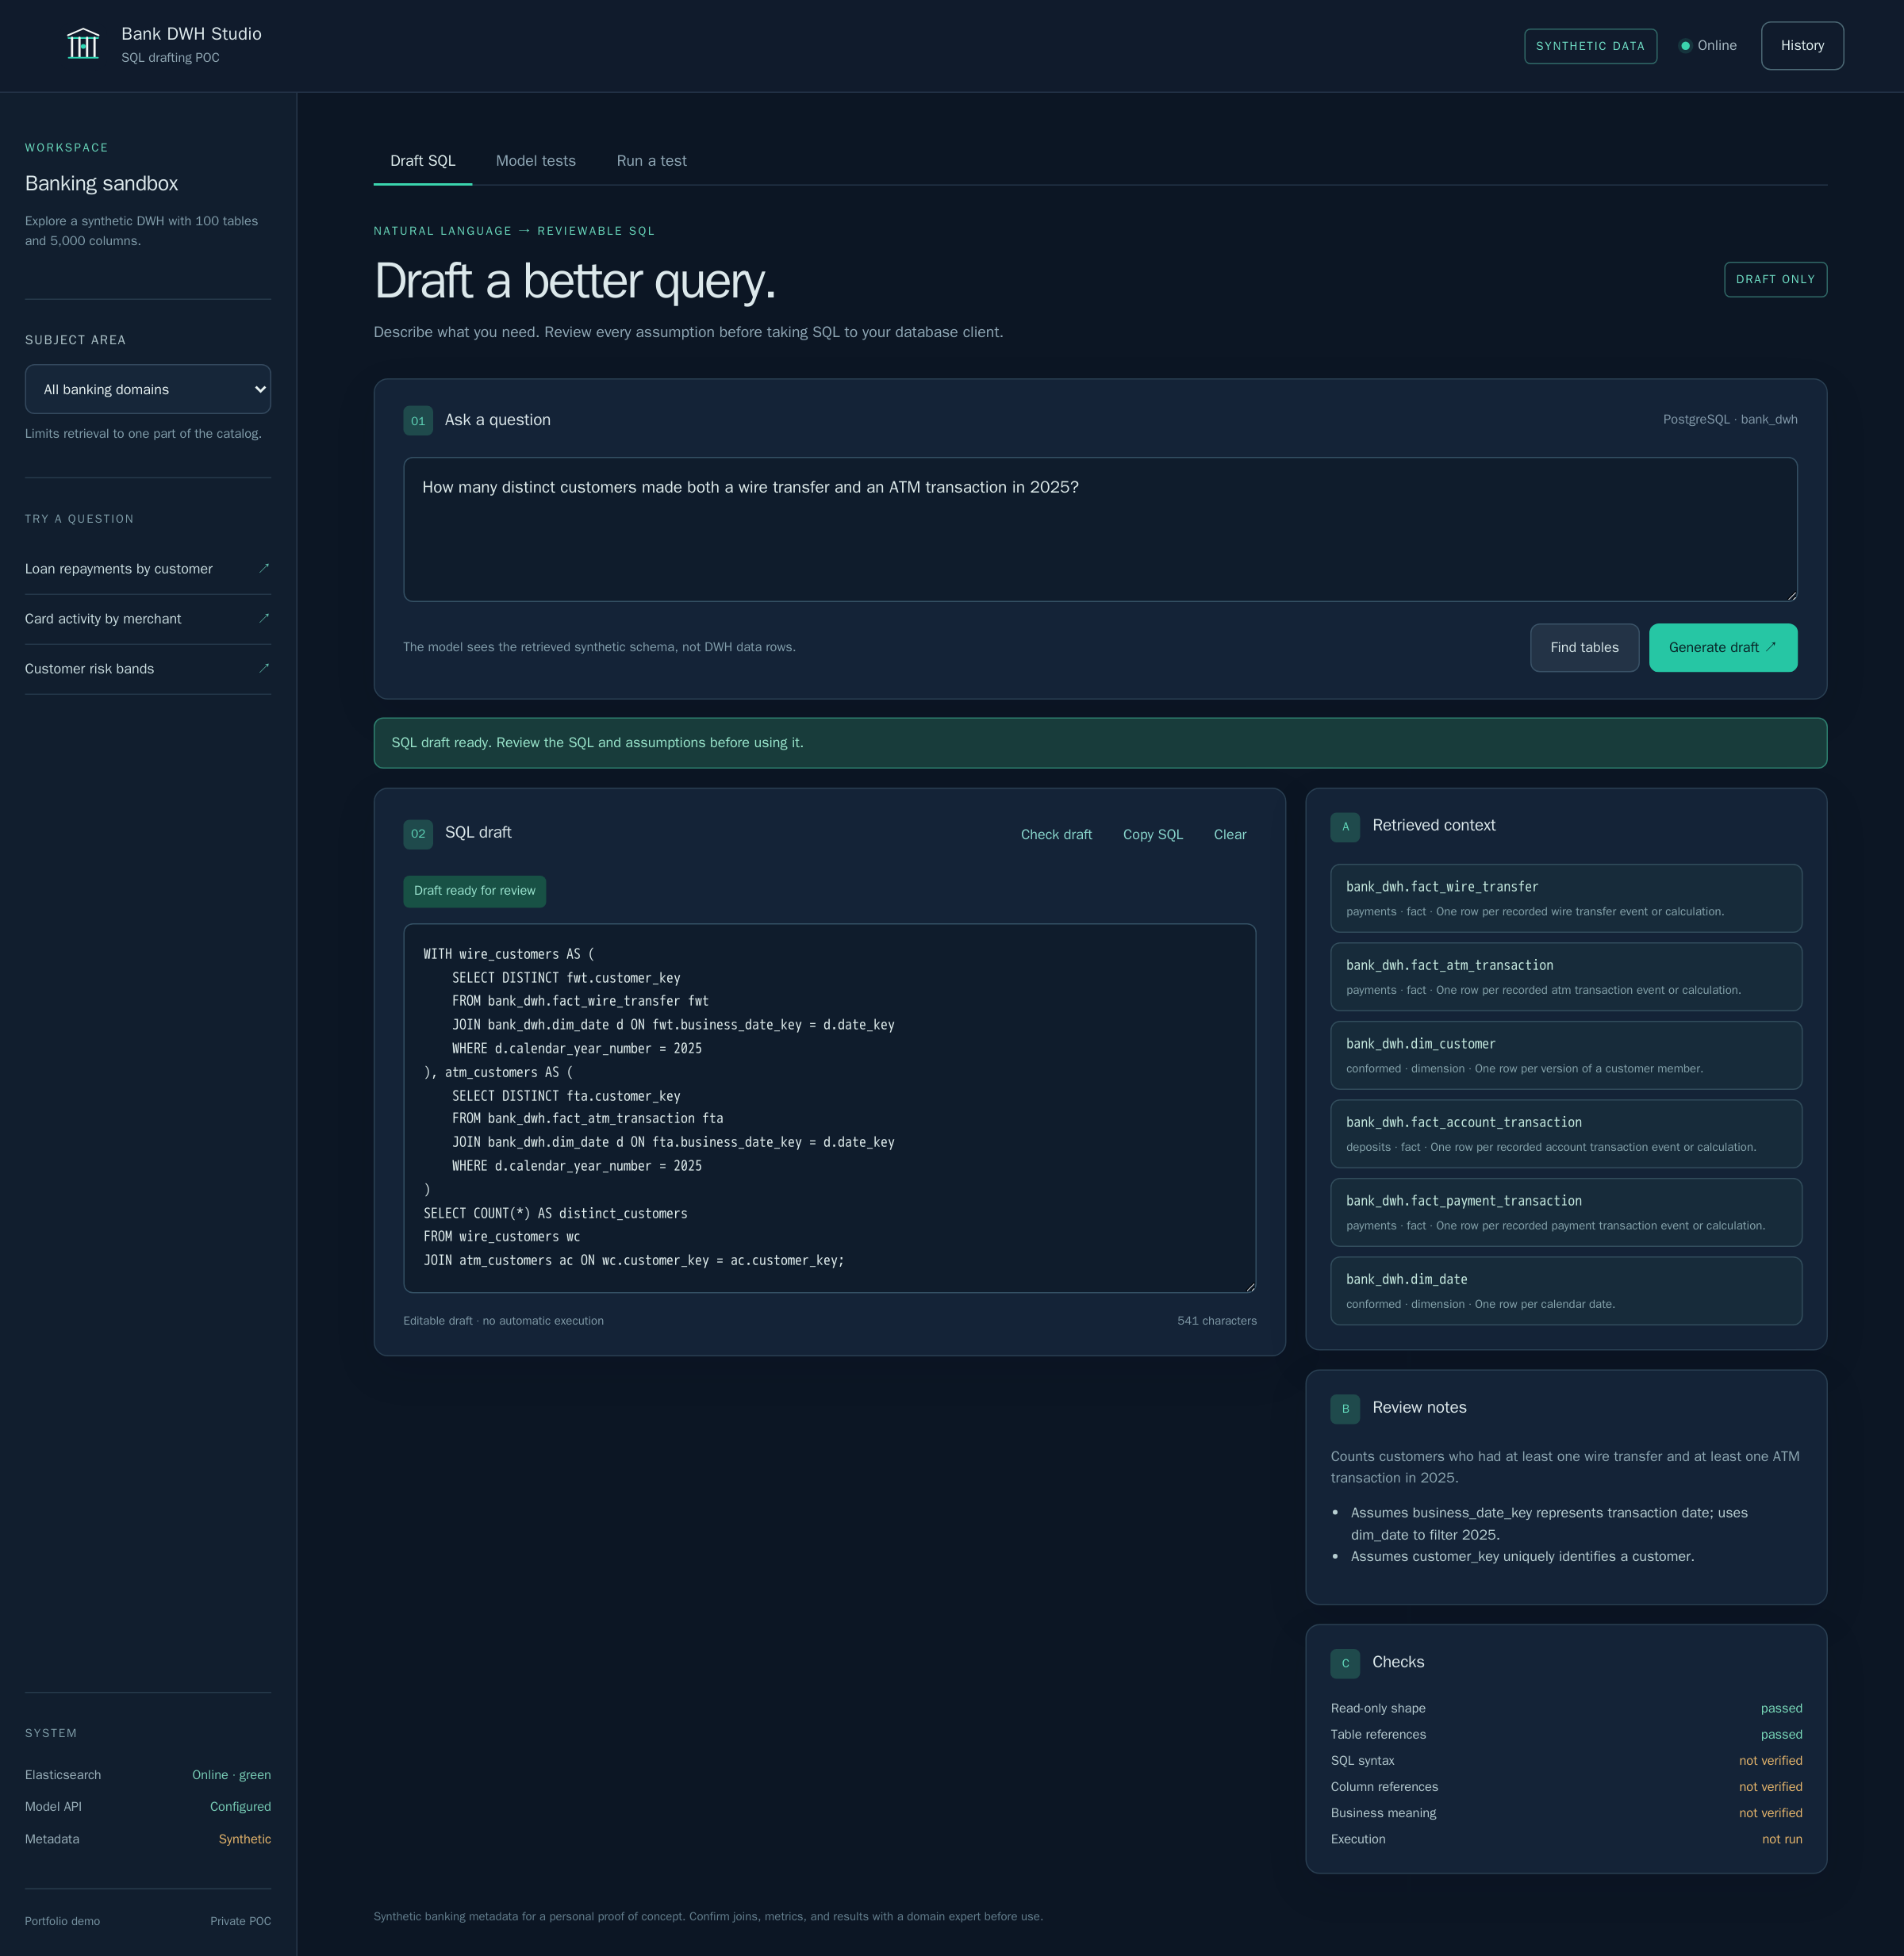
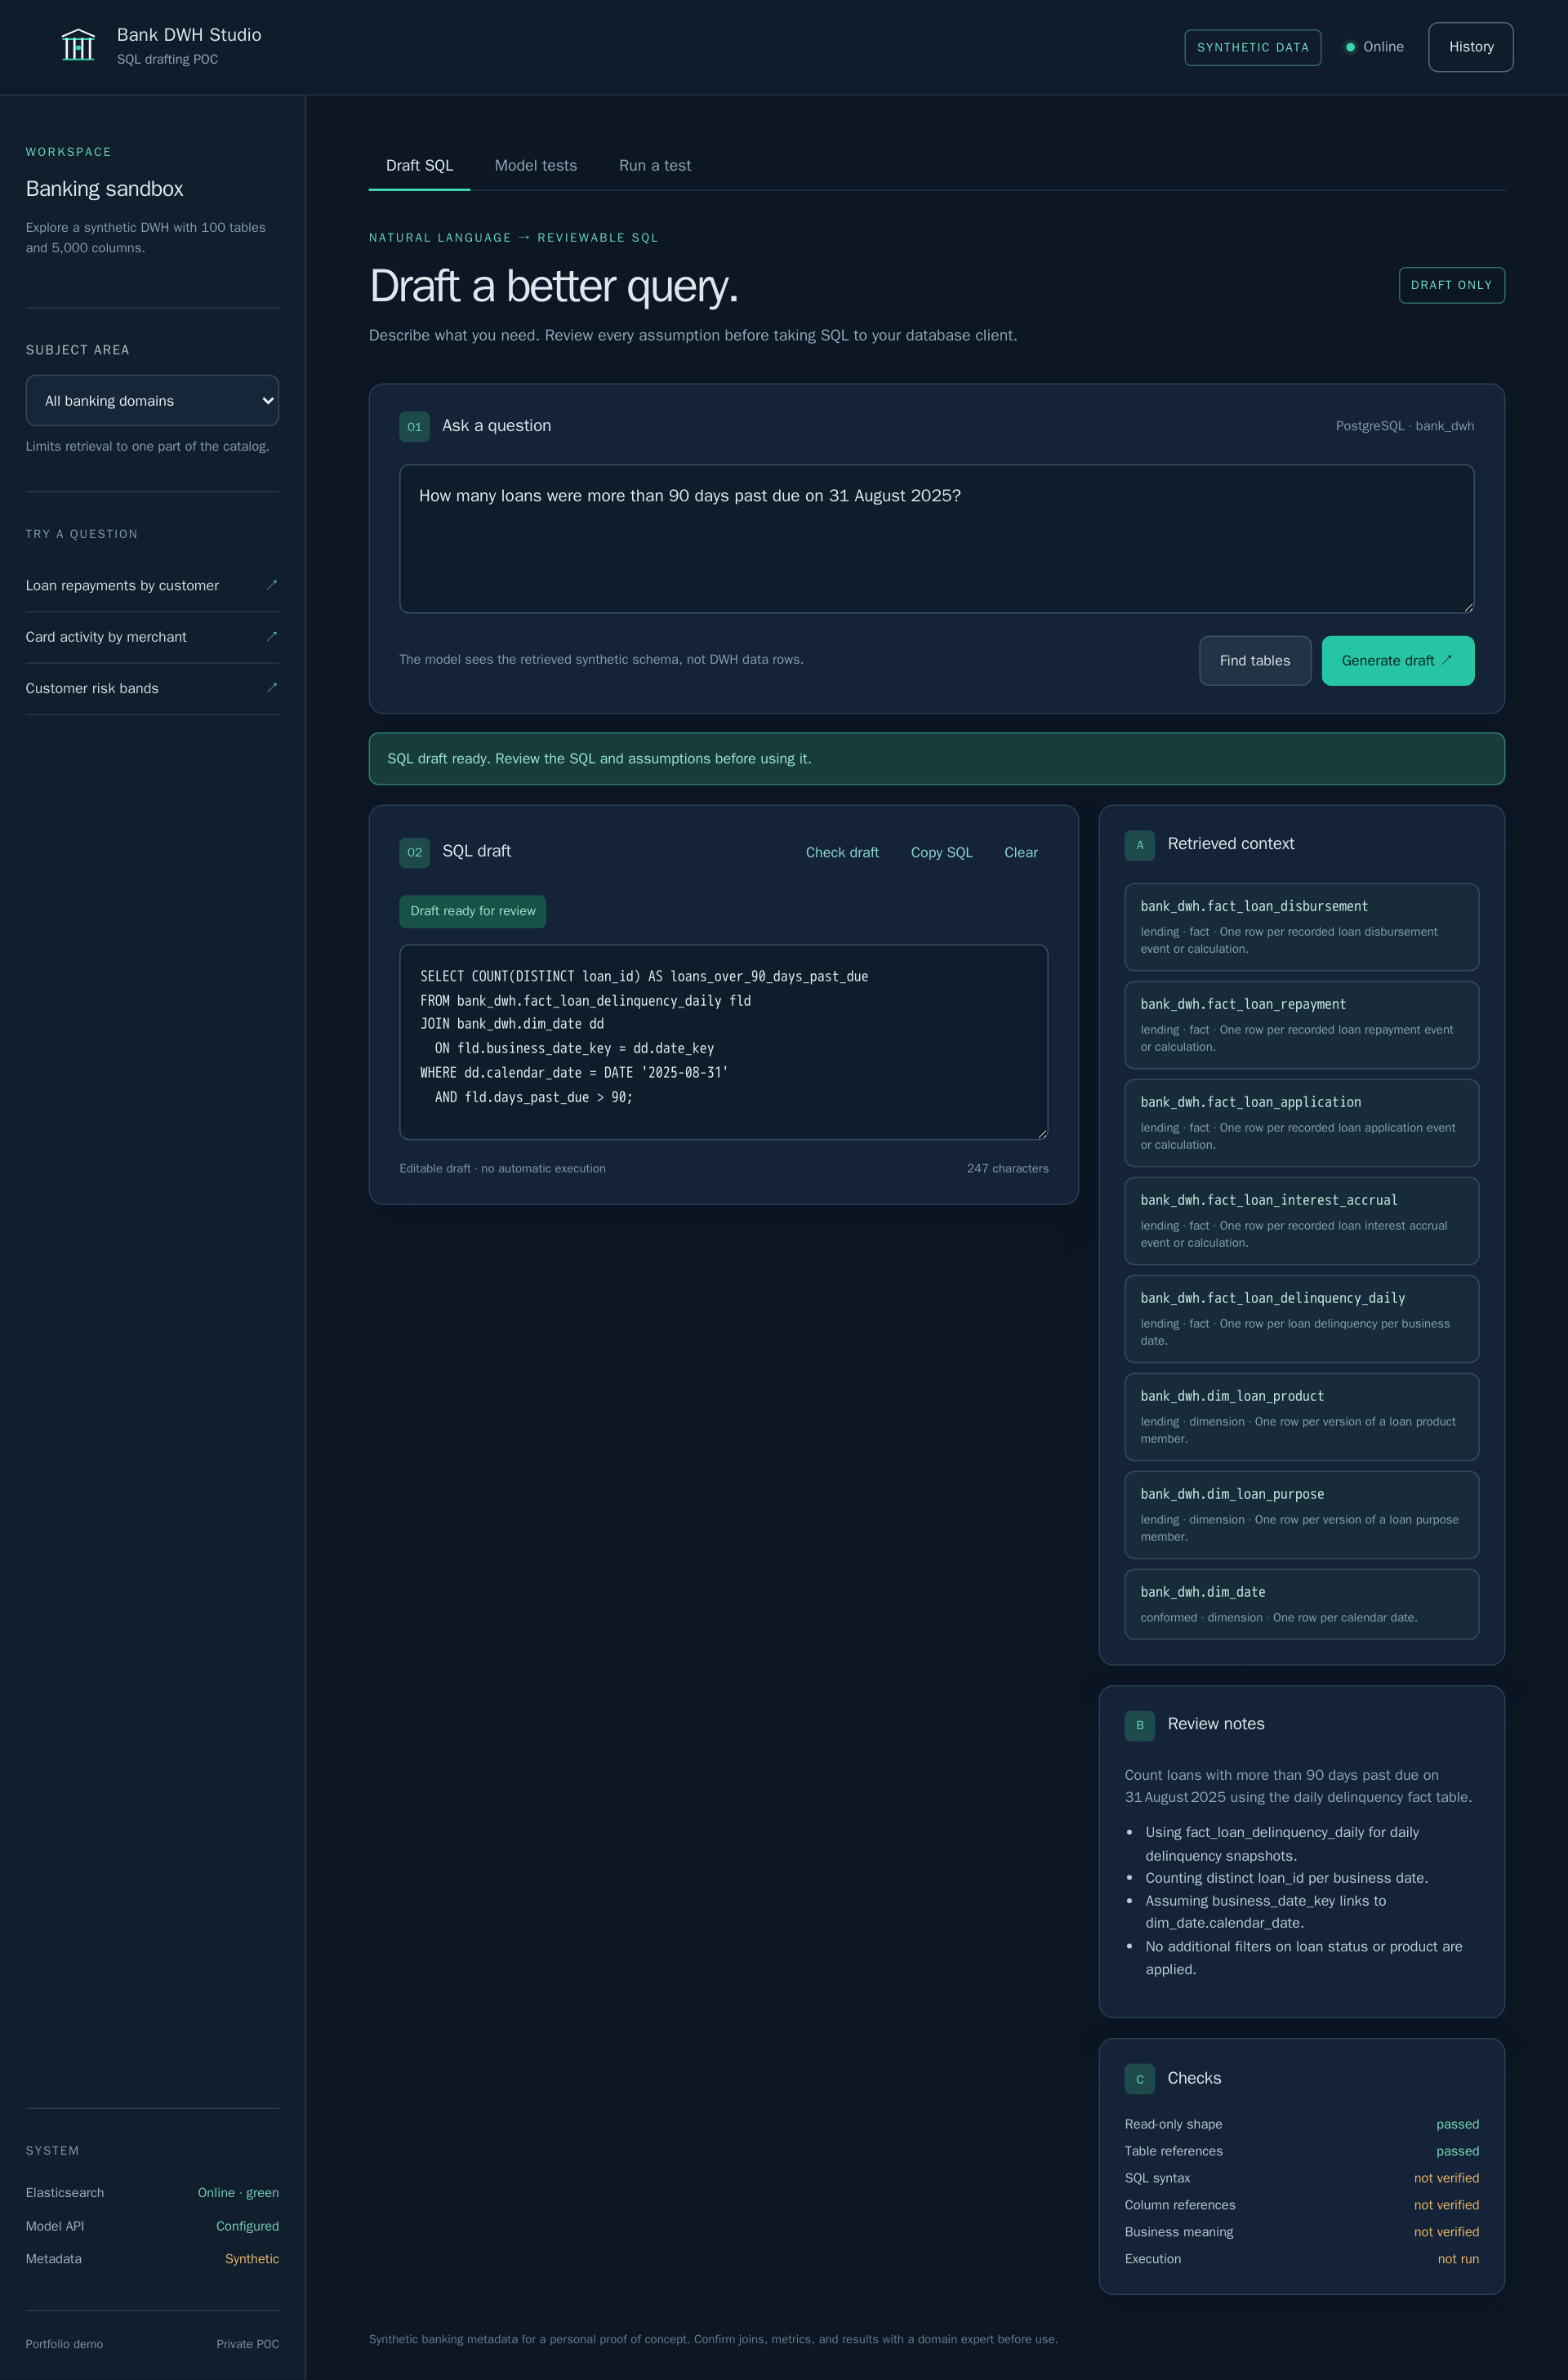
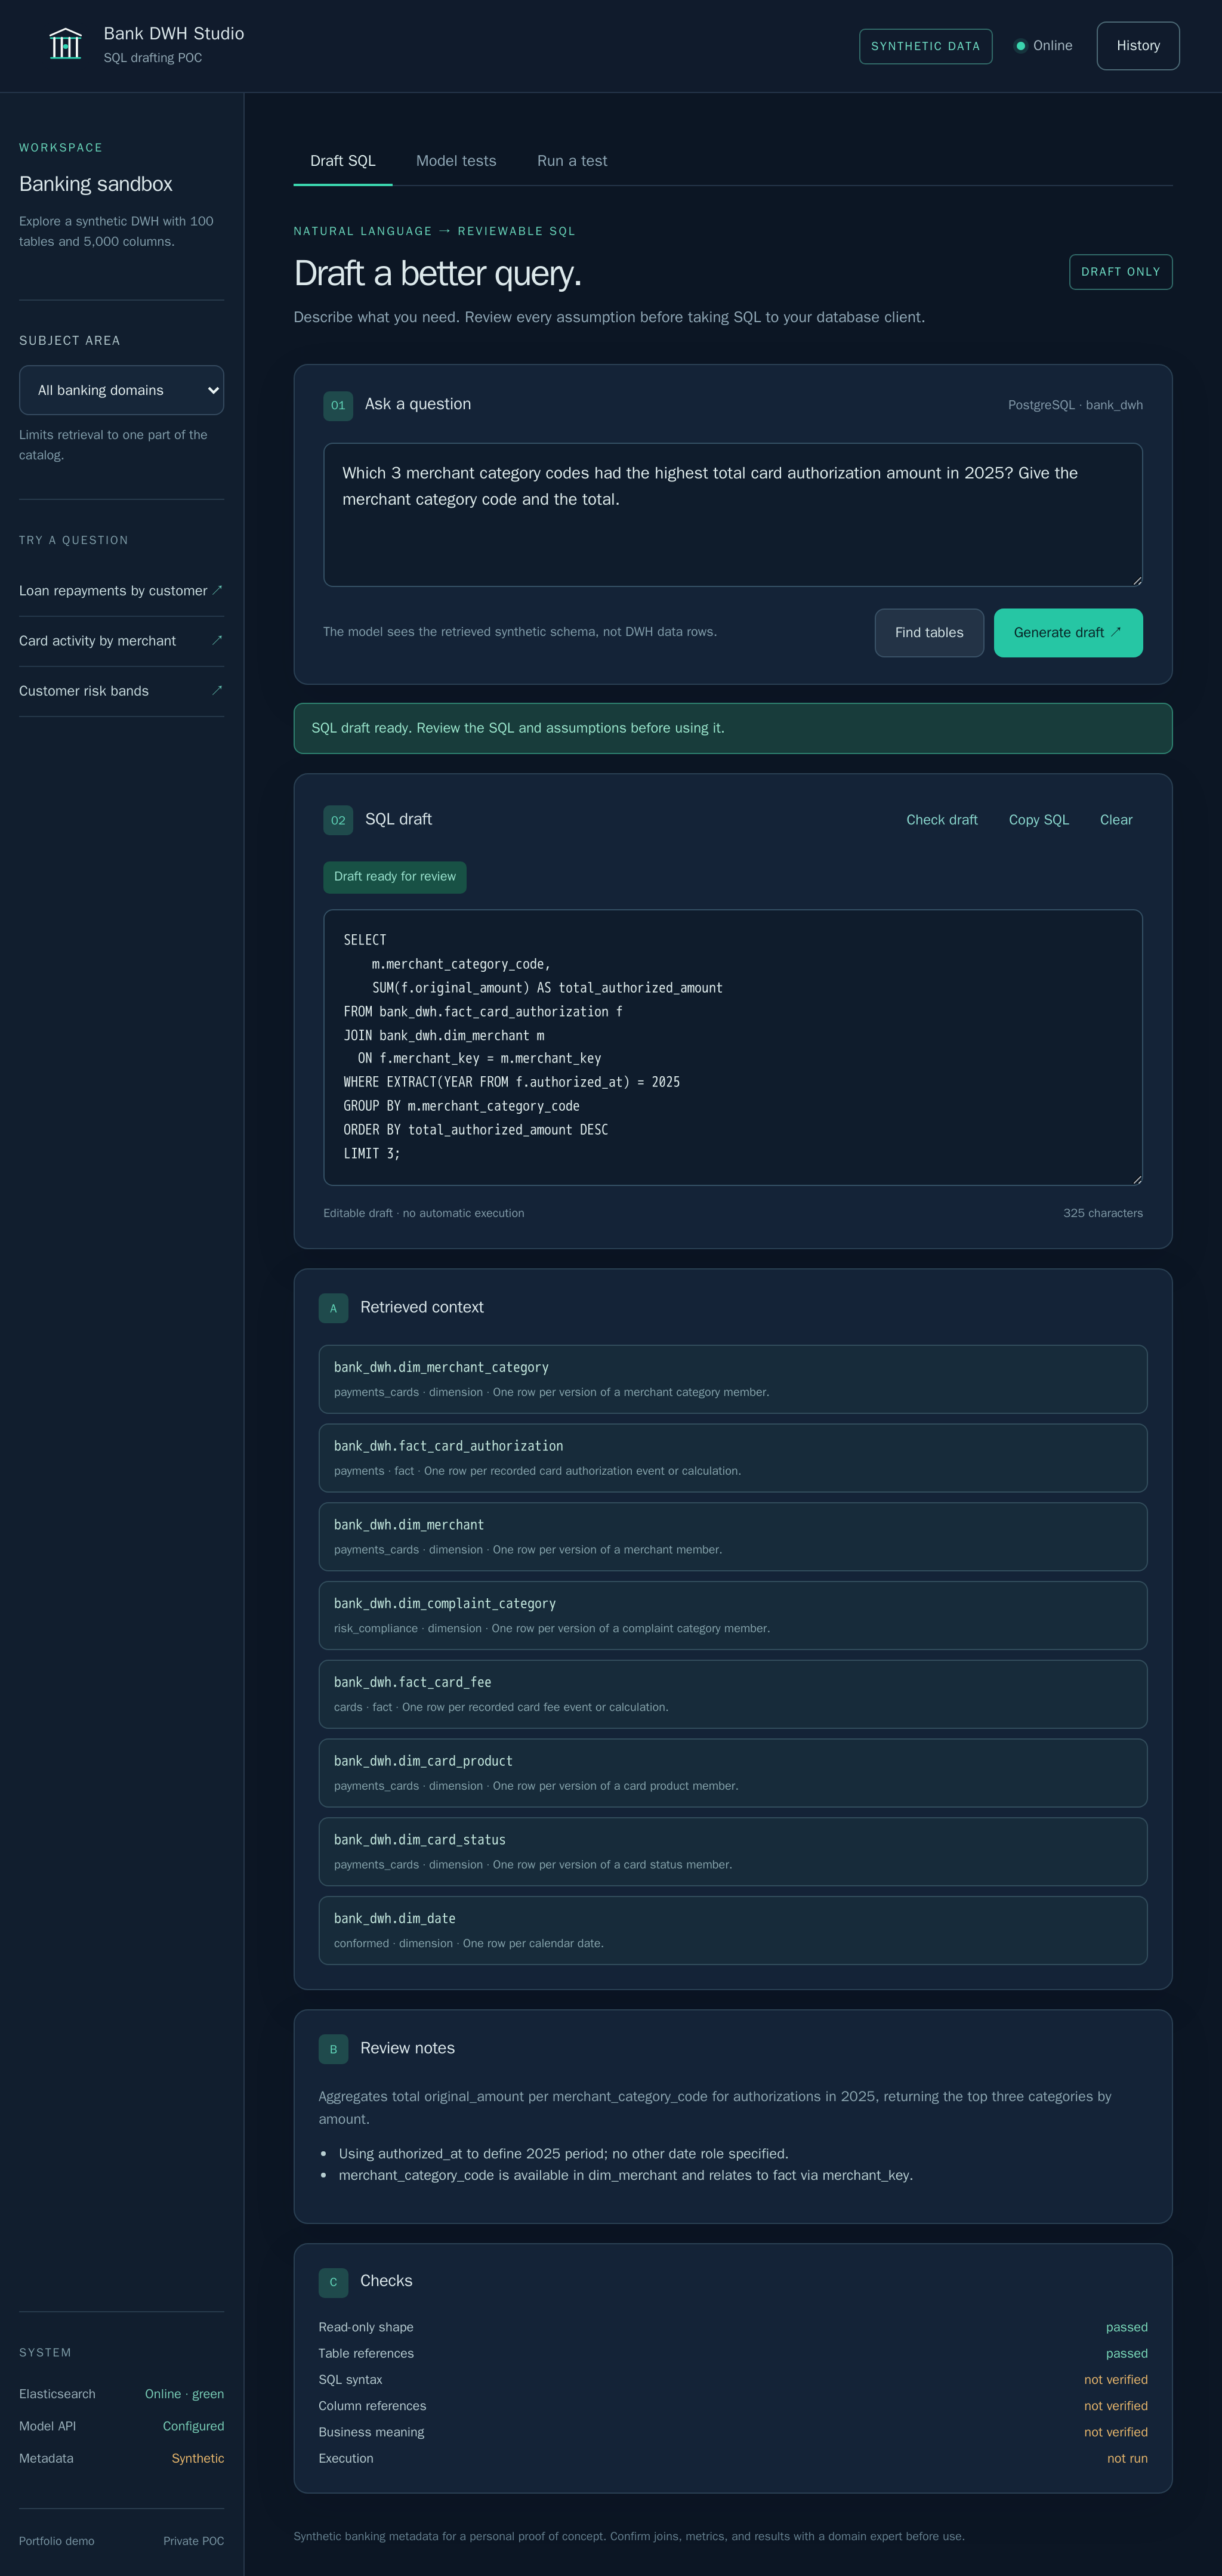
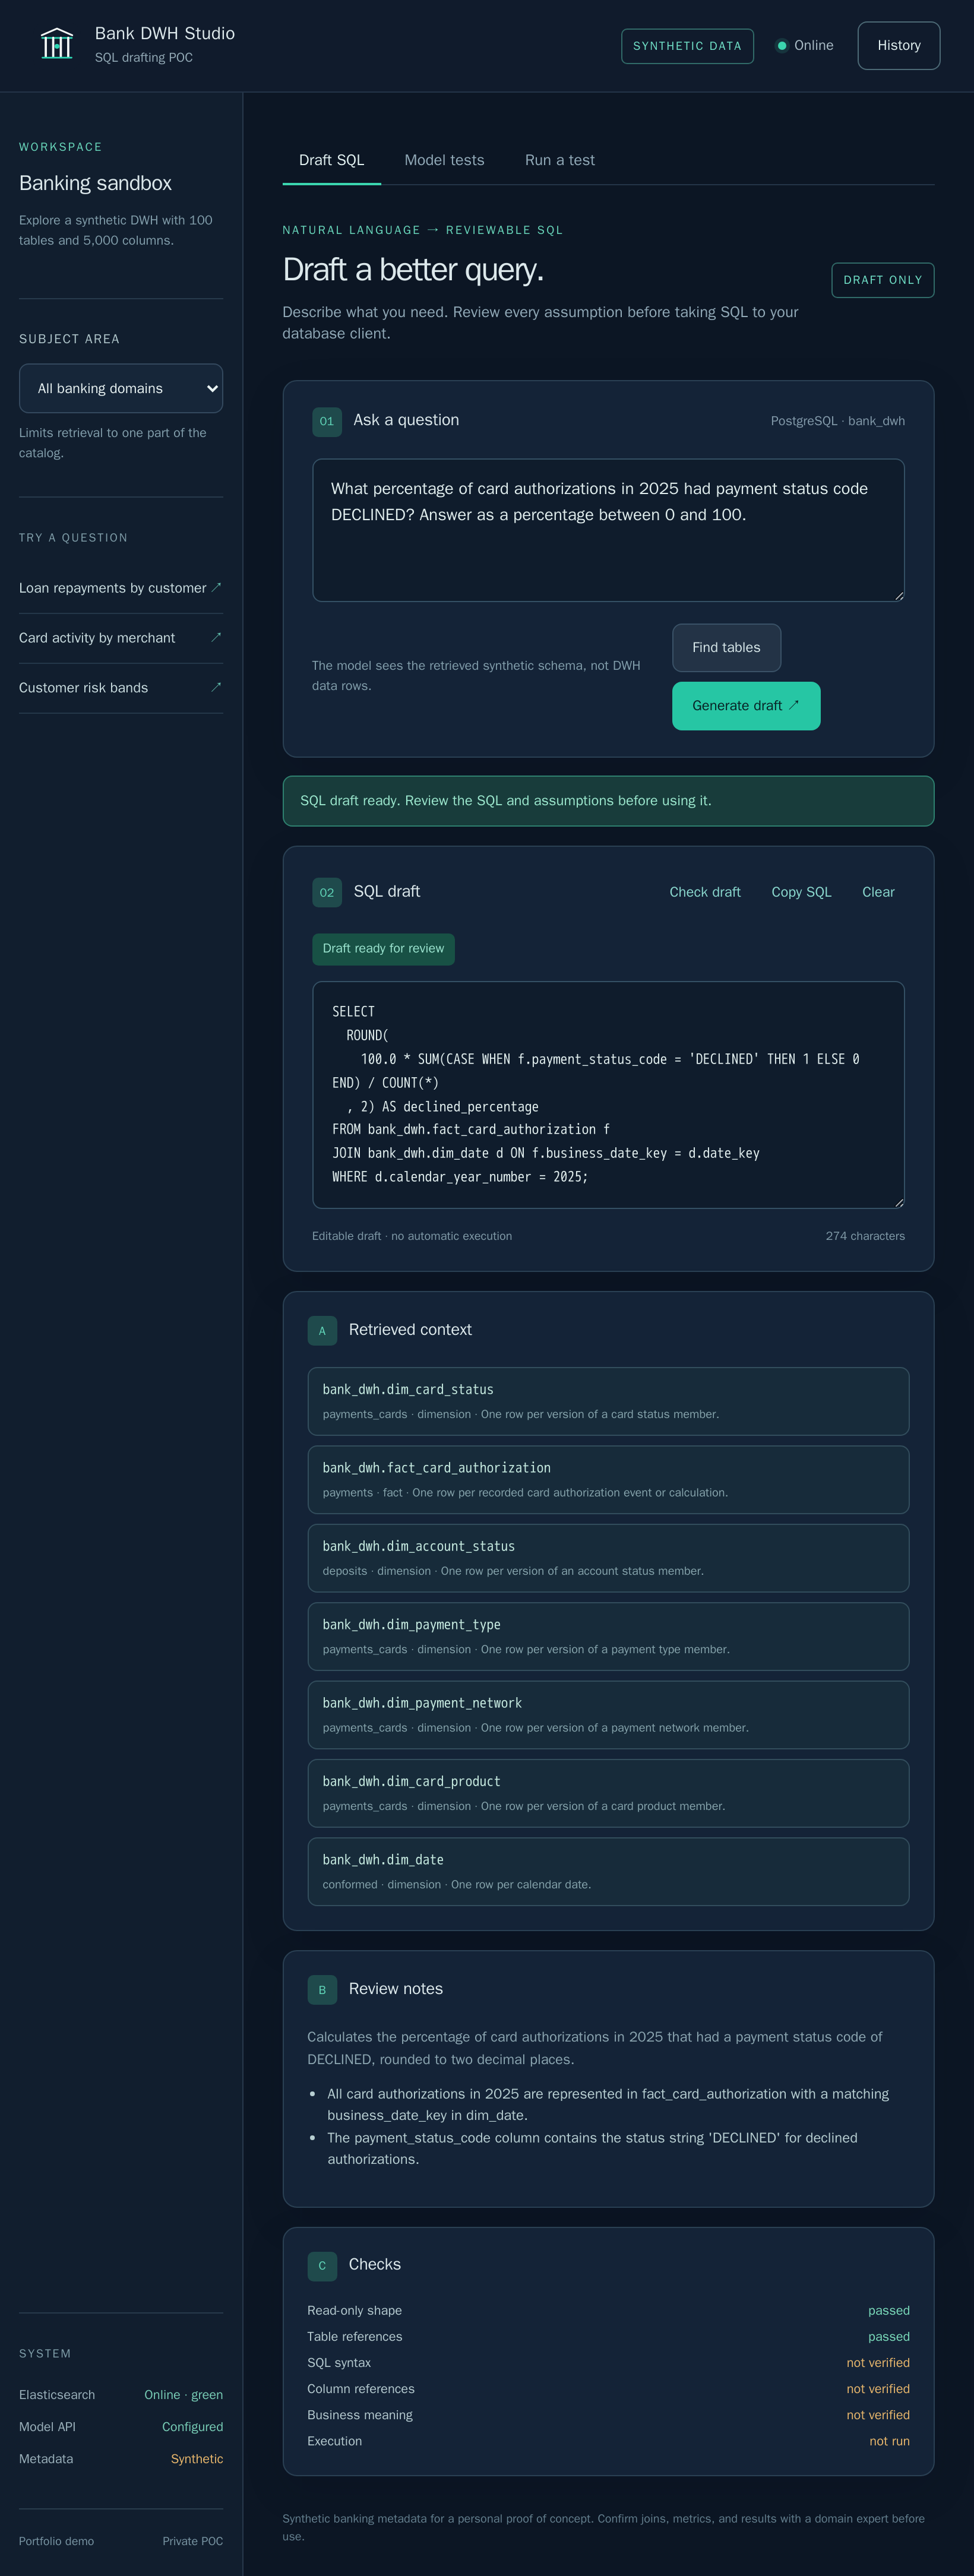
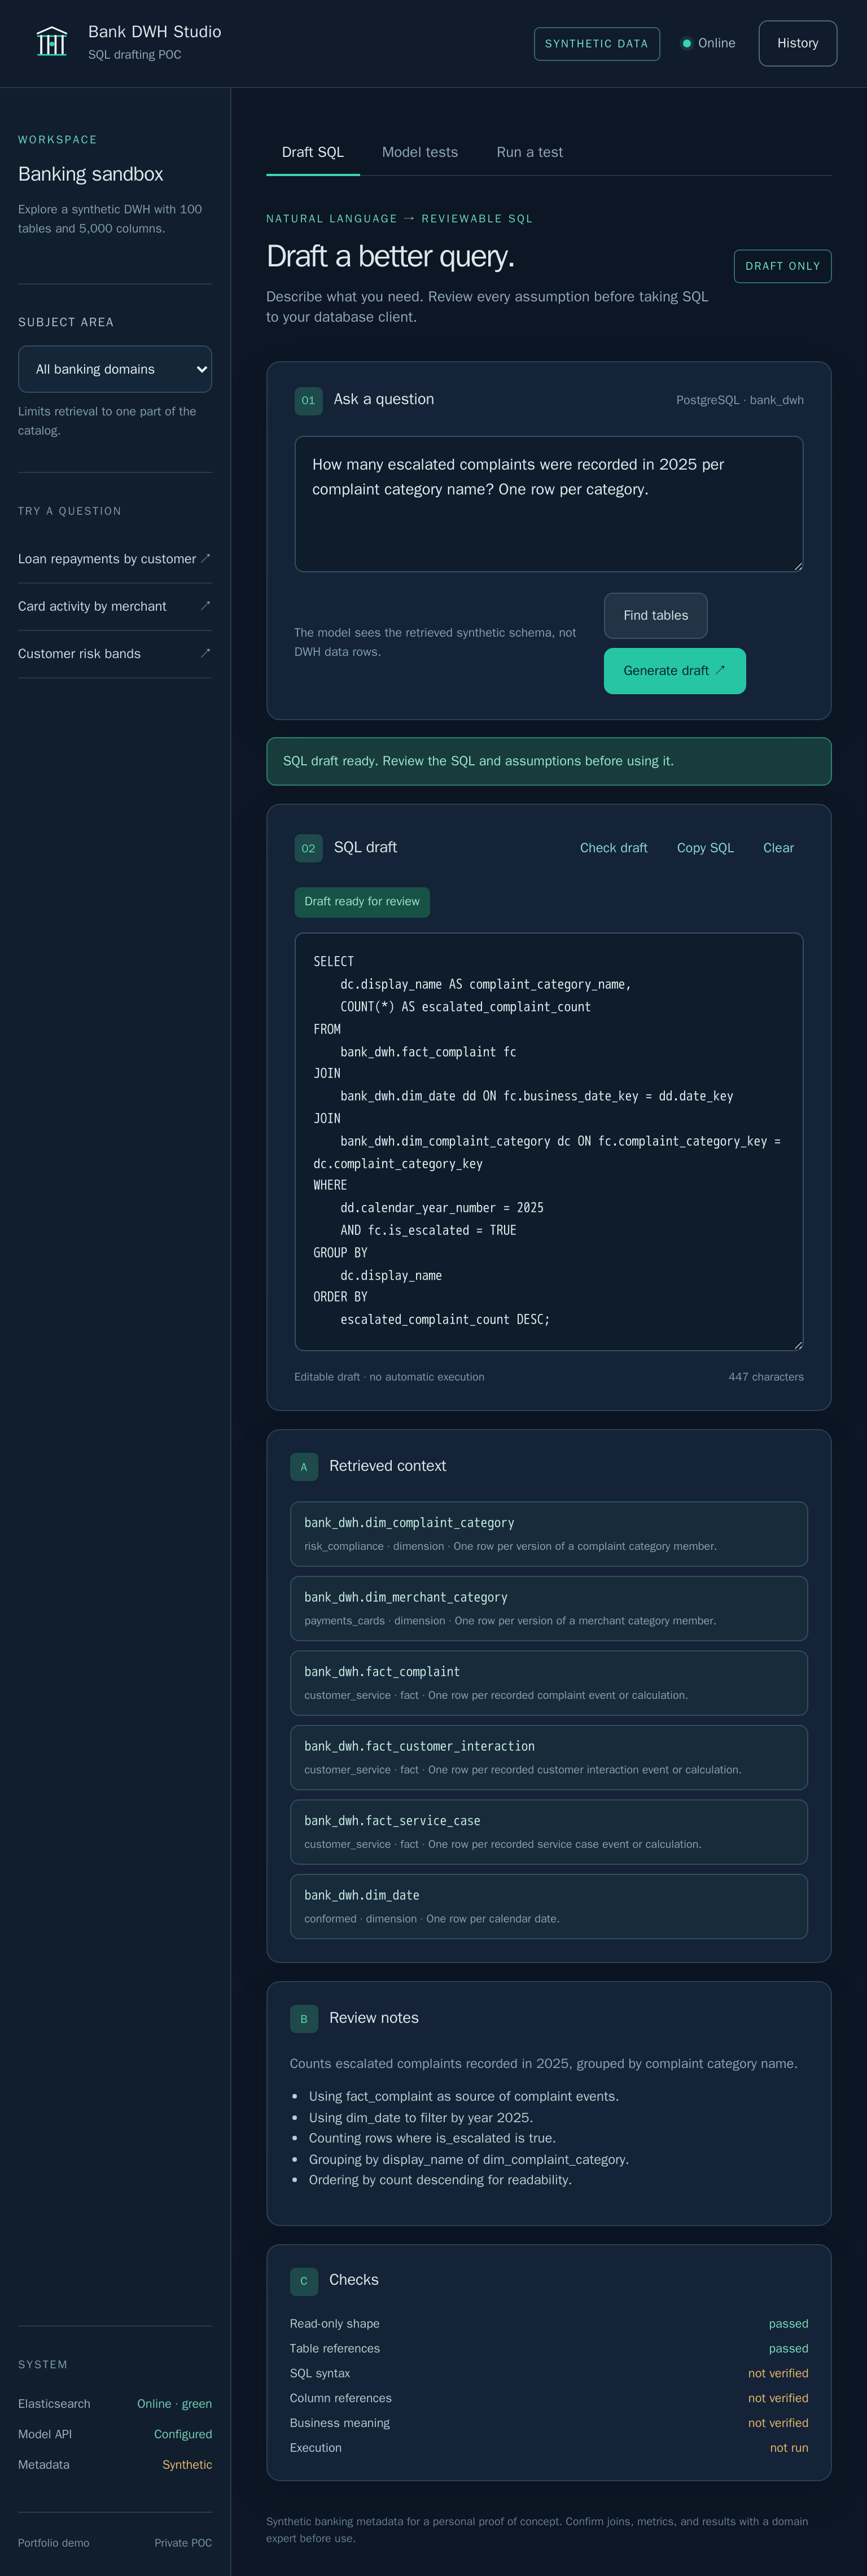
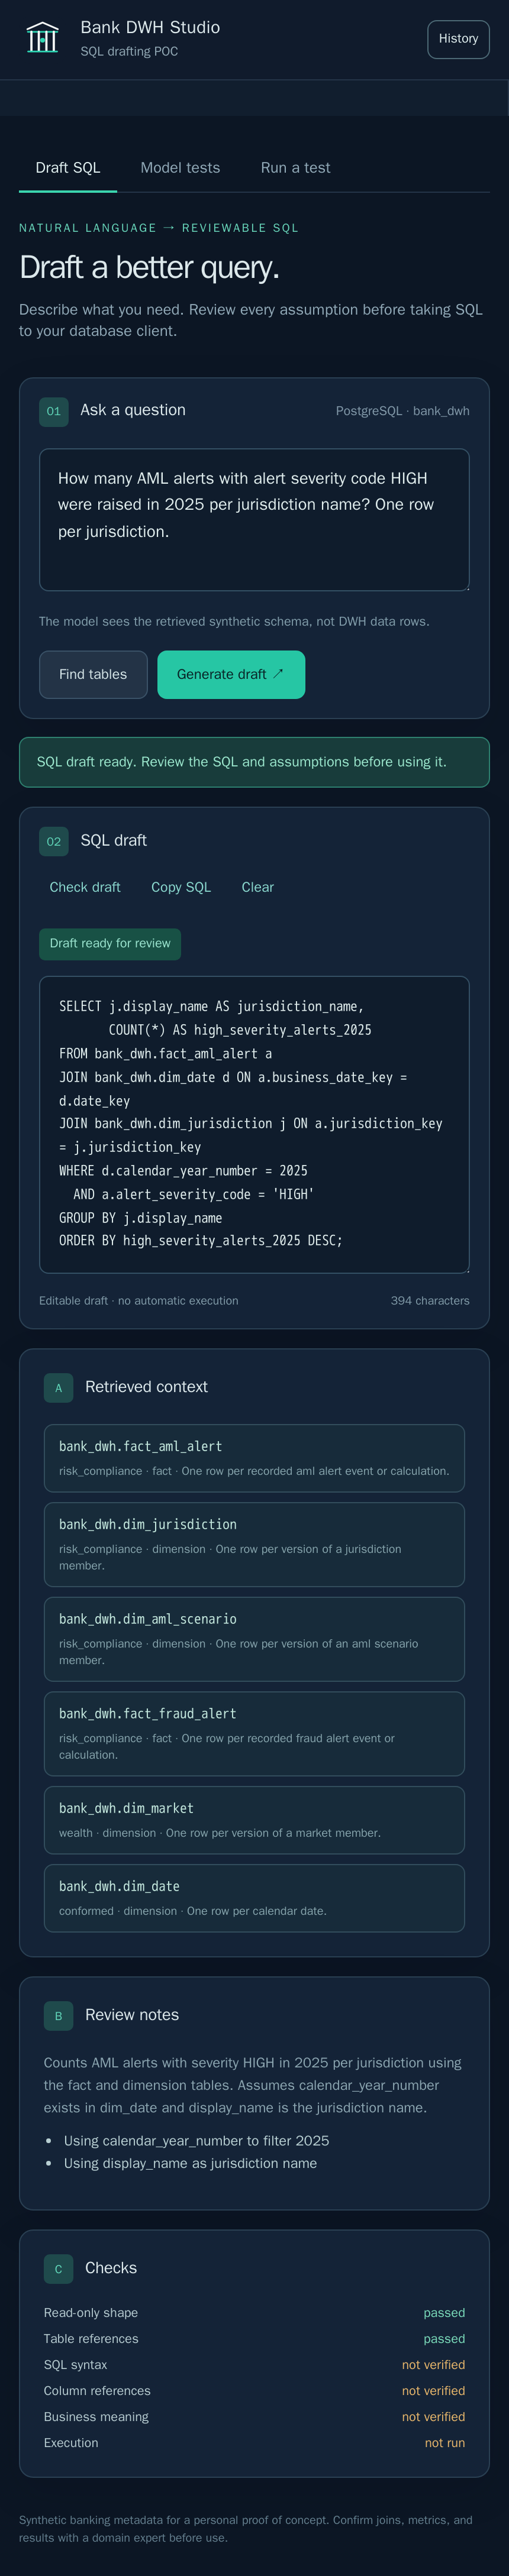
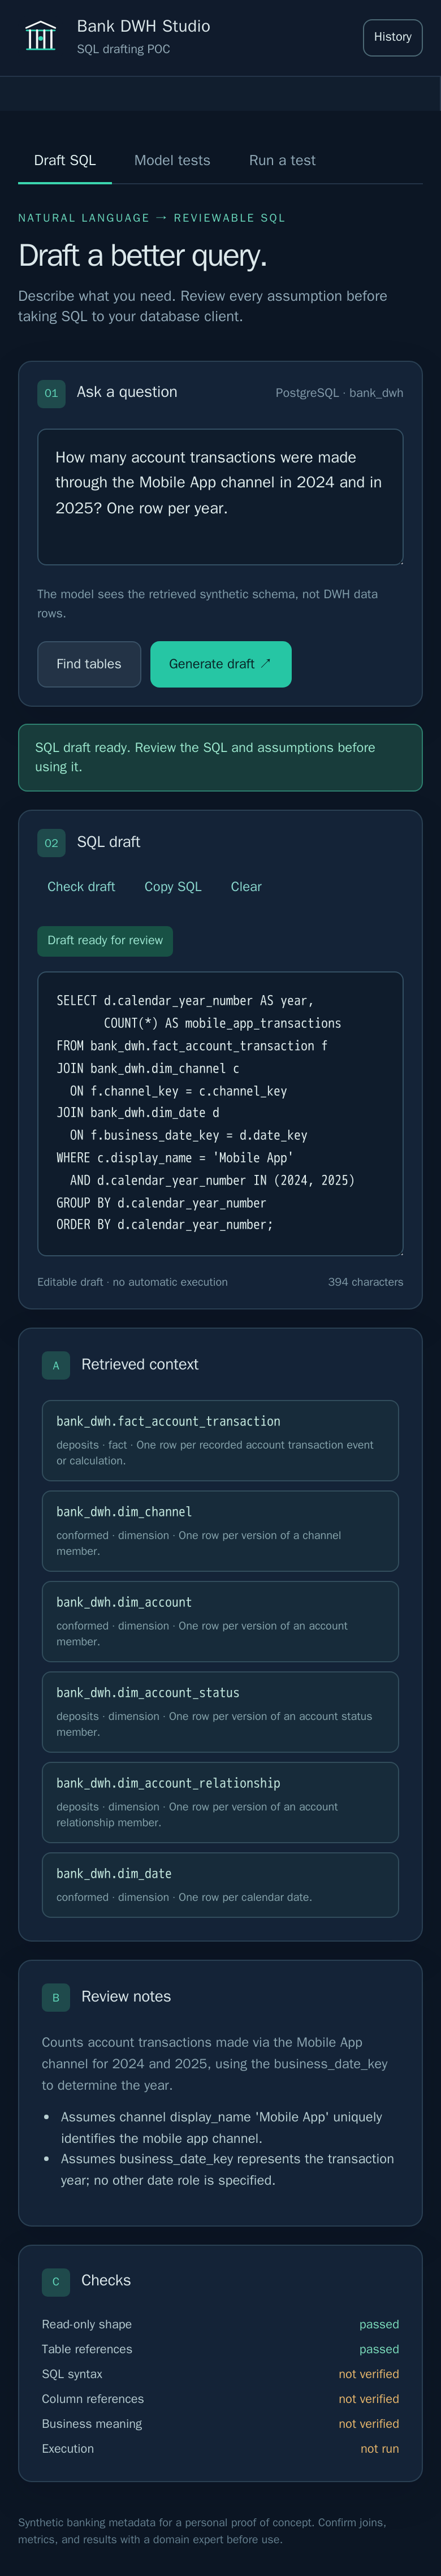
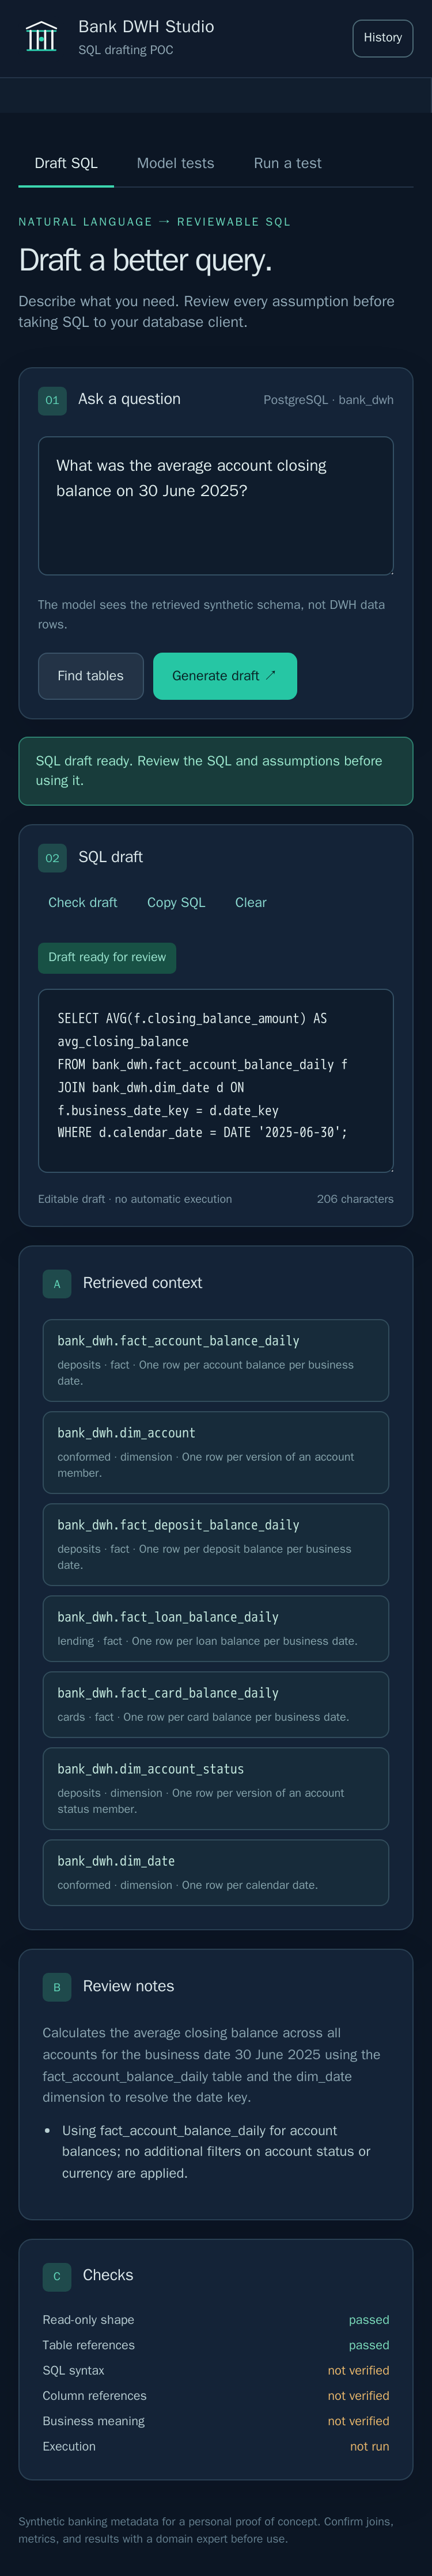
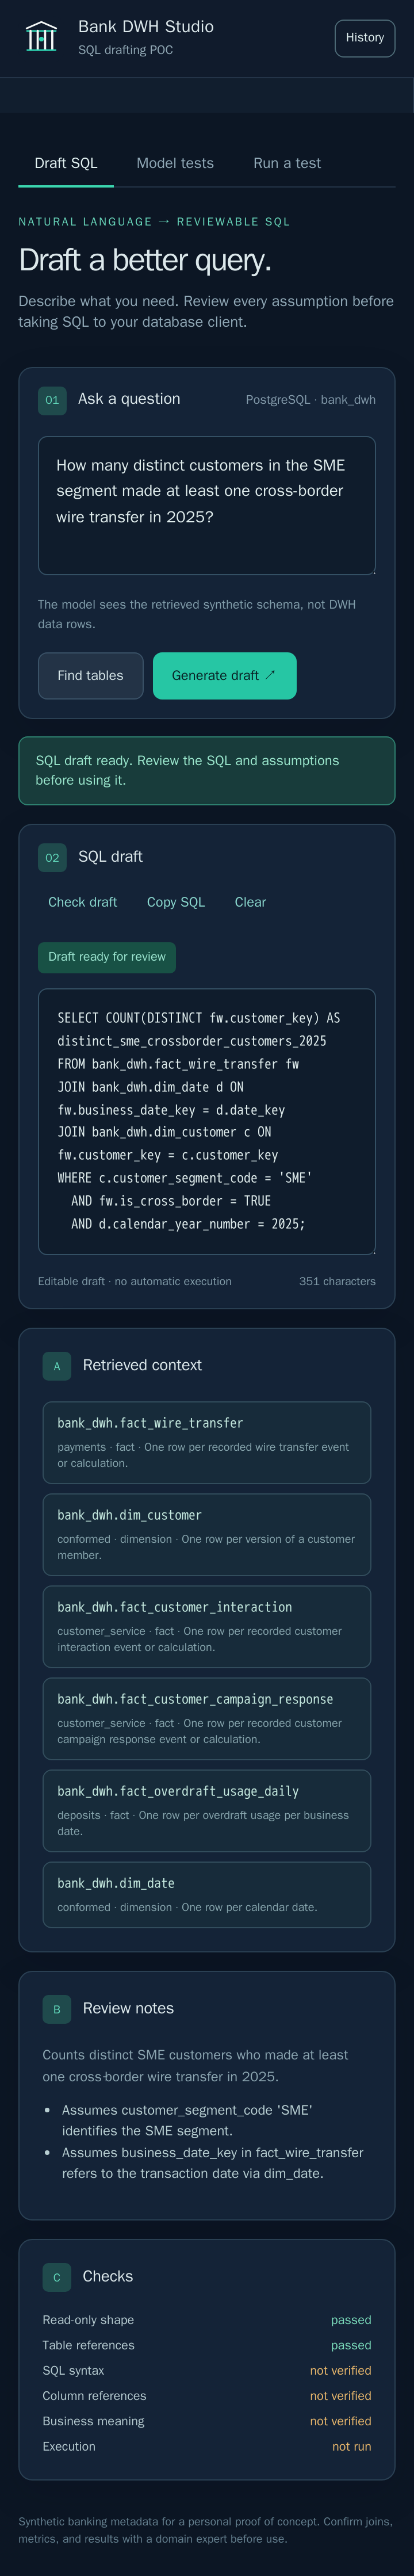
应用会编写并测试 SQL 草稿,但只在数据仓库的合成副本上进行,且以只能读取的用户身份运行;它从不连接真实的银行数据仓库。用户仍需审核结果,再编辑或复制,并在自己的数据库客户端中运行。浏览器永远不会收到模型的 API 密钥。
自动检查仅涵盖只读语句的基本形态和已知表引用。SQL 语法、字段引用和业务含义仍须人工审查。仓库中的所有名称、关系和指标都是合成测试材料,并非获批准的银行业务定义。
已部署的概念验证在 Oracle Ampere A1 实例上以无 root 权限容器运行 Node 后端、Elasticsearch 和只读的 PostgreSQL 数据仓库,并通过托管服务商使用 gpt-oss-20b 编写 SQL。代码库还记录了一个更宏大的未来架构,与已部署的小型 POC 明确分开。